AI til PDF-sammenfatning udtrækker eller læser PDF-indhold og omdanner det til kortere sammenfatninger, hovedpunkter, noter og kildehenviste svar. Den bedste arbejdsgang håndterer PDF'er med tekstlag, scannede PDF'er, OCR-kvalitet, sidereferencer, privatliv og genbrug, så rapporter, artikler, manualer og dokumenter til mødeforberedelse bliver til viden i stedet for statiske filer.
Prøv HiNoter for at uploade tilladte PDF'er og omdanne dem til sammenfatninger, noter, hovedpunkter, mødeforberedelse og kildehenvist AI Chat.
Hvad er AI til PDF-sammenfatning?
AI til PDF-sammenfatning er software, der læser indholdet i en PDF og opretter en kortere version af de vigtigste oplysninger. Den kan sammenfatte rapporter, forskningsartikler, eksporterede slides, manualer, undervisningsnoter, interne politikker, kontrakter, mødemateriale og andre dokumenter. Et grundlæggende værktøj opretter en kort sammenfatning. En stærkere arbejdsgang opretter sektionssammenfatninger, hovedpunkter, studienoter, mødeforberedelse, spørgsmål og kildebaseret chat.
Den vigtige forskel er, at en PDF er en beholder og ikke altid ren tekst. Nogle PDF'er indeholder et normalt tekstlag. Andre er scannede billeder af sider. Nogle kombinerer tekst, billeder, tabeller, fodnoter, spalter, annotationer og diagrammer. Før AI kan sammenfatte en PDF nøjagtigt, skal værktøjet udtrække brugbart indhold og bevare tilstrækkelig kildekontekst til gennemgang.
HiNoter er nyttig, når målet er PDF-til-viden. Den kan hjælpe med at udtrække eller bruge PDF-indhold, sammenfatte sektioner, identificere hovedpunkter, oprette research- eller mødenoter og lade brugere stille kildehenviste spørgsmål om dokumentet.
Definitioner: OCR, PDF-til-tekst, PDF-sammenfatning og kildebaseret PDF-chat
OCR står for optisk tegngenkendelse. OCR genkender tekst i billeder eller scannede sider og omdanner den til maskinlæsbar tekst. Ved PDF-sammenfatning er OCR ofte forbindelsen mellem et dokument, der kun består af billeder, og en tekstkilde, der er klar til sammenfatning.
PDF-til-tekst indebærer at udtrække tekst fra en PDF. Hvis PDF'en allerede har et tekstlag, kan udtrækningen være forholdsvis direkte. Hvis PDF'en er scannet, afhænger udtrækningen ofte af OCR. Uanset hvad kan den udtrukne tekst stadig kræve oprydning, når der indgår spalter, tabeller, fodnoter, sidehoveder og figurer.
PDF-sammenfatning indebærer at omdanne udtrukket PDF-indhold til en kortere forklaring af det vigtige. Den kan skabe en ledelsesresumé, sektionssammenfatning, brief med punktform, studieguide, note til mødeforberedelse eller en liste over risici, resultater og handlingspunkter.
Kildebaseret PDF-chat indebærer at stille spørgsmål om en PDF og modtage svar, der er knyttet til kildesider, sektioner eller uddrag. Det hjælper brugere med at verificere påstande i stedet for at stole på et generisk AI-svar, der ikke er knyttet til dokumentet.
PDF'er med tekstlag kontra scannede PDF'er
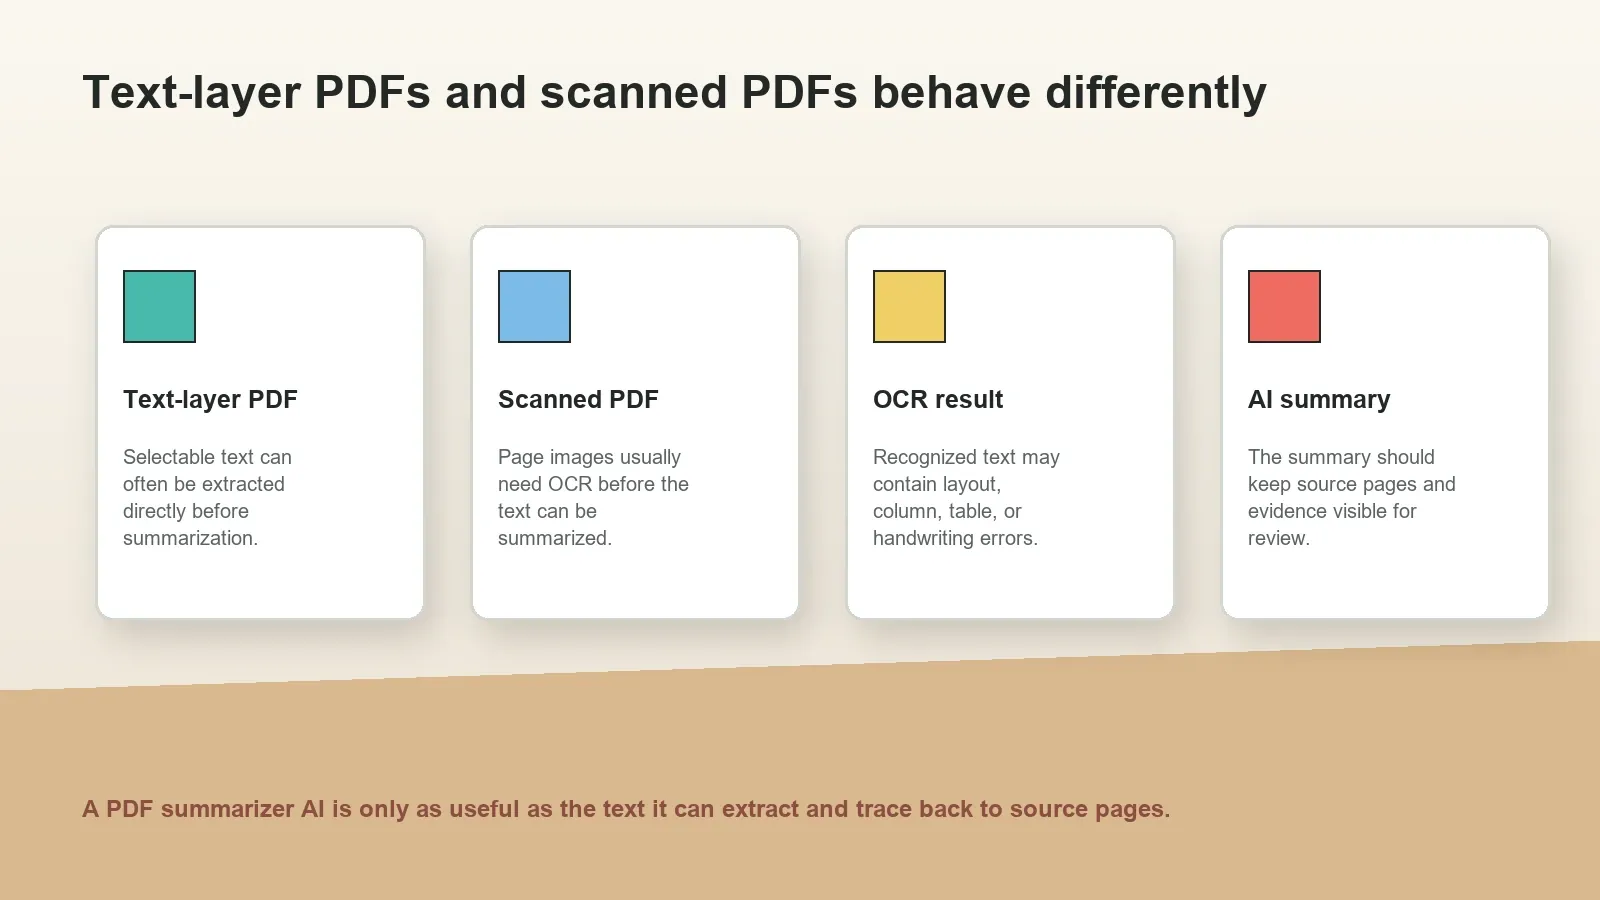
PDF'er med tekstlag og scannede PDF'er fungerer forskelligt. En PDF med tekstlag indeholder tekst, der kan markeres. Du kan ofte kopiere ord fra den, søge i den eller udtrække teksten programmatisk. En scannet PDF er normalt et sæt sidebilleder. Den kan se læsbar ud for et menneske, men et værktøj kan have brug for OCR, før det kan søge efter eller sammenfatte ordene.
Adobes Acrobat-dokumentation beskriver OCR som en måde at genkende tekst i scannede dokumenter på, så den resulterende PDF bliver søgbar og redigerbar. Det er den praktiske grund til, at OCR er vigtig for AI-sammenfatning: Hvis ordene ikke er maskinlæsbare, har AI muligvis ikke pålidelig tekst at sammenfatte.
| PDF-type | Sådan fungerer den | Bedste arbejdsgang | Almindelig begrænsning |
|---|---|---|---|
| PDF med tekstlag | Tekst kan ofte markeres, søges i og udtrækkes | Udtræk tekst, bevar sidereferencer, sammenfat efter sektion | Tabeller, spalter, fodnoter og figurer kan stadig blive udtrukket dårligt |
| Scannet PDF | Siderne er billedlignende og indeholder muligvis ikke tekst, der kan markeres | Kør OCR, gennemgå den genkendte tekst, og sammenfat derefter | OCR kan fejllæse scanninger af lav kvalitet, håndskrift, stempler og layout |
| Blandet PDF | Nogle sider har tekst, mens andre er scanninger eller billeder | Udtræk tekst, hvor det er muligt, og brug OCR på billedsider | Ensartethed på tværs af sider og kildehenvisninger kræver ekstra gennemgang |
| Kompleks PDF | Kan indeholde diagrammer, tabeller, spalter, formularer, figurer og annotationer | Sammenfat sektioner, og gennemgå vigtige beviser manuelt | Visuelle data og tabelstruktur overlever muligvis ikke udtrækningen rent |
Sådan sammenfatter du en PDF med AI
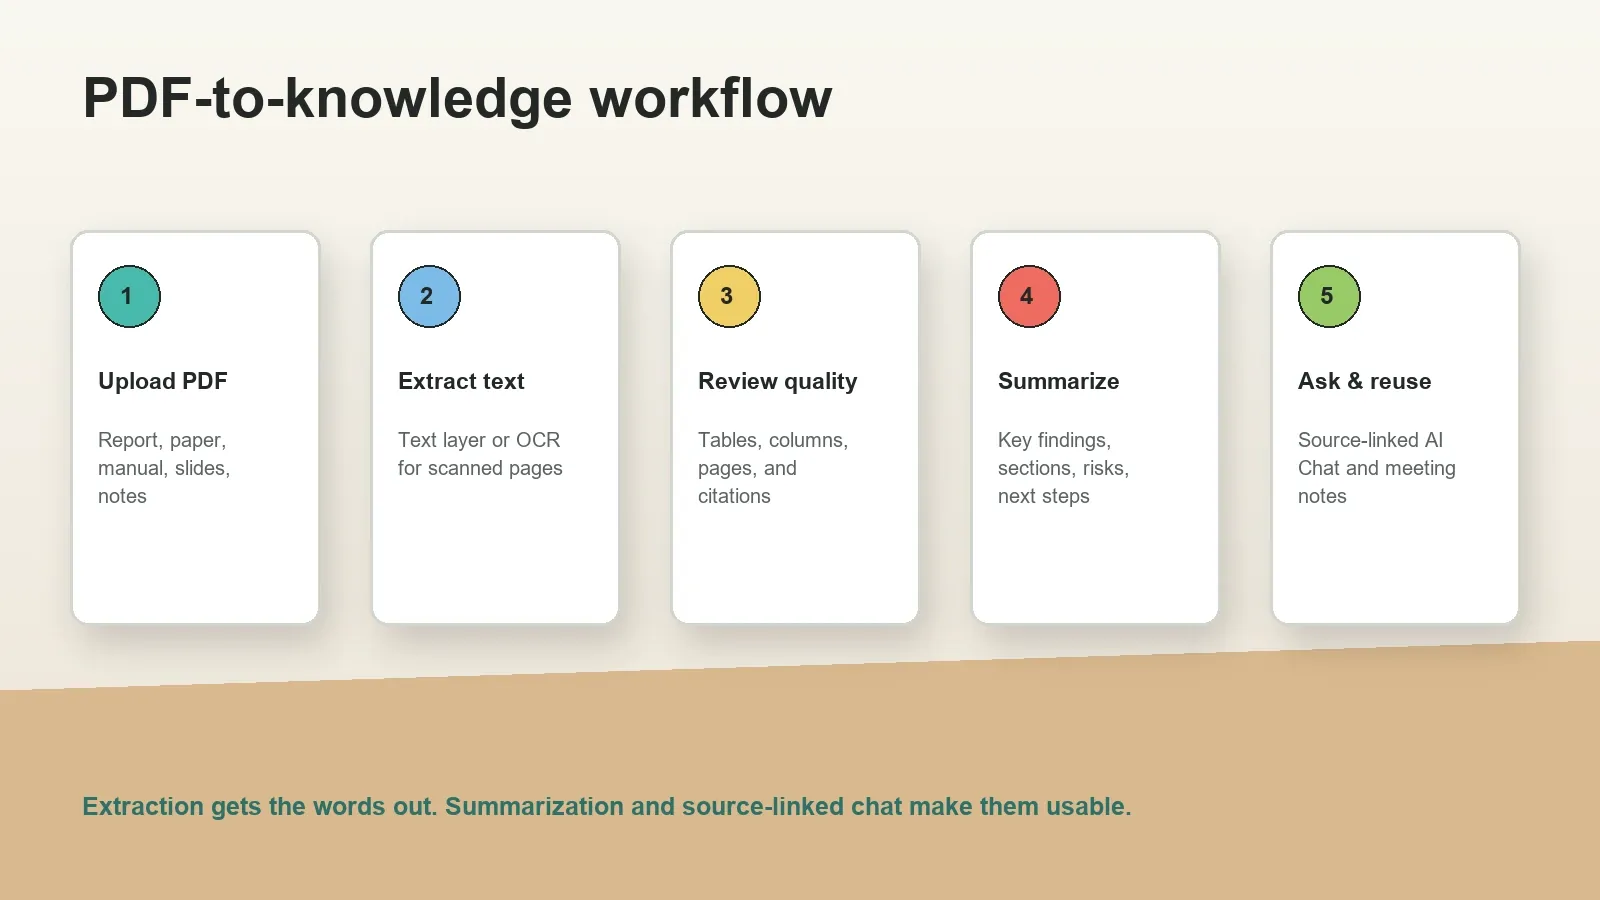
- Bekræft tilladelsen. Brug kun PDF'er, som dit team har tilladelse til at uploade, behandle, sammenfatte, eksportere eller stille spørgsmål om. Rapporter, artikler, kontrakter, manualer og interne dokumenter kan være følsomme.
- Identificer PDF-typen. Kontrollér, om PDF'en har tekst, der kan markeres, eller sider med scannede billeder. Det afgør, om det første trin er tekstudtrækning eller OCR.
- Udtræk eller genkend teksten. Brug tekstlaget, når det er tilgængeligt. Brug OCR til scannede sider eller PDF'er, der kun består af billeder. Bevar sidetal, overskrifter og sektionsrækkefølge, når det er muligt.
- Gennemgå kvaliteten af udtrækningen. Kontrollér siderækkefølge, spalter, tabeller, ligninger, fodnoter, diagrammer, kildehenvisninger, sidehoveder, håndskrift og roterede sider. Ret tydelige problemer, før du stoler på sammenfatningen.
- Generér sammenfatningen. Opret et ledelsesresumé, sektionssammenfatninger, vigtige resultater, risici, definitioner, forskningsnoter eller en kort briefing til mødeforberedelse afhængigt af læserens mål.
- Stil kildehenviste spørgsmål. Brug AI Chat til at spørge om dokumentation, anbefalinger, definitioner, modsigelser og næste handlinger. Sørg for, at side- eller sektionshenvisninger er synlige.
- Eksportér ansvarligt. Del kun den sammenfatning, de noter eller de svar, som dine tilladelser giver mulighed for. Anvend adgangskontroller på sammenfatninger og AI Chat, ligesom du ville gøre på den oprindelige PDF.
Almindelige tilfælde af fejl ved PDF-udtrækning
Mange brugere forventer, at AI til PDF-sammenfatning fungerer som en normal tekstsammenfatter. Det fungerer kun, når dokumentet er tilstrækkeligt rent. PDF'er kan være visuelt læsbare, mens de stadig er vanskelige for software at analysere. Et værktøj kan læse spalter i den forkerte rækkefølge, udelade tabeloverskrifter, ignorere fodnoter, flette sidehoveder ind i brødteksten eller overse tekst i billeder.
Scannede PDF'er introducerer endnu et risikolag. OCR-kvaliteten afhænger af scannerens opløsning, kontrast, siderotation, billedstøj, sprog, skrifttyper, håndskrift, stempler, og om siden har et komplekst layout. Selv et godt OCR-resultat kan læse tal, juridiske henvisninger, videnskabelige symboler eller produktnavne forkert.
| Fejltilfælde | Hvad kan gå galt | Sådan reduceres risikoen |
|---|---|---|
| Layout med to kolonner | Afsnit kan blive læst i forkert rækkefølge | Gennemgå afsnitsrækkefølgen, før du opsummerer forskningsartikler |
| Tabeller | Overskrifter og celler kan miste deres sammenhæng | Kontrollér tal, rækker og kolonner i forhold til PDF'en |
| Scannede sider | OCR kan læse ord, navne eller symboler forkert | Brug tydelige scanninger, og gennemgå kritiske afsnit manuelt |
| Diagrammer og figurer | Visuelle data bliver muligvis ikke automatisk til tekst | Tilføj noter, eller gennemgå figurer, når konklusionerne afhænger af visuelle elementer |
| Fodnoter og citater | Referencer kan blive adskilt fra påstande | Sørg for, at sidereferencer og citatkontekst forbliver synlige |
| Formularer og kontrakter | Afkrydsningsfelter, felter og klausuler kan blive udtrukket inkonsekvent | Gennemgå juridiske eller operationelle dokumenter, før du deler opsummeringer |
Sådan omdanner HiNoter PDF'er til genanvendelig viden
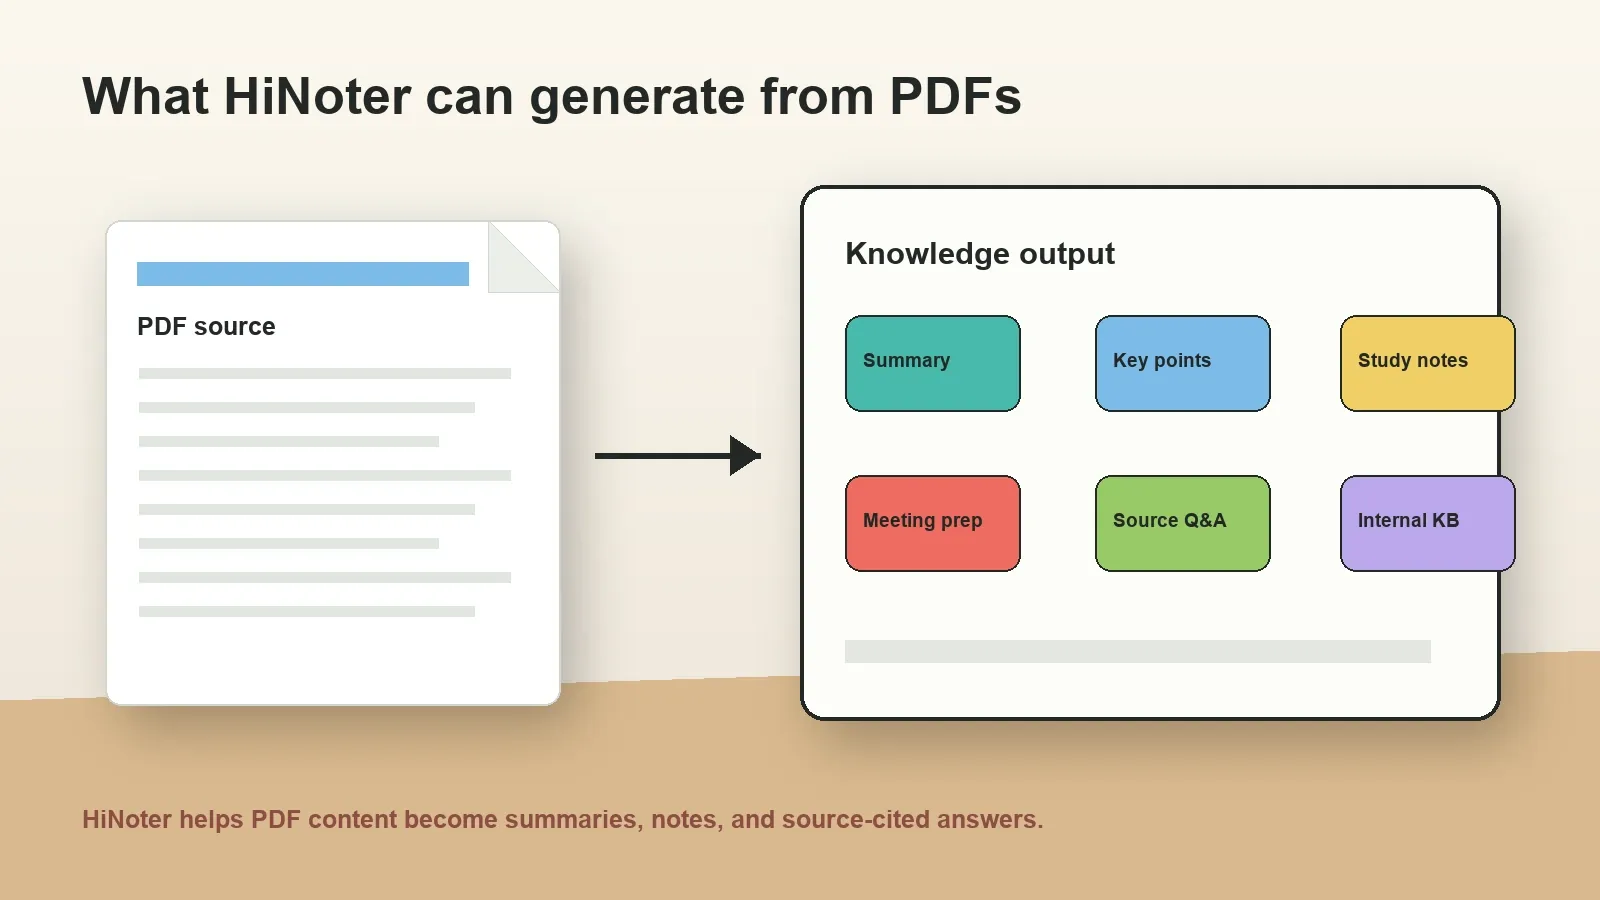
HiNoter bør bruges som et workflow fra PDF til viden, ikke kun som en PDF-konverter. Det første lag er indholdsudtræk: tekst fra PDF'en eller OCR, hvor dokumentet kræver det. Det andet lag er forståelse: opsummeringer, nøglepunkter, afsnitsnoter, åbne spørgsmål, studienoter og mødeforberedelse. Det tredje lag er genfinding: kildehenvist AI Chat, der hjælper brugeren med at stille spørgsmål og spore svarene tilbage til dokumentet.
For en forskningsartikel kan HiNoter hjælpe med at identificere forskningsspørgsmålet, metoder, resultater, begrænsninger, definitioner, citater og åbne spørgsmål. For en rapport kan den udarbejde et resumé til ledelsen, risici, anbefalinger, målepunkter og spørgsmål fra interessenter. For en mødepakke kan den omdanne et statisk dokument til en forberedelsesbrief med beslutninger, der skal træffes, spørgsmål, der skal stilles, og opfølgende handlinger.
Dette hænger naturligt sammen med HiNoters bredere workflow. Teams kan kombinere AI-mødenoter, lyd til tekst, videonoter og PDF'er i én kildebevidst vidensproces. I stedet for at sprede indsigter på tværs af filer og private noter kan brugere stille spørgsmål på tværs af kilder og kontrollere, hvor hvert svar stammer fra.
Anvendelsesområder: rapporter, forskning, mødeforberedelse, klassenoter og intern viden
Rapporter indeholder ofte resultater, diagrammer, anbefalinger og risikoafsnit, som travle teams ikke har tid til at læse i deres fulde længde. AI til PDF-opsummering kan udarbejde et resumé til ledelsen, fremhæve de vigtigste målepunkter, identificere risici og opliste spørgsmål fra interessenter før et møde.
Forskningsartikler kræver en mere omhyggelig struktur. En god opsummering bør adskille abstract, forskningsspørgsmål, metoder, datasæt, resultater, begrænsninger og citater. Den bør ikke udvise større sikkerhed, end artiklen berettiger til. Kildehenviste spørgsmål er nyttige, fordi læserne kan spørge, hvor artiklen understøtter en påstand.
Mødeforberedelse er et af de workflows, der skaber størst værdi. I stedet for at læse en lang PDF-mødepakke få minutter før et opkald kan en bruger generere en forberedelsesbrief: hvad dokumentet siger, hvad der kræver en beslutning, hvilke spørgsmål der skal stilles, hvilke risici der er vigtige, og hvilken opfølgning der kan være nødvendig efter mødet.
Klassenoter og studiematerialer har gavn af definitioner, eksempler, studiespørgsmål, mindmap-oversigter og kildehenvist Q&A. En studerende kan bede dokumentet om at forklare et begreb, men bør stadig kontrollere kildesiderne, før svaret bruges til en opgave eller eksamen.
Genbrug af intern viden omdanner PDF'er fra statiske filer til søgbar hukommelse. Manualer, onboardingdokumenter, politikker, produktbriefs og kundeundersøgelser kan blive til opsummeringer og kildehenviste svar, der hjælper teams med at undgå at stille de samme spørgsmål igen og igen.
| Anvendelsesområde | PDF-eksempler | Nyttigt output | HiNoter-workflow |
|---|---|---|---|
| Rapporter | Markedsrapporter, kundeundersøgelser, kvartalsopdateringer | Resumé til ledelsen, risici, målepunkter, anbefalinger | Stil kildehenviste spørgsmål før strategimøder |
| Forskning | Artikler, litteraturgennemgange, tekniske studier | Metoder, resultater, begrænsninger, citatbevidste noter | Opret studienoter og evidensbaseret Q&A |
| Mødeforberedelse | Bestyrelsespakker, projektbriefs, salgsdokumenter | Beslutningsbrief, spørgsmål, handlingspunkter, risici | Omdan PDF'er til mødeforberedende noter og opfølgningsopgaver |
| Klassenoter | Forelæsnings-PDF'er, slideeksporter, læsemateriale | Definitioner, eksempler, quizspørgsmål, studieguide | Opbyg et kildehenvist studie-workflow |
| Intern viden | Manualer, politikker, onboardingdokumenter, produktspecifikationer | Søgbare opsummeringer, svar, genanvendelige noter | Forbind PDF'er med møder, lyd- og videonoter |
Eksempler på kildehenvist PDF Chat
Kildehenvist PDF Chat er nyttigt, når en bruger ikke ved, hvilken side der indeholder svaret. I stedet for at læse en hel rapport kan brugeren stille målrettede spørgsmål og gennemgå kildekonteksten, før svaret stoles på.
| Spørgsmål | Nyttigt svar | Kildehenvisning, der skal undersøges |
|---|---|---|
| Hvad er de tre største risici i denne rapport? | Prioriterede risici med korte forklaringer | Risikoafsnit og sidehenvisninger |
| Hvad bør jeg forberede før mødet? | Beslutningspunkter, spørgsmål og nødvendig kontekst | Resumé, anbefalinger, bilag |
| Hvilke beviser understøtter hovedfundet? | Vigtige datapunkter, eksempler eller citerede påstande | Tabeller, metoder, resultatsider, citater |
| Hvad er ændret siden den sidste version? | Resumé af opdaterede antagelser eller anbefalinger | Revisionsnoter, ændrede afsnit, kildesider |
| Udarbejd en opfølgningsnote ud fra denne PDF. | Kort opsummering, beslutninger, der skal træffes, og næste skridt | Afsnit, der understøtter hver opgave eller påstand |
Skabelon til et PDF-resumé, der kan kopieres
Et nyttigt PDF-resumé bør være struktureret nok til at kunne deles, men ikke så komprimeret, at læseren mister konteksten. For rapporter, forskning, politikker, manualer og mødemateriale er den bedste skabelon normalt ikke et enkelt afsnit. Det er en lagdelt briefing, der lader en travl læser se svaret først og derefter undersøge detaljer og kilder efter behov.
Brug denne skabelon, når du opsummerer en PDF med AI. Den holder resuméet praktisk til mødeforberedelse, teamopdateringer, forskningsgennemgang og genbrug af intern viden.
| Afsnit | Hvad skal med | Hvorfor det er vigtigt |
|---|---|---|
| Svar i én linje | Hovedbudskabet i én sætning | Hjælper læserne med at afgøre, om de skal læse videre |
| Resumé | Fem til otte punkter, der dækker de vigtigste emner | Forvandler en lang PDF til en briefing, der hurtigt kan deles |
| Vigtig dokumentation | Påstande, målinger, eksempler, sidehenvisninger eller citerede afsnit | Gør det muligt for læserne at kontrollere vigtige udsagn i forhold til kilden |
| Risici og begrænsninger | Uklare antagelser, manglende data, svag dokumentation eller operationel risiko | Forhindrer, at resuméet lyder mere sikkert, end PDF'en er |
| Spørgsmål, der skal stilles | Åbne spørgsmål til et møde, en gennemgang, en undervisning eller en drøftelse med interessenter | Flytter PDF'en fra passiv læsning til aktiv beslutningstagning |
| Næste skridt | Opgaver, ansvarlige, deadlines eller opfølgningsdokumenter, når de er tilgængelige | Forbinder dokumentforståelse med konkrete resultater i arbejdsgangen |
I HiNoter kan denne skabelon blive til en gentagelig arbejdsgang. En bruger kan uploade en tilladt PDF, generere et kort resumé, bede om den dokumentation, der understøtter hvert punkt, og derefter eksportere briefingen til det arbejdsområde, hvor teamet allerede arbejder. Resuméet kan også kombineres med mødenoter, så en PDF, der læses på forhånd, og mødediskussionen forbliver forbundet i stedet for at blive separate filer.
Prompter til mødeforberedelse med AI til PDF-resuméer
AI til PDF-resuméer er særligt værdifuld før møder, fordi den omdanner omfattende forberedelsesmateriale til en diskussionsplan. Målet er ikke at erstatte læsning i forbindelse med arbejde med store konsekvenser. Målet er at identificere de afsnit, der fortjener opmærksomhed, de spørgsmål, der kræver svar, og de beslutninger, der ikke kan udskydes.
Prøv prompter som disse, når du bruger HiNoter eller en anden kildebevidst arbejdsgang til mødeforberedelse:
- Opsummér denne PDF til et 15-minutters møde med interessenter, og angiv de beslutninger, vi skal træffe.
- Uddrag de risici, uafklarede spørgsmål og antagelser, der bør drøftes live.
- Omskriv denne rapport til et briefingnotat for en leder, der ikke har læst hele dokumentet.
- Angiv de påstande, der kræver kildeverificering, og vis side- eller afsnitshenvisningen for hver af dem.
- Opret en opfølgningsplan ud fra denne PDF med opgaver, mulige ansvarlige og afhængigheder.
- Sammenlign anbefalingerne i denne PDF med mødenoterne fra vores seneste drøftelse.
Disse prompter fungerer, fordi de beder om et resultat og ikke kun om en kortere version af dokumentet. Et generisk resumé fortæller, hvad PDF'en indeholder. Et resumé til mødeforberedelse fortæller, hvad læseren bør forstå, spørge om, beslutte eller gøre som det næste.
Sådan evaluerer du kildehenviste PDF Chat-svar
Kildehenvisninger gør ikke automatisk et AI-svar korrekt, men de gør svaret lettere at kontrollere. Brugeren bør kunne undersøge, hvor svaret stammer fra, om den citerede side understøtter påstanden, og om modellen har udeladt vigtig kontekst. Dette er især vigtigt for forskningsartikler, kontrakter, finansielle rapporter, tekniske manualer og PDF-filer med politikker.
| Kontrolpunkt | Godt tegn | Advarselstegn |
|---|---|---|
| Kildedækning | Svaret henviser til det relevante afsnit, den relevante side, tabel eller det relevante bilag | Svaret er sikkert, men peger ikke på et sted i kilden |
| Påstandens styrke | Svaret bruger forsigtigt sprog, når PDF'en er usikker | Svaret omdanner svag dokumentation til en stærk anbefaling |
| Tal og navne | Målinger, datoer, navne og definitioner stemmer overens med PDF'en | OCR- eller udtræksfejl ændrer vigtige detaljer |
| Kontekst | Svaret forklarer den omgivende antagelse eller begrænsning | Svaret citerer et punkt uden den betingelse, der hører til |
| Anvendelighed | Svaret adskiller fakta, beslutninger, spørgsmål og opgaver | Svaret blander resumé, mening og opfølgning i ét vagt afsnit |
HiNoter er designet til denne kontrolvane. Brugere kan stille spørgsmål om PDF'en, undersøge den understøttende henvisning og holde svaret forbundet med kilden. Dette kildehenviste mønster reducerer risikoen for hallucinationer, fordi arbejdsgangen tilskynder til verificering i stedet for at behandle AI-output som en endelig autoritet.
Almindelig PDF-konvertering over for AI-resuméværktøj og HiNoter
Mange PDF-værktøjer lyder ens, men de løser forskellige problemer. En PDF-konverter udtrækker indhold. Et PDF-resuméværktøj komprimerer indhold. En arbejdsgang fra PDF til viden hjælper en person med at bruge indholdet på tværs af møder, forskning, noter og opfølgende arbejde.
| Arbejdsgang | Bedst til | Typisk output | Begrænsning |
|---|---|---|---|
| Almindelig PDF-konverter | At få tekst ud af en fil | Rå tekst, Word-dokument eller kopieret tekst | Beslutter ikke, hvad der er vigtigt, eller hvad man skal gøre bagefter |
| Grundlæggende AI-PDF-opsummering | At skabe en kortere version af ét dokument | Opsummering i afsnit eller punktform | Kan mangle kildehenvisninger, handlingspunkter eller genbrug på tværs af arbejdet |
| Generisk AI-chat med uploadet PDF | At stille hurtige spørgsmål om et dokument | Svar og korte forklaringer | Kvaliteten afhænger af tekstudtræk, kontekstbegrænsninger og kildeforankring |
| HiNoter PDF-til-viden-arbejdsgang | At omdanne tilladte PDF'er til noter, forberedelse, svar og genanvendelig viden | Opsummering, hovedpunkter, mødeforberedelse, kilde-linket AI Chat, eksport og forbundne noter | Brugerne skal stadig verificere følsomme påstande og respektere dokumenttilladelser |
Hvornår AI ikke skal bruges på en PDF
Der findes tilfælde, hvor den rigtige arbejdsgang er at undgå at uploade PDF'en, indtil tilladelser og kontroller er afklaret. Brug ikke en AI-PDF-opsummerer, når dokumentet indeholder fortrolige oplysninger, som du ikke har tilladelse til at behandle, når en kontrakt eller politik blokerer for behandling af tredjeparter, når PDF'en indeholder personoplysninger, der kræver særlig håndtering, eller når situationen kræver en formel juridisk, medicinsk, finansiel eller compliance-gennemgang.
I disse tilfælde skal du bruge internt godkendte systemer, bede dokumentejeren om vejledning eller oprette en manuel opsummering i det kontrollerede miljø. AI kan stadig være nyttig senere, men kun efter at spørgsmålet om datastyring er besvaret. En god AI-PDF-opsummeringsarbejdsgang bør gøre denne grænse synlig i stedet for at skjule den bag en praktisk uploadknap.
Overvejelser om privatliv og sikkerhed
PDF'er kan indeholde følsomme oplysninger, selv når de ser almindelige ud. Kontrakter, bestyrelsespræsentationer, medarbejderpolitikker, finansielle rapporter, medicinske dokumenter, juridiske notater, kundeundersøgelser og interne produktspecifikationer kræver alle omhyggelig håndtering. Før du uploader en PDF til en AI-opsummerer, skal du bekræfte, at dokumentet må behandles i henhold til dine kontrakter, interne politikker, sikkerhedskrav og fortrolighedsforpligtelser.
Anvend adgangskontroller på opsummeringer, noter, eksporter og AI Chat-svar lige så omhyggeligt, som du anvender dem på den oprindelige PDF. En kort opsummering kan afsløre den mest følsomme del af et dokument hurtigere end selve dokumentet. For reguleret eller fortroligt arbejde skal du fastlægge forventninger til opbevaring, sletning, deling og revision, før du bruger en AI-PDF-opsummeringsarbejdsgang.
Kvalitetstjekliste før deling af en PDF-opsummering
Brug denne tjekliste, før du sender en PDF-opsummering til en kollega, leder, studiegruppe eller kunde. Bekræft først, at PDF'en må behandles af AI. Kontrollér derefter, om dokumentet er scannet eller har et tekstlag. Gennemgå for det tredje kvaliteten af tekstudtrækket for tabeller, sider, citater og tal. Bekræft for det fjerde, at opsummeringen adskiller fakta, fortolkning, anbefalinger og næste skridt. Sørg for det femte for, at sidehenvisninger er synlige ved vigtige påstande.
Hvis PDF'en indeholder juridiske, medicinske, finansielle, akademiske eller tekniske detaljer, må du ikke udelukkende stole på opsummeringen. Brug opsummeringen som et navigationslag, og gennemgå kilden, før du træffer beslutninger. Dette er især vigtigt, når OCR blev brugt, fordi OCR-fejl kan forplante sig til fejl i opsummeringen.
Klar til at omdanne PDF'er til anvendelig viden? Brug HiNoter til at opsummere tilladte PDF'er, oprette noter til mødeforberedelse, udtrække hovedpunkter og stille kilde-linkede spørgsmål på tværs af dine dokumenter.
Ofte stillede spørgsmål
Hvad er en AI-PDF-opsummerer?
En AI-PDF-opsummerer udtrækker eller læser PDF-indhold og opretter en kortere opsummering af de vigtige oplysninger. En stærk arbejdsgang kan også oprette hovedpunkter, studienoter, mødeforberedelse, kilde-linkede svar og genanvendelig viden fra rapporter, artikler, manualer, slides og interne dokumenter.
Kan AI opsummere scannede PDF'er?
Ja, men scannede PDF'er skal normalt først behandles med OCR. OCR omdanner sidebilleder til maskinlæsbar tekst. Den genkendte tekst bør gennemgås, fordi scanninger, håndskrift, lav kontrast, kolonner, tabeller og roterede sider kan skabe fejl.
Hvad er OCR i forbindelse med PDF-opsummering?
OCR, eller optisk tegngenkendelse, er processen med at genkende tekst i et billede eller på en scannet side. Ved PDF-opsummering er OCR ofte nødvendigt, før AI kan opsummere en scannet PDF som tekst.
Hvad er forskellen mellem en scannet PDF og en PDF med tekstlag?
En PDF med tekstlag indeholder tekst, der kan markeres, og som ofte kan udtrækkes direkte. En scannet PDF er normalt en samling sidebilleder, så den kræver OCR, før teksten kan søges i, kopieres, opsummeres eller bruges til kilde-linkede spørgsmål.
Kan HiNoter chatte med en PDF?
HiNoter kan fungere som en PDF-til-viden-arbejdsgang ved at udtrække eller bruge PDF-indhold, oprette opsummeringer og noter og give brugerne mulighed for at stille kilde-linkede spørgsmål om dokumentet, når PDF'en må behandles.
Hvad skal jeg kontrollere, før jeg stoler på en PDF-opsummering?
Kontrollér, om PDF'en har et pålideligt tekstlag eller OCR-resultat, om tabeller og fodnoter er udtrukket korrekt, om sidehenvisninger er bevaret, og om vigtige påstande, tal og citater stemmer overens med kilden.
Hvordan skal teams håndtere privatliv med en AI-PDF-opsummerer?
Upload, opsummér, eksportér eller chat kun med PDF'er, når kontrakter, interne politikker, fortrolighedsregler og dokumenttilladelser tillader det. Behandl opsummeringer, noter og AI Chat-svar med de samme adgangskontroller som det oprindelige dokument.