PDF-yhteenvetoa tekevä tekoäly poimii tai lukee PDF-sisältöä ja muuttaa sen lyhyemmiksi yhteenvedoiksi, pääkohdiksi, muistiinpanoiksi ja lähteisiin linkitetyiksi vastauksiksi. Paras työnkulku käsittelee tekstikerrokselliset PDF-tiedostot, skannatut PDF-tiedostot, OCR-laadun, sivuviitteet, yksityisyyden ja uudelleenkäytön, jotta raporteista, tutkielmista, käyttöoppaista ja kokousvalmisteluasiakirjoista tulee staattisten tiedostojen sijaan tietoa.
Kokeile HiNoteria ladataksesi sallitut PDF-tiedostot ja muuntaaksesi ne yhteenvedoiksi, muistiinpanoiksi, pääkohdiksi, kokousvalmisteluiksi ja lähteisiin linkitetyksi tekoälychatiksi.
Mikä on PDF-yhteenvetoja tekevä tekoäly?
PDF-yhteenvetoja tekevä tekoäly on ohjelmisto, joka lukee PDF-tiedoston sisältöä ja luo tärkeistä tiedoista lyhyemmän version. Se voi tehdä yhteenvedon raporteista, tutkimusartikkeleista, esitysvienneistä, käyttöoppaista, luentomuistiinpanoista, sisäisistä käytännöistä, sopimuksista, kokousaineistoista ja muista asiakirjoista. Perustyökalu luo lyhyen yhteenvedon. Kehittyneempi työnkulku luo osioiden yhteenvedot, pääkohdat, opiskelumuistiinpanot, kokousvalmistelut, kysymykset ja lähteisiin perustuvan keskustelun.
Olennainen ero on siinä, että PDF on säiliö, ei aina puhdasta tekstiä. Jotkin PDF-tiedostot sisältävät normaalin tekstikerroksen. Toiset ovat skannattuja sivukuvia. Joissakin yhdistyvät teksti, kuvat, taulukot, alaviitteet, palstat, huomautukset ja kaaviot. Ennen kuin tekoäly voi tehdä PDF-tiedostosta tarkan yhteenvedon, työkalun on poimittava käyttökelpoinen sisältö ja säilytettävä riittävästi lähdekontekstia tarkistamista varten.
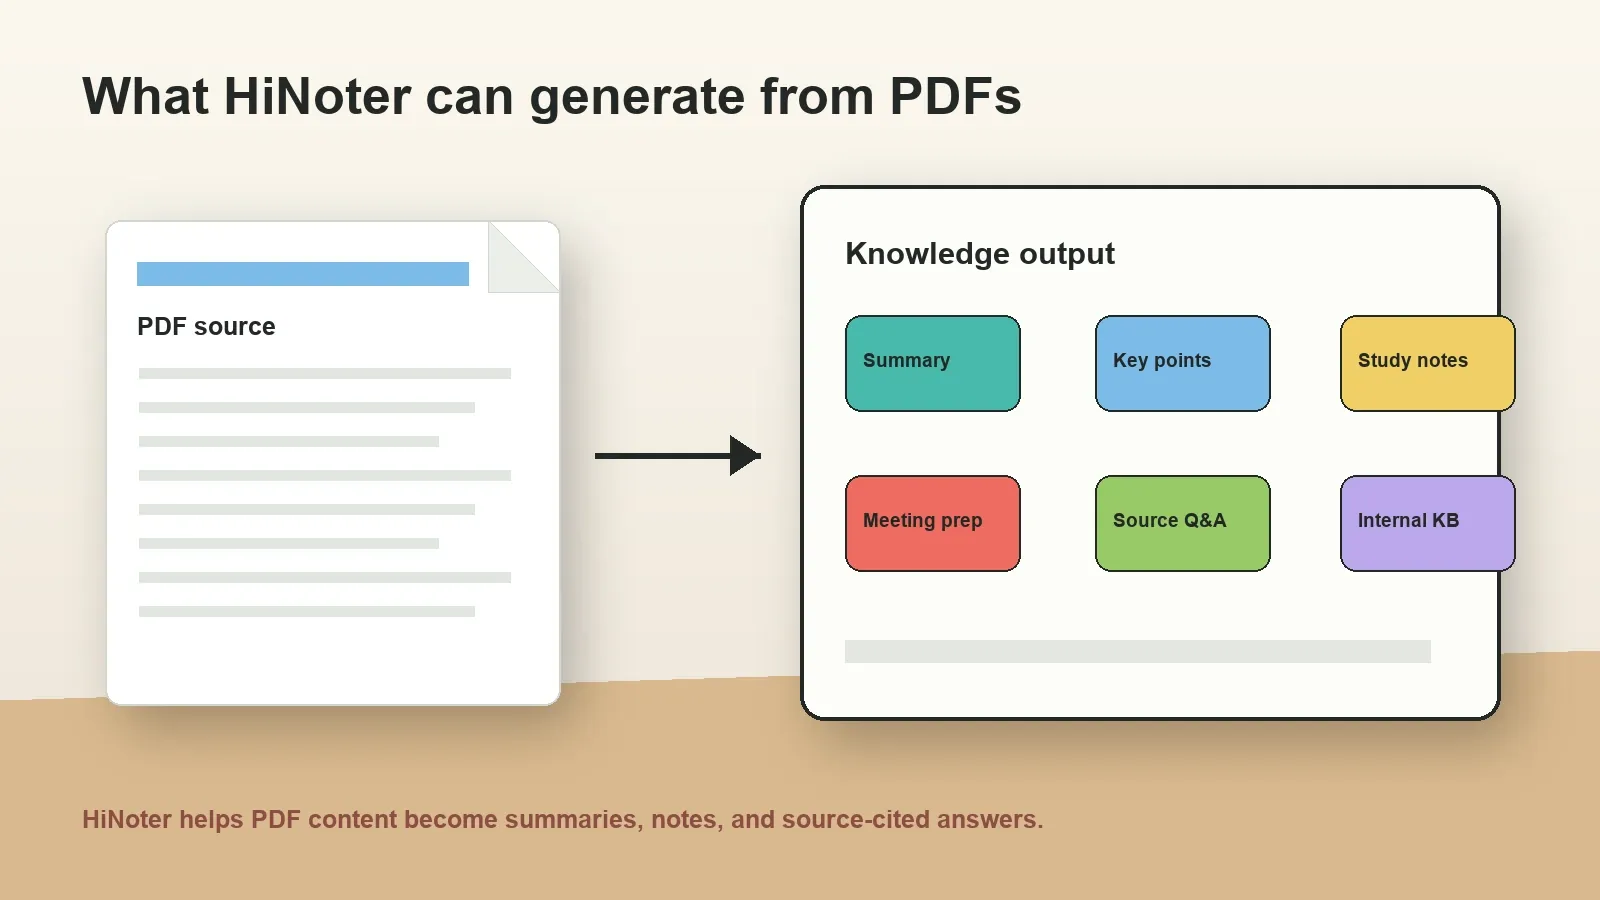
HiNoter on hyödyllinen, kun tavoitteena on muuntaa PDF tiedoksi. Sen avulla voi poimia PDF-sisältöä tai hyödyntää sitä, tehdä yhteenvedon osioista, tunnistaa pääkohdat, luoda tutkimus- tai kokousmuistiinpanoja ja esittää asiakirjaa koskevia lähteisiin viittaavia kysymyksiä.
Määritelmät: OCR, PDF tekstiksi, PDF-yhteenvedot ja lähteisiin perustuva PDF-keskustelu
OCR tarkoittaa optista merkintunnistusta. OCR tunnistaa kuvissa tai skannatuilla sivuilla olevan tekstin ja muuntaa sen koneellisesti luettavaksi tekstiksi. PDF-yhteenvetojen tekemisessä OCR on usein silta kuvamuotoisen asiakirjan ja yhteenvetoon soveltuvan tekstilähteen välillä.
PDF tekstiksi tarkoittaa tekstin poimimista PDF-tiedostosta. Jos PDF-tiedostossa on jo tekstikerros, poiminta voi olla suhteellisen suoraviivaista. Jos PDF on skannattu, poiminta riippuu usein OCR:stä. Kummassakin tapauksessa poimittu teksti saattaa silti tarvita puhdistamista, kun mukana on palstoja, taulukoita, alaviitteitä, sivunylätunnisteita ja kuvia.
PDF-yhteenvetojen tekeminen tarkoittaa poimitun PDF-sisällön muuntamista lyhyemmäksi selitykseksi olennaisista asioista. Tuloksena voi olla johtotason yhteenveto, osion yhteenveto, luettelomuotoinen tiivistelmä, opiskeluopas, kokousvalmistelumuistio tai luettelo riskeistä, havainnoista ja toimenpiteistä.
Lähteisiin perustuva PDF-keskustelu tarkoittaa PDF-tiedostoa koskevien kysymysten esittämistä ja lähdesivuihin, osioihin tai otteisiin yhdistettyjen vastausten saamista. Tämä auttaa käyttäjiä tarkistamaan väitteet sen sijaan, että he luottaisivat yleiseen tekoälyvastaukseen, joka ei liity asiakirjaan.
Tekstikerrokselliset PDF-tiedostot ja skannatut PDF-tiedostot
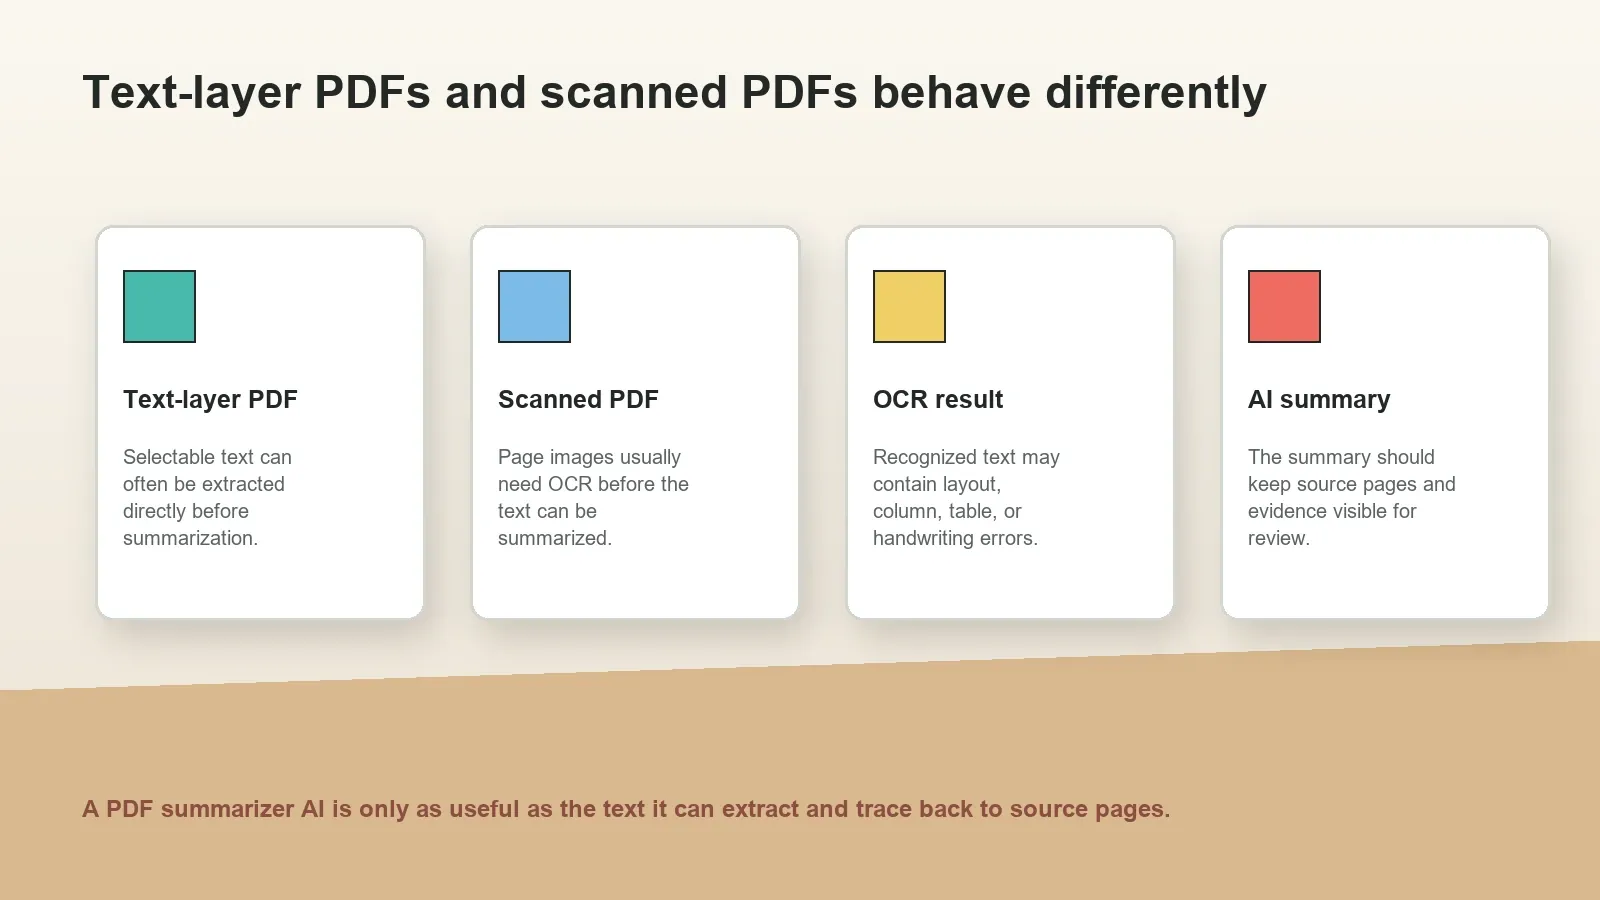
Tekstikerrokselliset PDF-tiedostot ja skannatut PDF-tiedostot toimivat eri tavoin. Tekstikerroksellinen PDF sisältää valittavaa tekstiä. Siitä voi usein kopioida sanoja, tehdä hakuja tai poimia tekstiä ohjelmallisesti. Skannattu PDF on yleensä joukko sivukuvia. Se voi näyttää ihmiselle luettavalta, mutta työkalu saattaa tarvita OCR:ää ennen kuin se voi hakea sanoja tai tehdä niistä yhteenvedon.
Adoben Acrobat-dokumentaatiossa OCR kuvataan menetelmäksi, jolla skannatuissa asiakirjoissa oleva teksti tunnistetaan, jotta tuloksena olevasta PDF-tiedostosta tulee haettava ja muokattava. Tämä on käytännön syy siihen, miksi OCR on tärkeä tekoälyavusteisessa yhteenvedon tekemisessä: jos sanat eivät ole koneellisesti luettavassa muodossa, tekoälyllä ei välttämättä ole luotettavaa tekstiä, josta tehdä yhteenveto.
| PDF-tyyppi | Toimintatapa | Paras työnkulku | Yleinen rajoitus |
|---|---|---|---|
| Tekstikerroksellinen PDF | Tekstiä voi usein valita, hakea ja poimia | Poimi teksti, säilytä sivuviitteet ja tee yhteenveto osioittain | Taulukot, palstat, alaviitteet ja kuvat voivat silti poimittua huonosti |
| Skannattu PDF | Sivut ovat kuvamaisia, eikä niissä välttämättä ole valittavaa tekstiä | Suorita OCR, tarkista tunnistettu teksti ja tee sitten yhteenveto | OCR voi tulkita heikkolaatuiset skannaukset, käsialan, leimat ja asettelut väärin |
| Sekamuotoinen PDF | Joillakin sivuilla on tekstiä, kun taas toiset ovat skannauksia tai kuvia | Poimi teksti mahdollisuuksien mukaan ja käytä OCR:ää kuvasivuihin | Sivujen yhdenmukaisuus ja lähdeviitteet vaativat lisätarkistusta |
| Monimutkainen PDF | Saattaa sisältää kaavioita, taulukoita, palstoja, lomakkeita, kuvia ja huomautuksia | Tee yhteenveto osioista ja tarkista tärkeät todisteet manuaalisesti | Visuaalinen tieto ja taulukoiden rakenne eivät välttämättä säily poiminnassa selkeinä |
PDF-tiedoston yhteenveto tekoälyn avulla
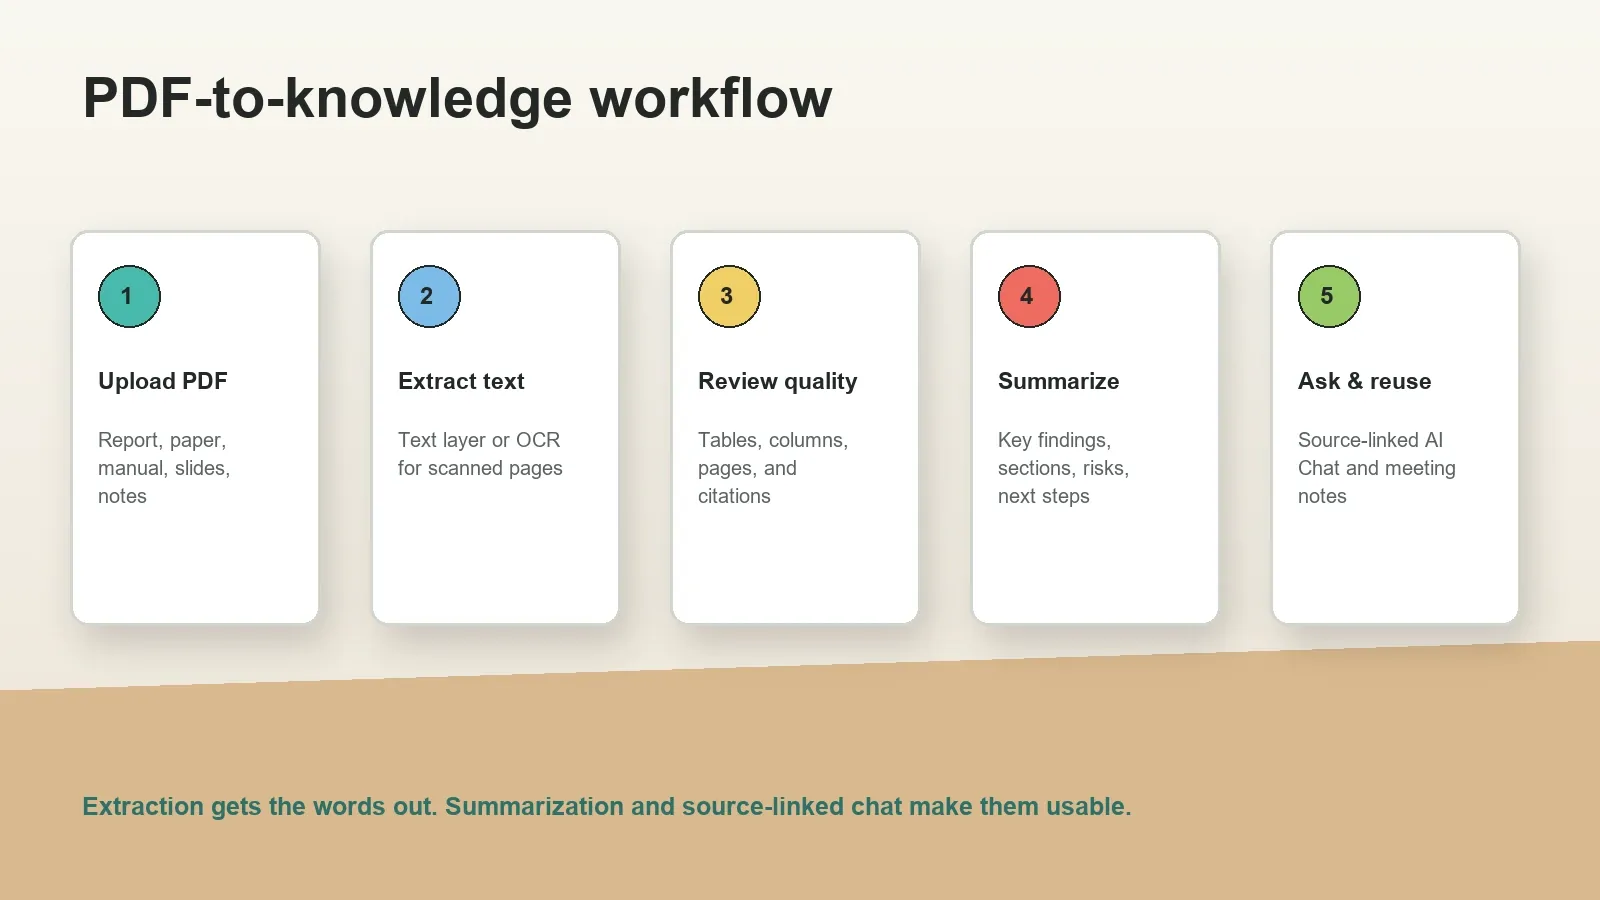
- Varmista käyttöoikeus. Käytä vain PDF-tiedostoja, joiden lataamiseen, käsittelyyn, yhteenvetojen tekemiseen, vientiin tai niitä koskevien kysymysten esittämiseen tiimilläsi on lupa. Raportit, tutkielmat, sopimukset, käyttöoppaat ja sisäiset asiakirjat voivat olla arkaluonteisia.
- Tunnista PDF-tyyppi. Tarkista, sisältääkö PDF valittavaa tekstiä vai skannattuja kuvasivuja. Tämä määrittää, onko ensimmäinen vaihe tekstin poiminta vai OCR.
- Poimi tai tunnista teksti. Käytä tekstikerrosta, kun se on saatavilla. Käytä OCR:ää skannatuille sivuille tai vain kuvia sisältäviin PDF-tiedostoihin. Säilytä sivunumerot, otsikot ja osiojärjestys aina kun mahdollista.
- Tarkista poiminnan laatu. Tarkista sivujärjestys, palstat, taulukot, yhtälöt, alaviitteet, kaaviot, viittaukset, ylätunnisteet, käsiala ja käännetyt sivut. Korjaa ilmeiset ongelmat ennen kuin luotat yhteenvetoon.
- Luo yhteenveto. Luo johtotason yhteenveto, osioiden yhteenvedot, keskeiset havainnot, riskit, määritelmät, tutkimusmuistiinpanot tai kokousvalmistelutiivistelmä lukijan tavoitteen mukaan.
- Esitä lähteisiin linkitettyjä kysymyksiä. Kysy tekoälychatilta todisteista, suosituksista, määritelmistä, ristiriidoista ja seuraavista toimista. Pidä sivu- tai osoviitteet näkyvissä.
- Vie vastuullisesti. Jaa vain sellaisia yhteenvetoja, muistiinpanoja tai vastauksia, joiden jakamiseen käyttöoikeutesi riittävät. Käytä yhteenvetoihin ja tekoälychattiin käyttöoikeuksien hallintaa aivan kuten alkuperäiseen PDF-tiedostoon.
Yleisiä PDF-tiedostojen poiminnan ongelmatapauksia
Monet käyttäjät odottavat PDF-yhteenvetoja tekevän tekoälyn toimivan tavallisen tekstin tiivistäjän tavoin. Se onnistuu vain, kun asiakirja on riittävän selkeä. PDF-tiedostot voivat olla visuaalisesti luettavia, mutta silti ohjelmistolle vaikeita jäsentää. Työkalu saattaa lukea palstat väärässä järjestyksessä, jättää taulukoiden otsikot pois, ohittaa alaviitteet, yhdistää sivunylätunnisteet leipätekstiin tai jättää kuvissa olevan tekstin huomiotta.
Skannatut PDF-tiedostot tuovat mukanaan uuden riskitason. OCR:n laatu riippuu skannauksen tarkkuudesta, kontrastista, sivun kääntymisestä, kuvan kohinasta, kielestä, fonteista, käsialasta, leimoista ja siitä, onko sivulla monimutkainen asettelu. Hyväkin OCR-tulos voi tulkita numerot, oikeudelliset viittaukset, tieteelliset symbolit tai tuotenimet väärin.
| Virhetapaus | Mitä voi mennä pieleen | Miten riskiä voi vähentää |
|---|---|---|
| Kaksipalstainen asettelu | Kappaleet voidaan lukea väärässä järjestyksessä | Tarkista osioiden järjestys ennen tutkimusartikkeleiden tiivistämistä |
| Taulukot | Otsikot ja solut voivat menettää yhteytensä | Varmista numerot, rivit ja sarakkeet PDF-tiedoston perusteella |
| Skannatut sivut | OCR voi tulkita sanat, nimet tai symbolit väärin | Käytä selkeitä skannauksia ja tarkista tärkeät osiot manuaalisesti |
| Kaaviot ja kuviot | Visuaalinen data ei välttämättä muutu automaattisesti tekstiksi | Lisää muistiinpanoja tai tarkastele kuvioita, kun johtopäätökset riippuvat visuaalisesta aineistosta |
| Alaviitteet ja lähdeviitteet | Viittaukset voivat irrota väitteistä | Pidä sivuviitteet ja viittauskonteksti näkyvissä |
| Lomakkeet ja sopimukset | Valintaruudut, kentät ja lausekkeet voivat poimia tiedot epäjohdonmukaisesti | Tarkista oikeudelliset tai toiminnalliset asiakirjat ennen yhteenvetojen jakamista |
Miten HiNoter muuttaa PDF-tiedostot uudelleenkäytettäväksi tiedoksi
HiNoteria tulisi käyttää PDF-tiedostosta tiedoksi -työnkulkuna, ei pelkästään PDF-muuntimena. Ensimmäinen kerros on sisällön poiminta: PDF-tiedoston teksti tai OCR, jos asiakirja sitä tarvitsee. Toinen kerros on ymmärtäminen: yhteenvedot, pääkohdat, osioiden muistiinpanot, avoimet kysymykset, opiskelumuistiinpanot ja kokousvalmistelut. Kolmas kerros on tiedonhaku: lähteisiin linkitetty tekoälychat, jonka avulla käyttäjä voi esittää kysymyksiä ja jäljittää vastaukset takaisin asiakirjaan.
Tutkimusartikkelin kohdalla HiNoter voi auttaa tunnistamaan tutkimuskysymyksen, menetelmät, tulokset, rajoitukset, määritelmät, lähdeviitteet ja avoimet kysymykset. Raportista se voi tuottaa johdon yhteenvedon, riskit, suositukset, mittarit ja sidosryhmien kysymykset. Kokousmateriaalista se voi muuttaa staattisen asiakirjan valmistelumuistioksi, joka sisältää tehtävät päätökset, esitettävät kysymykset ja seurantatoimet.
Tämä liittyy luontevasti HiNoterin laajempaan työnkulkuun. Tiimit voivat yhdistää tekoälyn kokousmuistiinpanot, äänen tekstiksi -muunnokset, videomuistiinpanot ja PDF-tiedostot yhdeksi lähteet huomioivaksi tietoprosessiksi. Sen sijaan että oivallukset hajautuisivat tiedostoihin ja yksityisiin muistiinpanoihin, käyttäjät voivat esittää kysymyksiä eri lähteistä ja tarkistaa, mistä kukin vastaus on peräisin.
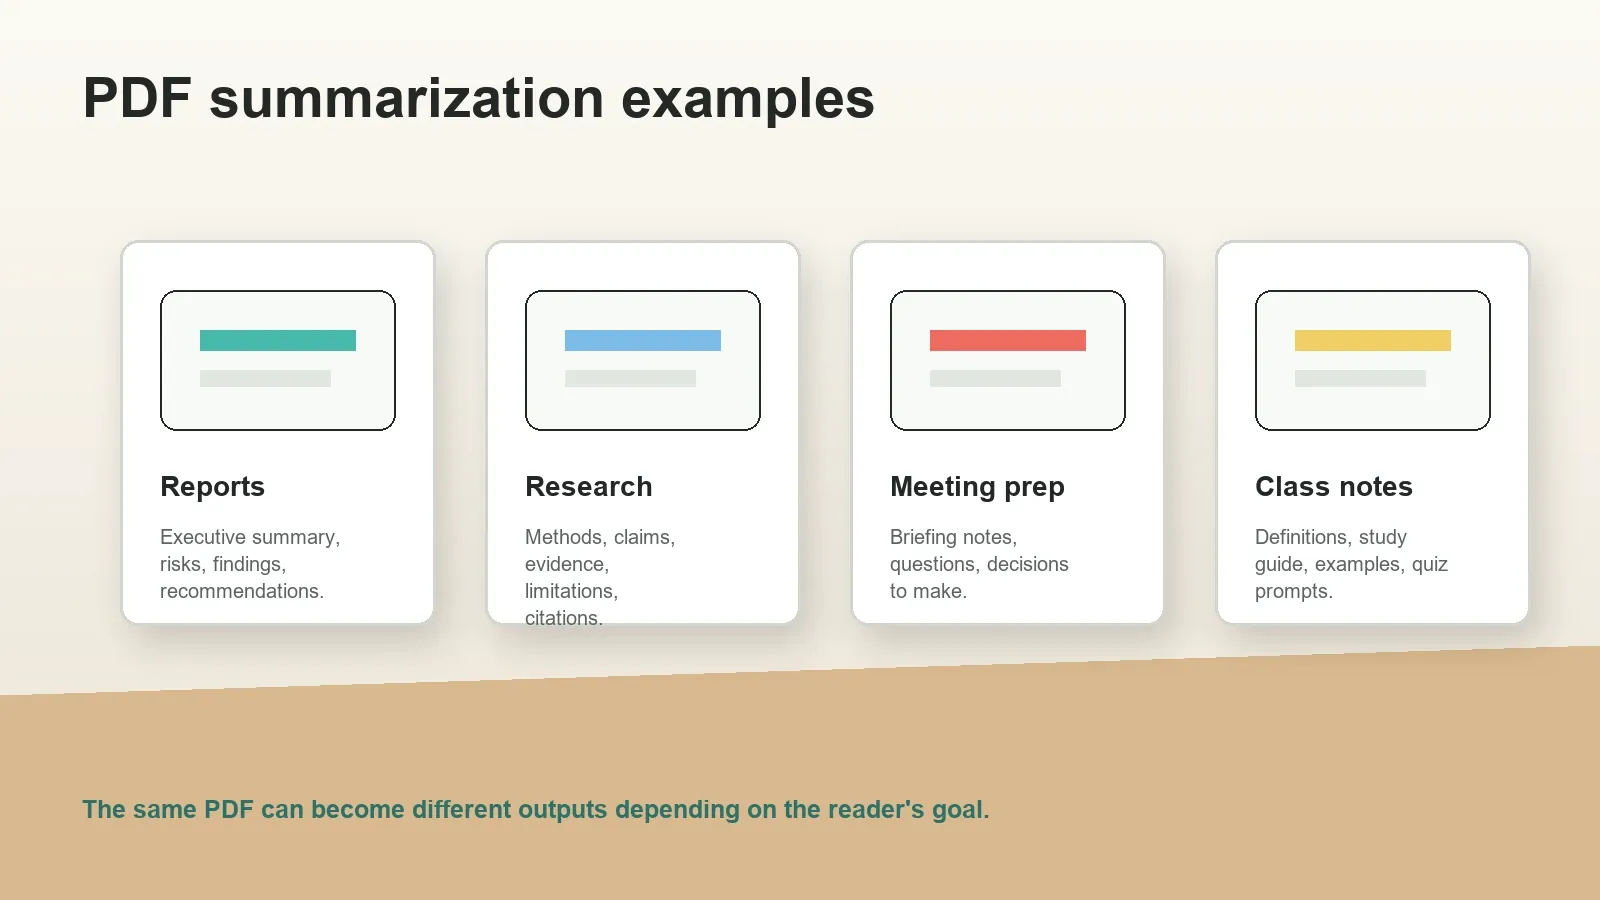
Käyttötapaukset: raportit, tutkimus, kokousvalmistelut, luentomuistiinpanot ja sisäinen tieto
Raportit sisältävät usein havaintoja, kaavioita, suosituksia ja riskejä käsitteleviä osioita, joita kiireisillä tiimeillä ei ole aikaa lukea kokonaan. PDF-yhteenvetoa tekevä tekoäly voi luoda johdon yhteenvedon, korostaa tärkeimmät mittarit, tunnistaa riskit ja luetella sidosryhmien kysymykset ennen kokousta.
Tutkimusartikkelit vaativat huolellisempaa rakennetta. Hyvässä yhteenvedossa tulisi erottaa toisistaan tiivistelmä, tutkimuskysymys, menetelmät, aineisto, tulokset, rajoitukset ja lähdeviitteet. Sen ei pitäisi esittää artikkelia varmemmin kuin artikkeli oikeuttaa. Lähteisiin linkitetyt kysymykset ovat hyödyllisiä, koska lukijat voivat kysyä, mihin artikkeli perustaa tietyn väitteen.
Kokousvalmistelu on yksi arvokkaimmista työnkuluista. Sen sijaan että käyttäjä lukisi pitkän PDF-materiaalin muutama minuutti ennen puhelua, hän voi luoda valmistelumuistion: mitä asiakirjassa sanotaan, mistä on päätettävä, mitä kysymyksiä esittää, millä riskeillä on merkitystä ja mitä seurantaa kokouksen jälkeen saatetaan tarvita.
Luentomuistiinpanot ja opiskelumateriaalit hyötyvät määritelmistä, esimerkeistä, opiskelukysymyksistä, miellekarttojen hahmotelmista ja lähteisiin linkitetystä kysymys-vastausmateriaalista. Opiskelija voi pyytää asiakirjaa selittämään käsitteen, mutta hänen tulisi silti tarkistaa lähdesivut ennen kuin hän luottaa vastaukseen tehtävässä tai kokeessa.
Sisäisen tiedon uudelleenkäyttö muuttaa PDF-tiedostot staattisista tiedostoista haettavaksi muistiksi. Oppaat, perehdytysasiakirjat, käytännöt, tuote-esittelyt ja asiakastutkimukset voivat muuttua yhteenvedoiksi ja lähteisiin linkitetyiksi vastauksiksi, joiden avulla tiimit välttävät samojen kysymysten esittämisen toistuvasti.
| Käyttötapaus | Esimerkkejä PDF-tiedostoista | Hyödyllinen tulos | HiNoterin työnkulku |
|---|---|---|---|
| Raportit | Markkinaraportit, asiakastutkimukset, neljännesvuosikatsaukset | Johdon yhteenveto, riskit, mittarit, suositukset | Esitä lähteisiin linkitettyjä kysymyksiä ennen strategiapalavereita |
| Tutkimus | Artikkelit, kirjallisuuskatsaukset, tekniset tutkimukset | Menetelmät, tulokset, rajoitukset, viittaustietoiset muistiinpanot | Luo opiskelumuistiinpanoja ja näyttöön perustuvia kysymyksiä ja vastauksia |
| Kokousvalmistelu | Hallituksen kokousmateriaalit, projektiesittelyt, myyntiasiakirjat | Päätösmuistio, kysymykset, tehtävät, riskit | Muuta PDF-tiedostot kokousta edeltäviksi muistiinpanoiksi ja seurantatehtäviksi |
| Luentomuistiinpanot | Luento-PDF:t, diojen viennit, lukumateriaalit | Määritelmät, esimerkit, tietovisakysymykset, opiskeluopas | Rakenna lähteisiin linkitetty opiskelutyönkulku |
| Sisäinen tieto | Oppaat, käytännöt, perehdytysasiakirjat, tuote-eritelmät | Haettavat yhteenvedot, vastaukset, uudelleenkäytettävät muistiinpanot | Yhdistä PDF-tiedostot kokouksiin, ääneen ja videomuistiinpanoihin |
Esimerkkejä lähteisiin linkitetystä PDF-chatista
Lähteisiin linkitetty PDF-chat on hyödyllinen, kun käyttäjä ei tiedä, miltä sivulta vastaus löytyy. Sen sijaan että käyttäjä lukisi kokonaisen raportin, hän voi esittää kohdennettuja kysymyksiä ja tarkastella lähdekontekstia ennen kuin luottaa vastaukseen.
| Kysymys | Hyödyllinen vastaus | Tarkistettava lähdeviite |
|---|---|---|
| Mitkä ovat tämän raportin kolme suurinta riskiä? | Riskit tärkeysjärjestyksessä lyhyine selityksineen | Riskiosio ja sivuviitteet |
| Mitä minun pitäisi valmistella ennen kokousta? | Päätöskohdat, kysymykset ja tarvittava taustatieto | Tiivistelmä, suositukset, liite |
| Mikä näyttö tukee pääasiallista havaintoa? | Keskeiset tietopisteet, esimerkit tai viitatut väitteet | Taulukot, menetelmät, tulossivut, viitteet |
| Mikä muuttui viimeisimpään versioon verrattuna? | Yhteenveto päivitetyistä oletuksista tai suosituksista | Muutosmerkinnät, muuttuneet osiot, lähdesivut |
| Laadi tästä PDF-tiedostosta seurantaviesti. | Lyhyt yhteenveto, tehtävät päätökset ja seuraavat toimet | Osiot, jotka tukevat kutakin tehtävää tai väitettä |
Kopioitava PDF-yhteenvetopohja
Hyödyllisen PDF-yhteenvedon pitäisi olla riittävän jäsennelty jaettavaksi, mutta ei niin tiivistetty, että lukija menettää asiayhteyden. Raporttien, tutkimusten, käytäntöjen, käyttöoppaiden ja kokousaineistojen kohdalla paras pohja ei yleensä ole yksi kappale. Se on kerroksittainen tiivistelmä, jonka avulla kiireinen lukija voi ensin silmäillä vastauksen ja tarkistaa tarvittaessa yksityiskohdat ja lähteet.
Käytä tätä pohjaa, kun tiivistät PDF-tiedoston tekoälyn avulla. Se pitää yhteenvedon käytännöllisenä kokouksiin valmistautumista, tiimipäivityksiä, tutkimusten läpikäyntiä ja sisäisen tiedon uudelleenkäyttöä varten.
| Osio | Mitä sisällytetään | Miksi se on tärkeää |
|---|---|---|
| Yhden lauseen vastaus | Pääasiallinen johtopäätös yhdessä lauseessa | Auttaa lukijoita päättämään, jatkavatko he lukemista |
| Tiivistelmä | Viidestä kahdeksaan luetelmakohtaa tärkeimmistä asioista | Muuttaa pitkän PDF-tiedoston nopeasti jaettavaksi tiivistelmäksi |
| Keskeinen näyttö | Väitteet, mittarit, esimerkit, sivuviitteet tai viitatut osiot | Antaa lukijoille mahdollisuuden tarkistaa tärkeät väitteet lähteestä |
| Riskit ja rajoitukset | Epäselvät oletukset, puuttuvat tiedot, heikko näyttö tai operatiivinen riski | Estää yhteenvetoa vaikuttamasta varmempaan kuin PDF-tiedosto |
| Esitettävät kysymykset | Avoimet kysymykset kokousta, katsausta, oppituntia tai sidosryhmäkeskustelua varten | Muuttaa PDF-tiedoston passiivisesta lukemisesta aktiiviseksi päätöksenteoksi |
| Seuraavat toimet | Tehtävät, vastuuhenkilöt, määräajat tai saatavilla olevat seurantadokumentit | Yhdistää dokumentin ymmärtämisen todellisiin työnkulun tuloksiin |
HiNoterissa tästä pohjasta voi tehdä toistettavan työnkulun. Käyttäjä voi ladata sallitun PDF-tiedoston, luoda tiiviin yhteenvedon, pyytää kunkin luetelmakohdan tueksi tarvittavan näytön ja viedä sitten tiivistelmän työtilaan, jossa tiimi jo työskentelee. Yhteenvedon voi myös yhdistää kokousmuistiinpanoihin, jolloin ennakkolukuna käytettävä PDF ja kokouskeskustelu pysyvät yhteydessä toisiinsa eivätkä muutu erillisiksi tiedostoiksi.
Kokoukseen valmistautumisen kehotteet PDF-tiedostoja tiivistävälle tekoälylle
PDF-tiedostoja tiivistävä tekoäly on erityisen hyödyllinen ennen kokouksia, koska se muuttaa pitkän ennakkoon luettavan aineiston keskustelusuunnitelmaksi. Tavoitteena ei ole korvata lukemista tärkeissä asioissa. Tavoitteena on tunnistaa huomiota ansaitsevat osiot, vastauksia tarvitsevat kysymykset ja päätökset, joita ei voi siirtää.
Kokeile tällaisia kehotteita käyttäessäsi HiNoteria tai muuta lähdetietoista työnkulkua kokoukseen valmistautumiseen:
- Tiivistä tämä PDF-tiedosto 15 minuutin sidosryhmäkokousta varten ja luettele päätökset, jotka meidän on tehtävä.
- Poimi riskit, ratkaisemattomat kysymykset ja oletukset, joista pitäisi keskustella kokouksessa.
- Muuta tämä raportti tiivistelmäksi johtajalle, joka ei ole lukenut koko dokumenttia.
- Luettele väitteet, jotka on tarkistettava lähteestä, ja näytä kunkin kohdalla sivu- tai osoviite.
- Laadi tästä PDF-tiedostosta seurantasuunnitelma, jossa on tehtävät, mahdolliset vastuuhenkilöt ja riippuvuudet.
- Vertaa tämän PDF-tiedoston suosituksia edellisen keskustelumme kokousmuistiinpanoihin.
Nämä kehotteet toimivat, koska niissä pyydetään lopputulosta eikä ainoastaan dokumentin lyhyempää versiota. Yleinen yhteenveto kertoo, mitä PDF-tiedosto sisältää. Kokoukseen valmistautumista tukeva yhteenveto kertoo, mitä lukijan pitäisi ymmärtää, kysyä, päättää tai tehdä seuraavaksi.
Lähteisiin linkitettyjen PDF-keskusteluvastausten arviointi
Lähdeviitteet eivät tee tekoälyn vastauksesta automaattisesti oikeaa, mutta niiden avulla vastaus on helpompi tarkistaa. Käyttäjän pitäisi pystyä selvittämään, mistä vastaus on peräisin, tukeeko viitattu sivu väitettä ja ohittiko malli tärkeää asiayhteyttä. Tämä on erityisen tärkeää tutkimusartikkeleissa, sopimuksissa, talousraporteissa, teknisissä käyttöoppaissa ja käytäntöjä käsittelevissä PDF-tiedostoissa.
| Tarkistettava asia | Hyvä merkki | Varoitusmerkki |
|---|---|---|
| Lähteiden kattavuus | Vastauksessa viitataan asiaankuuluvaan osioon, sivuun, taulukkoon tai liitteeseen | Vastaus on varma, mutta siinä ei viitata lähteen sijaintiin |
| Väitteen vahvuus | Vastauksessa käytetään varovaista kieltä, kun PDF-tiedosto on epävarma | Vastaus muuttaa heikon näytön vahvaksi suositukseksi |
| Numerot ja nimet | Mittarit, päivämäärät, nimet ja määritelmät vastaavat PDF-tiedostoa | OCR- tai poimintavirheet muuttavat tärkeitä yksityiskohtia |
| Asiayhteys | Vastaus selittää ympäröivän oletuksen tai rajoituksen | Vastaus lainaa kohdan ilman siihen liittyvää ehtoa |
| Toimintakelpoisuus | Vastaus erottaa tosiasiat, päätökset, kysymykset ja tehtävät | Vastaus sekoittaa yhteenvedon, mielipiteen ja seurannan yhdeksi epämääräiseksi kappaleeksi |
HiNoter on suunniteltu tukemaan tätä tarkistustapaa. Käyttäjät voivat esittää PDF-tiedostoa koskevia kysymyksiä, tarkastella tukevaa lähdeviitettä ja pitää vastauksen yhteydessä lähteeseen. Tämä lähteisiin linkitetty toimintatapa vähentää hallusinaatioiden riskiä, koska työnkulku kannustaa tarkistamiseen sen sijaan, että tekoälyn tuotos nähtäisiin lopullisena auktoriteettina.
Tavallinen PDF-muunnin vastaan tekoälytiivistin vastaan HiNoter
Monet PDF-työkalut kuulostavat samanlaisilta, mutta ne ratkaisevat eri ongelmia. PDF-muunnin poimii sisältöä. PDF-tiivistin tiivistää sisältöä. PDF-tiedostosta tiedoksi muuntava työnkulku auttaa henkilöä käyttämään sisältöä kokouksissa, tutkimuksessa, muistiinpanoissa ja seurantatyössä.
| Työnkulku | Sopii parhaiten | Tyypillinen tuloste | Rajoitus |
|---|---|---|---|
| Tavallinen PDF-muunnin | Tekstin saamiseen tiedostosta | Raakateksti, Word-asiakirja tai kopioitu teksti | Ei päätä, mikä on tärkeää tai mitä seuraavaksi pitäisi tehdä |
| Perustason PDF-yhteenvetoa tekevä tekoäly | Yhden asiakirjan lyhyemmän version luomiseen | Kappalemuotoinen yhteenveto tai luettelomerkit | Lähdeviitteet, tehtävät tai uudelleenkäyttö työnkulussa saattavat puuttua |
| Yleinen tekoälychat, johon PDF on ladattu | Nopeiden kysymysten esittämiseen asiakirjasta | Vastaukset ja lyhyet selitykset | Laatu riippuu poiminnasta, kontekstirajoista ja lähteeseen perustuvasta käsittelystä |
| HiNoterin PDF:stä tietämykseksi -työnkulku | Sallittujen PDF-tiedostojen muuttamiseen muistiinpanoiksi, valmistautumiseen, vastauksiksi ja uudelleenkäytettäväksi tiedoksi | Yhteenveto, pääkohdat, kokousvalmistelut, lähteisiin linkitetty tekoälychat, viennit ja toisiinsa yhdistetyt muistiinpanot | Käyttäjien on edelleen tarkistettava arkaluonteiset väitteet ja noudatettava asiakirjojen käyttöoikeuksia |
Milloin tekoälyä ei pidä käyttää PDF-tiedostoon
Joissakin tapauksissa oikea toimintatapa on välttää PDF-tiedoston lataamista, kunnes käyttöoikeudet ja hallintatoimet ovat selkeitä. Älä käytä tekoälyyn perustuvaa PDF-yhteenvetoa, kun asiakirja sisältää luottamuksellisia tietoja, joita sinulla ei ole lupa käsitellä, kun sopimus tai käytäntö estää kolmannen osapuolen käsittelyn, kun PDF sisältää erityiskäsittelyä edellyttäviä henkilötietoja tai kun asian merkitys edellyttää muodollista oikeudellista, lääketieteellistä, taloudellista tai vaatimustenmukaisuuden tarkastelua.
Käytä tällaisissa tapauksissa organisaation hyväksymiä sisäisiä järjestelmiä, pyydä asiakirjan omistajalta ohjeita tai laadi manuaalinen yhteenveto valvotussa ympäristössä. Tekoälystä voi silti olla hyötyä myöhemmin, mutta vasta kun tiedonhallintaa koskeva kysymys on ratkaistu. Hyvän tekoälyyn perustuvan PDF-yhteenvetotyönkulun pitäisi tehdä tämä raja näkyväksi sen sijaan, että se piilottaisi sen kätevän latauspainikkeen taakse.
Yksityisyyttä ja tietoturvaa koskevat näkökohdat
PDF-tiedostot voivat sisältää arkaluonteisia tietoja, vaikka ne näyttäisivät tavallisilta. Sopimukset, hallituksen esitykset, työntekijöiden käytännöt, talousraportit, lääketieteelliset asiakirjat, oikeudelliset muistiot, asiakastutkimukset ja sisäiset tuotemäärittelyt edellyttävät kaikki huolellista käsittelyä. Ennen kuin lataat PDF-tiedoston mihinkään tekoälypohjaiseen yhteenvetotyökaluun, varmista, että asiakirjaa voidaan käsitellä sopimustesi, sisäisten käytäntöjesi, tietoturvavaatimustesi ja salassapitovelvoitteidesi mukaisesti.
Sovella yhteenvetoihin, muistiinpanoihin, vientitiedostoihin ja tekoälychatin vastauksiin käyttöoikeuksien hallintaa yhtä huolellisesti kuin alkuperäiseen PDF-tiedostoon. Lyhyt yhteenveto voi paljastaa asiakirjan arkaluonteisimman osan nopeammin kuin asiakirja itse. Säännellyssä tai luottamuksellisessa työssä määritä säilytystä, poistamista, jakamista ja auditointia koskevat odotukset ennen minkään tekoälyyn perustuvan PDF-yhteenvetotyönkulun käyttämistä.
Laadun tarkistuslista ennen PDF-yhteenvedon jakamista
Käytä tätä tarkistuslistaa ennen kuin lähetät PDF-yhteenvedon tiimikaverille, esihenkilölle, opintoryhmälle tai asiakkaalle. Varmista ensin, että PDF-tiedoston käsittely tekoälyllä on sallittua. Tarkista toiseksi, onko asiakirja skannattu vai sisältääkö se tekstikerroksen. Tarkista kolmanneksi taulukoiden, sivujen, viittausten ja numeroiden poiminnan laatu. Varmista neljänneksi, että yhteenveto erottaa tosiasiat, tulkinnan, suositukset ja seuraavat vaiheet. Pidä tärkeiden väitteiden sivuviitteet näkyvissä.
Jos PDF sisältää oikeudellisia, lääketieteellisiä, taloudellisia, akateemisia tai teknisiä yksityiskohtia, älä luota pelkkään yhteenvetoon. Käytä yhteenvetoa navigointikerroksena ja tarkista lähde ennen päätösten tekemistä. Tämä on erityisen tärkeää, kun käytettiin OCR:ää, koska OCR-virheet voivat kasautua yhteenvedon virheiksi.
Valmis muuttamaan PDF-tiedostot hyödynnettäväksi tiedoksi? Käytä HiNoteria luodaksesi sallituista PDF-tiedostoista yhteenvetoja, kokousvalmisteluja, poimiaksesi pääkohdat ja esittääksesi lähteisiin linkitettyjä kysymyksiä asiakirjoistasi.
Usein kysytyt kysymykset
Mikä on tekoälyyn perustuva PDF-yhteenveto?
Tekoälyyn perustuva PDF-yhteenveto poimii PDF-sisältöä tai lukee sitä ja luo tärkeistä tiedoista lyhyemmän yhteenvedon. Vahva työnkulku voi myös luoda pääkohtia, opiskelumuistiinpanoja, kokousvalmisteluja, lähteisiin linkitettyjä vastauksia ja uudelleenkäytettävää tietoa raporteista, tutkielmista, käyttöoppaista, dioista ja sisäisistä asiakirjoista.
Voiko tekoäly tehdä yhteenvedon skannatuista PDF-tiedostoista?
Kyllä, mutta skannatut PDF-tiedostot tarvitsevat yleensä ensin OCR-käsittelyn. OCR muuntaa sivukuvat koneellisesti luettavaksi tekstiksi. Tunnistettu teksti on tarkistettava, koska skannaukset, käsiala, heikko kontrasti, sarakkeet, taulukot ja käännetyt sivut voivat aiheuttaa virheitä.
Mitä OCR tarkoittaa PDF-yhteenvedoissa?
OCR eli optinen merkintunnistus on prosessi, jossa kuvassa tai skannatulla sivulla oleva teksti tunnistetaan. PDF-yhteenvedoissa OCR:ää tarvitaan usein ennen kuin tekoäly voi tehdä skannatusta PDF-tiedostosta tekstimuotoisen yhteenvedon.
Mitä eroa on skannatulla PDF-tiedostolla ja tekstikerroksen sisältävällä PDF-tiedostolla?
Tekstikerroksen sisältävässä PDF-tiedostossa on valittavaa tekstiä, joka voidaan usein poimia suoraan. Skannattu PDF on yleensä joukko sivukuvia, joten se tarvitsee OCR-käsittelyn, ennen kuin tekstiä voidaan hakea, kopioida, tiivistää tai käyttää lähteisiin linkitettyihin kysymyksiin.
Voiko HiNoter keskustella PDF-tiedoston kanssa?
HiNoter voi toimia PDF:stä tietämykseksi -työnkulkuna poimimalla PDF-sisältöä tai käyttämällä sitä, luomalla yhteenvetoja ja muistiinpanoja sekä antamalla käyttäjien esittää asiakirjaa koskevia lähteisiin linkitettyjä kysymyksiä, kun PDF-tiedoston käsittely on sallittua.
Mitä minun pitäisi tarkistaa ennen kuin luotan PDF-yhteenvetoon?
Tarkista, onko PDF-tiedostossa luotettava tekstikerros tai OCR-tulos, poimittiinko taulukot ja alaviitteet oikein, säilytettiinkö sivuviitteet ja vastaavatko tärkeät väitteet, numerot ja viittaukset lähdettä.
Miten tiimien pitäisi käsitellä yksityisyyttä tekoälyyn perustuvassa PDF-yhteenvedossa?
Lataa, tiivistä, vie tai keskustele PDF-tiedostojen kanssa vain, kun sopimukset, sisäinen käytäntö, salassapitosäännöt ja asiakirjojen käyttöoikeudet sen sallivat. Käsittele yhteenvetoja, muistiinpanoja ja tekoälychatin vastauksia samoilla käyttöoikeuksien hallintatoimilla kuin alkuperäistä asiakirjaa.