ИИ-суммаризатор PDF извлекает или считывает содержимое PDF и превращает его в краткие резюме, ключевые моменты, заметки и ответы со ссылками на источники. Оптимальный рабочий процесс учитывает PDF с текстовым слоем, отсканированные PDF, качество OCR, ссылки на страницы, конфиденциальность и повторное использование, чтобы отчёты, научные работы, руководства и материалы для подготовки к встречам становились знаниями, а не статичными файлами.
Попробуйте HiNoter для загрузки разрешённых PDF и превращения их в резюме, заметки, ключевые моменты, материалы для подготовки к встречам и чаты с ИИ со ссылками на источники.
Что такое ИИ-суммаризатор PDF?
ИИ-суммаризатор PDF — это программное обеспечение, которое считывает содержимое PDF и создаёт сокращённую версию важной информации. Он может суммировать отчёты, научные работы, экспортированные презентации, руководства, конспекты занятий, внутренние политики, договоры, материалы встреч и другие документы. Базовый инструмент создаёт краткое резюме. Более продвинутый рабочий процесс создаёт резюме разделов, ключевые моменты, учебные заметки, материалы для подготовки к встречам, вопросы и чат на основе источника.
Важно понимать, что PDF — это контейнер, а не всегда чистый текст. Некоторые PDF содержат обычный текстовый слой. Другие представляют собой отсканированные изображения страниц. В некоторых сочетаются текст, изображения, таблицы, сноски, колонки, аннотации и диаграммы. Прежде чем ИИ сможет точно суммировать PDF, инструмент должен извлечь пригодное для использования содержимое и сохранить достаточно контекста источника для проверки.
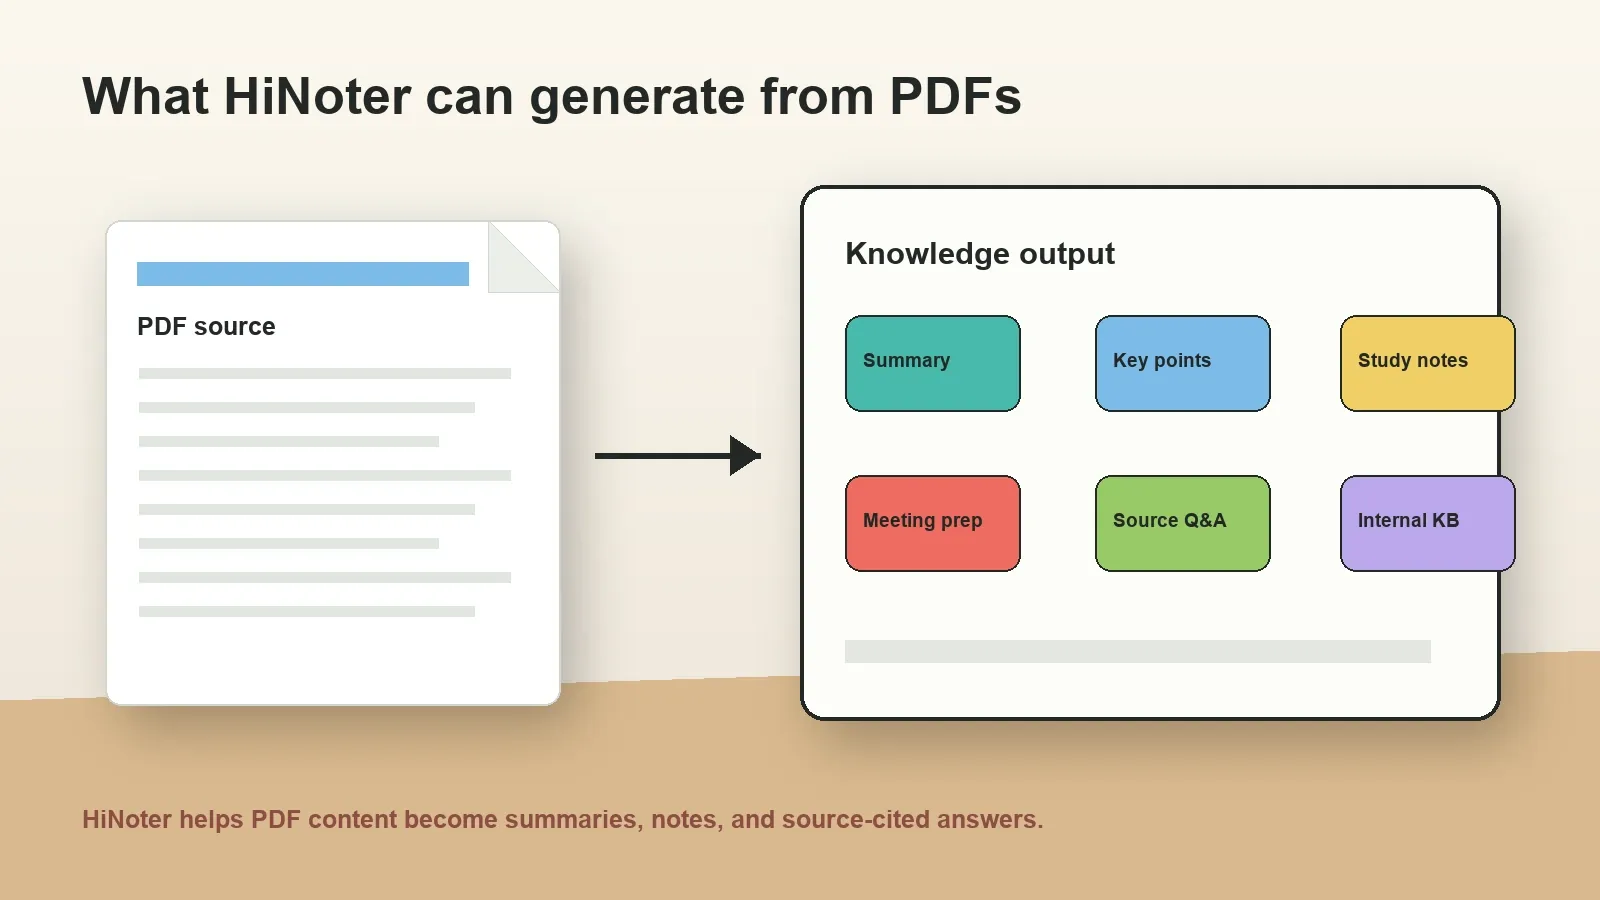
HiNoter полезен, когда цель — превратить PDF в знания. Он может помочь извлечь или использовать содержимое PDF, суммировать разделы, определить ключевые моменты, создать исследовательские заметки или заметки для встреч и позволить пользователям задавать вопросы о документе с указанием источников.
Определения: OCR, преобразование PDF в текст, суммирование PDF и чат по PDF на основе источника
OCR означает оптическое распознавание символов. OCR распознаёт текст внутри изображений или отсканированных страниц и преобразует его в машиночитаемый текст. При суммировании PDF OCR часто служит связующим звеном между документом, содержащим только изображения, и текстовым источником, готовым для суммирования.
Преобразование PDF в текст означает извлечение текста из PDF. Если PDF уже имеет текстовый слой, извлечение может быть относительно прямым. Если PDF отсканирован, извлечение часто зависит от OCR. В любом случае извлечённый текст может потребовать очистки, если в документе есть колонки, таблицы, сноски, заголовки страниц и иллюстрации.
Суммирование PDF означает превращение извлечённого содержимого PDF в краткое объяснение того, что важно. В результате может получиться резюме для руководства, резюме раздела, краткая сводка в виде маркированного списка, учебное пособие, заметка для подготовки к встрече или список рисков, выводов и дальнейших действий.
Чат по PDF на основе источника означает задавание вопросов о PDF и получение ответов, связанных со страницами, разделами или фрагментами источника. Это помогает пользователям проверять утверждения, а не доверять общему ответу ИИ, не связанному с документом.
PDF с текстовым слоем и отсканированные PDF
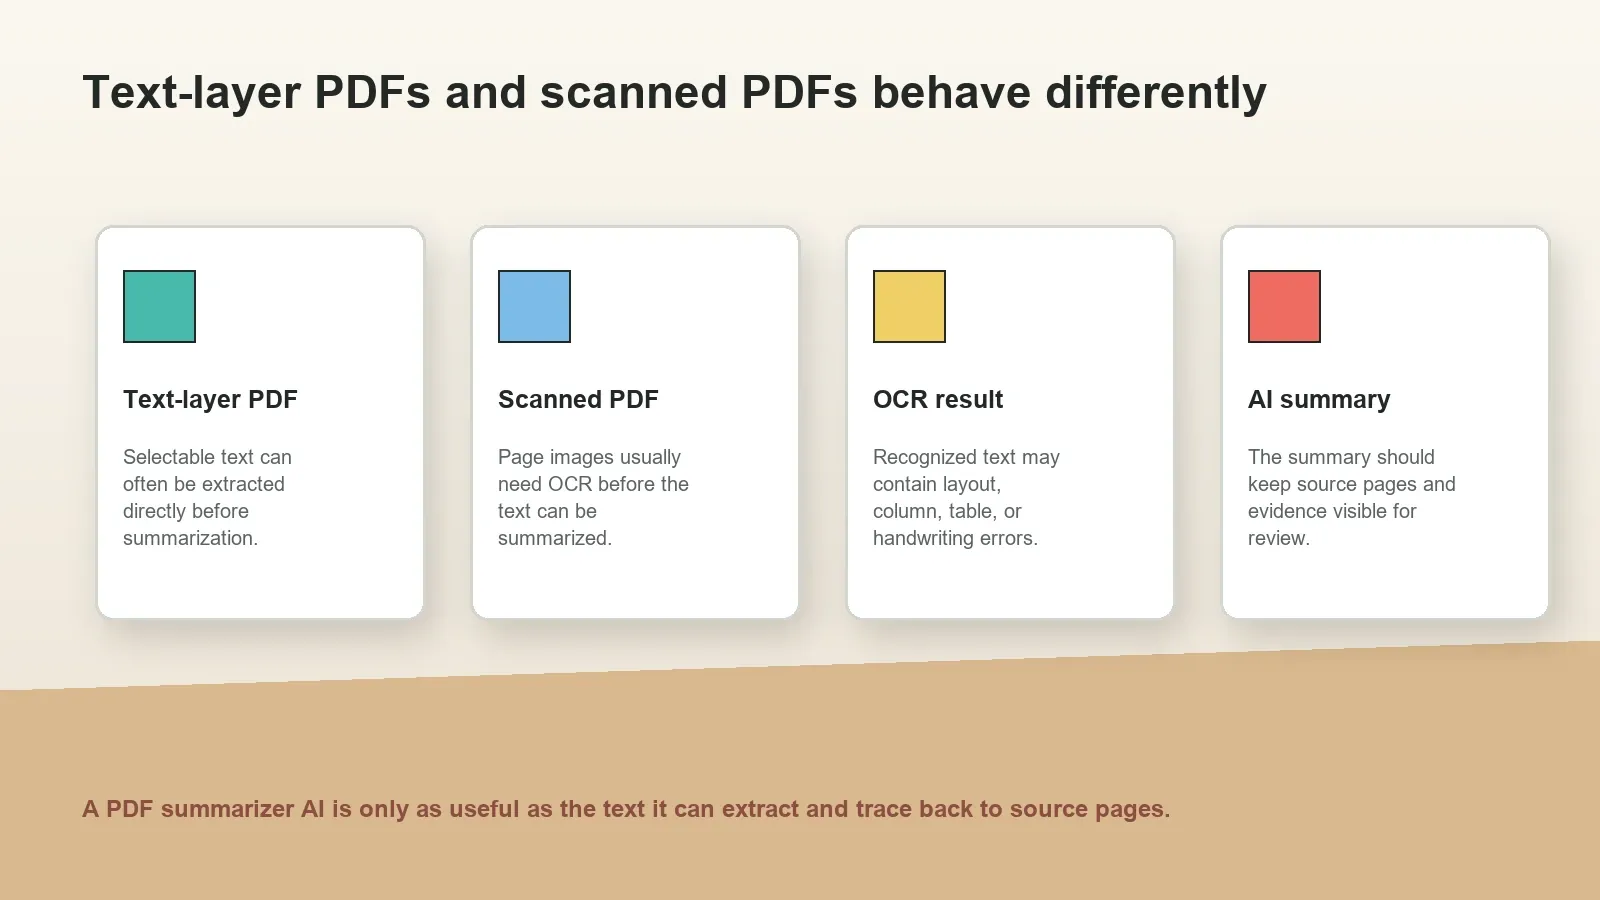
PDF с текстовым слоем и отсканированные PDF работают по-разному. PDF с текстовым слоем содержит выделяемый текст. Обычно из него можно копировать слова, выполнять поиск или программно извлекать текст. Отсканированный PDF обычно представляет собой набор изображений страниц. Для человека он может выглядеть читаемым, но инструменту может потребоваться OCR, прежде чем он сможет искать или суммировать слова.
В документации Adobe Acrobat OCR описывается как способ распознавания текста в отсканированных документах, благодаря которому получившийся PDF становится доступным для поиска и редактирования. Именно поэтому OCR важен для суммирования с помощью ИИ: если слова недоступны для машинного чтения, у ИИ может не быть надёжного текста для суммирования.
| Тип PDF | Как он работает | Оптимальный рабочий процесс | Распространённое ограничение |
|---|---|---|---|
| PDF с текстовым слоем | Текст обычно можно выделять, искать и извлекать | Извлечь текст, сохранить ссылки на страницы, суммировать по разделам | Таблицы, колонки, сноски и иллюстрации всё равно могут извлекаться некорректно |
| Отсканированный PDF | Страницы имеют вид изображений и могут не содержать выделяемого текста | Выполнить OCR, проверить распознанный текст, затем суммировать | OCR может неправильно распознавать низкокачественные сканы, рукописный текст, печати и макеты |
| Смешанный PDF | Некоторые страницы содержат текст, а другие являются сканами или изображениями | Извлечь текст там, где это возможно, и применить OCR к страницам-изображениям | Согласованность страниц и ссылки на источники требуют дополнительной проверки |
| Сложный PDF | Может содержать диаграммы, таблицы, колонки, формы, иллюстрации и аннотации | Суммировать разделы и вручную проверить важные доказательства | Визуальные данные и структура таблиц могут некорректно сохраняться при извлечении |
Как суммировать PDF с помощью ИИ
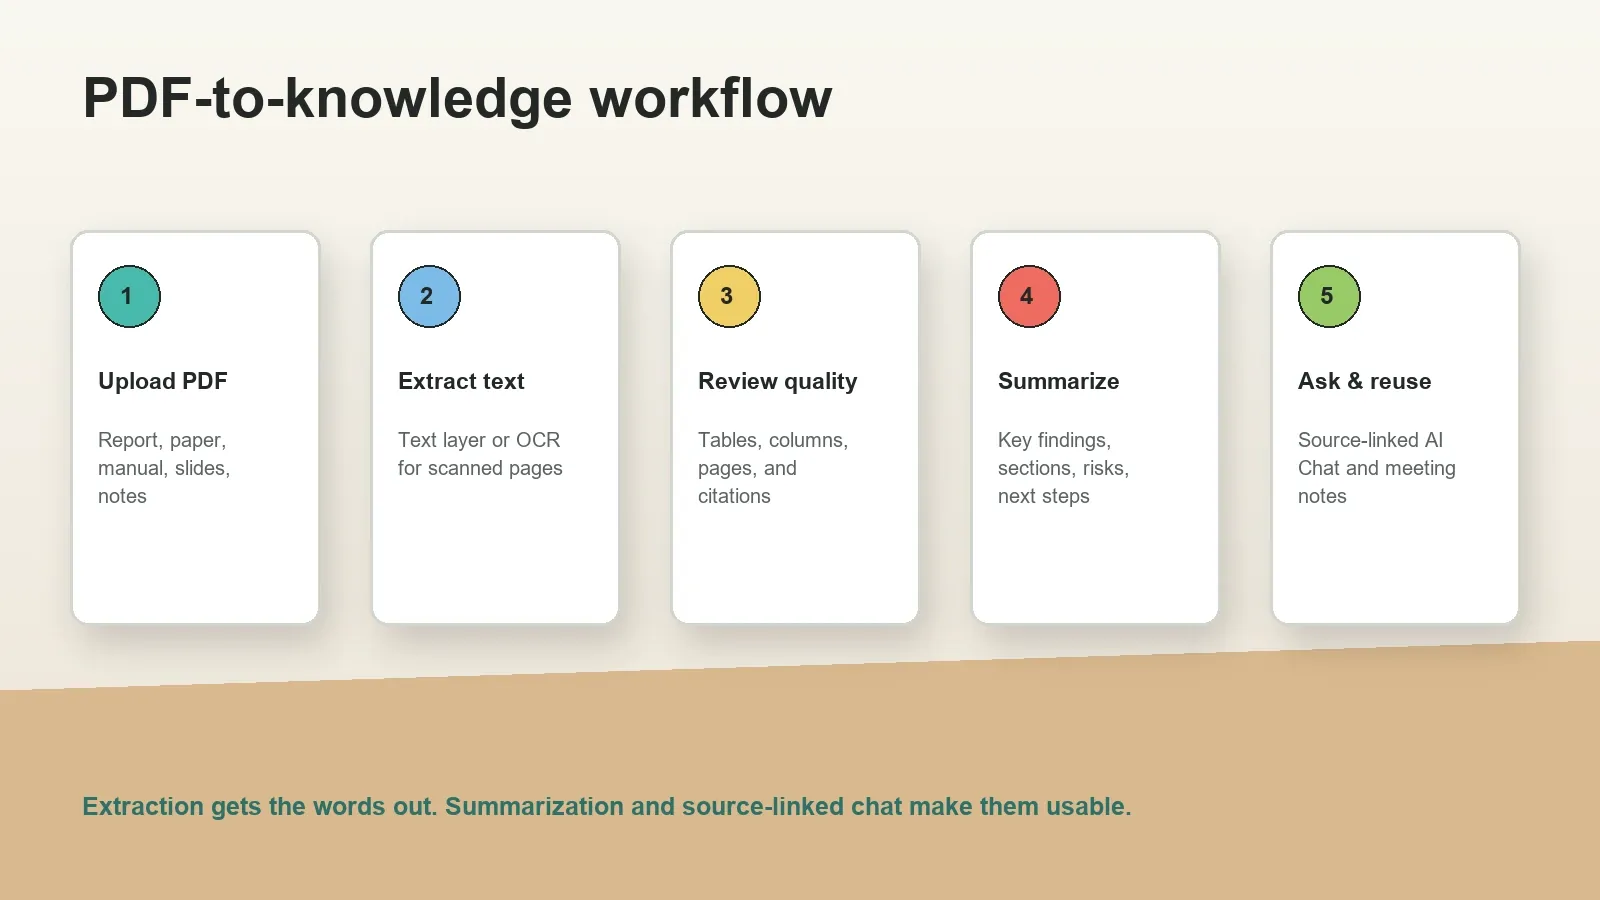
- Проверьте разрешение. Используйте только те PDF, которые ваша команда имеет право загружать, обрабатывать, суммировать, экспортировать или использовать для вопросов. Отчёты, научные работы, договоры, руководства и внутренние документы могут быть конфиденциальными.
- Определите тип PDF. Проверьте, содержит ли PDF выделяемый текст или страницы со сканированными изображениями. От этого зависит, будет ли первым шагом извлечение текста или OCR.
- Извлеките или распознайте текст. Используйте текстовый слой, если он доступен. Применяйте OCR для отсканированных страниц или PDF, состоящих только из изображений. По возможности сохраняйте номера страниц, заголовки и порядок разделов.
- Проверьте качество извлечения. Проверьте порядок страниц, колонки, таблицы, уравнения, сноски, диаграммы, цитаты, колонтитулы, рукописный текст и повёрнутые страницы. Исправьте очевидные проблемы, прежде чем полагаться на резюме.
- Создайте резюме. В зависимости от цели читателя создайте резюме для руководства, резюме разделов, ключевые выводы, риски, определения, исследовательские заметки или краткий материал для подготовки к встрече.
- Задавайте вопросы со ссылками на источники. Используйте чат с ИИ, чтобы спрашивать о доказательствах, рекомендациях, определениях, противоречиях и дальнейших действиях. Сохраняйте видимыми ссылки на страницы или разделы.
- Экспортируйте ответственно. Делитесь только теми резюме, заметками или ответами, которые разрешено распространять. Применяйте к резюме и чату с ИИ те же ограничения доступа, что и к исходному PDF.
Распространённые случаи ошибок при извлечении из PDF
Многие пользователи ожидают, что ИИ-суммаризатор PDF будет работать как обычный суммаризатор текста. Это возможно только тогда, когда документ достаточно качественный. PDF могут быть визуально читаемыми, но при этом сложными для разбора программным обеспечением. Инструмент может прочитать колонки в неправильном порядке, пропустить заголовки таблиц, проигнорировать сноски, объединить колонтитулы с основным текстом или не заметить текст внутри изображений.
Отсканированные PDF-файлы добавляют ещё один уровень риска. Качество OCR зависит от разрешения скана, контрастности, поворота страницы, шума изображения, языка, шрифтов, рукописного текста, штампов и наличия сложной структуры страницы. Даже хороший результат OCR может неправильно распознать числа, юридические ссылки, научные символы или названия продуктов.
| Случай ошибки | Что может пойти не так | Как снизить риск |
|---|---|---|
| Двухколоночная структура | Абзацы могут быть прочитаны в неправильном порядке | Проверьте порядок разделов перед обобщением научных статей |
| Таблицы | Связь между заголовками и ячейками может быть утрачена | Сверьте числа, строки и столбцы с PDF-файлом |
| Отсканированные страницы | OCR может неправильно распознать слова, имена или символы | Используйте качественные сканы и вручную проверьте важные разделы |
| Диаграммы и рисунки | Визуальные данные не всегда автоматически преобразуются в текст | Добавляйте примечания или проверяйте рисунки, если выводы зависят от визуальных данных |
| Сноски и цитаты | Ссылки могут оказаться отделены от утверждений | Сохраняйте видимыми ссылки на страницы и контекст цитирования |
| Формы и договоры | Флажки, поля и пункты могут извлекаться непоследовательно | Проверяйте юридические документы и рабочие материалы перед передачей сводок |
Как HiNoter превращает PDF-файлы в многоразовые знания
HiNoter следует использовать как рабочий процесс преобразования PDF в знания, а не только как конвертер PDF. Первый уровень — извлечение содержимого: текст из PDF или OCR, если этого требует документ. Второй уровень — понимание: сводки, ключевые моменты, заметки по разделам, открытые вопросы, учебные заметки и подготовка к встречам. Третий уровень — поиск: AI Chat с привязкой к источникам, который помогает пользователю задавать вопросы и отслеживать ответы до исходного документа.
Для научной статьи HiNoter может помочь определить исследовательский вопрос, методы, результаты, ограничения, определения, цитаты и открытые вопросы. Для отчёта он может подготовить резюме для руководства, риски, рекомендации, показатели и вопросы заинтересованных сторон. Для пакета материалов к встрече он может превратить статичный документ в краткий план подготовки с решениями, которые нужно принять, вопросами, которые нужно задать, и последующими действиями.
Это естественным образом связано с более широким рабочим процессом HiNoter. Команды могут объединять заметки встреч с ИИ, преобразование аудио в текст, заметки по видео и PDF-файлы в единый процесс работы со знаниями, учитывающий источники. Вместо того чтобы разрозненно хранить идеи в файлах и личных заметках, пользователи могут задавать вопросы по нескольким источникам и проверять, откуда взялся каждый ответ.
Варианты использования: отчёты, исследования, подготовка к встречам, конспекты занятий и внутренние знания
Отчёты часто содержат результаты, диаграммы, рекомендации и разделы о рисках, которые занятым командам некогда читать полностью. ИИ для создания сводок PDF может подготовить резюме для руководства, выделить наиболее важные показатели, определить риски и составить список вопросов для заинтересованных сторон перед встречей.
Научные статьи требуют более тщательной структуры. Хорошая сводка должна отдельно рассматривать аннотацию, исследовательский вопрос, методы, набор данных, результаты, ограничения и цитаты. Она не должна приписывать статье большую степень уверенности, чем в ней содержится. Вопросы с привязкой к источникам полезны, поскольку читатели могут узнать, где именно статья подтверждает утверждение.
Подготовка к встрече — один из самых ценных рабочих процессов. Вместо чтения длинного пакета PDF-файлов за несколько минут до звонка пользователь может создать краткий план подготовки: о чём говорится в документе, какое решение требуется, какие вопросы задать, какие риски важны и какие последующие действия могут понадобиться после встречи.
Конспекты занятий и учебные материалы полезны благодаря определениям, примерам, учебным вопросам, структурам интеллект-карт и вопросам и ответам с привязкой к источникам. Студент может попросить документ объяснить концепцию, но перед тем как полагаться на ответ при выполнении задания или подготовке к экзамену, всё же должен проверить страницы источника.
Повторное использование внутренних знаний превращает PDF-файлы из статичных документов в доступную для поиска память. Руководства, документы для адаптации, политики, описания продуктов и исследования клиентов могут стать сводками и ответами с привязкой к источникам, помогая командам не задавать одни и те же вопросы снова и снова.
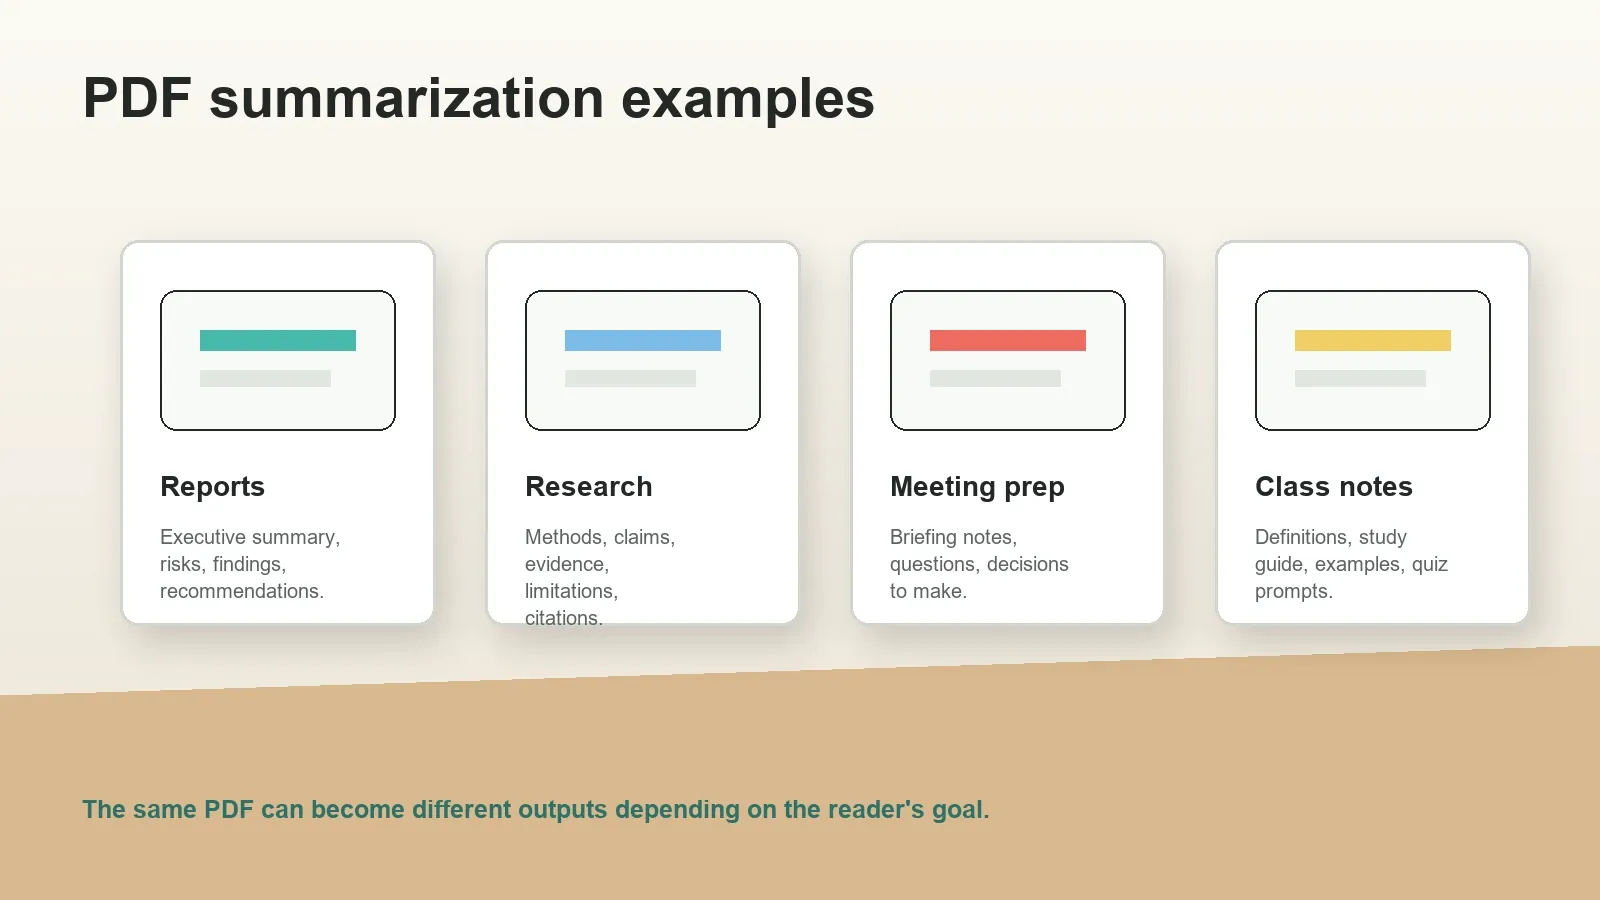
| Вариант использования | Примеры PDF | Полезный результат | Рабочий процесс HiNoter |
|---|---|---|---|
| Отчёты | Рыночные отчёты, исследования клиентов, квартальные обновления | Резюме для руководства, риски, показатели, рекомендации | Задавайте вопросы с привязкой к источникам перед стратегическими встречами |
| Исследования | Научные статьи, обзоры литературы, технические исследования | Методы, результаты, ограничения, заметки с учётом цитат | Создавайте учебные заметки и вопросы и ответы на основе доказательств |
| Подготовка к встрече | Материалы для совета директоров, проектные брифы, документы отдела продаж | Краткий обзор решений, вопросы, задачи, риски | Превращайте PDF-файлы в заметки перед встречей и последующие задачи |
| Конспекты занятий | PDF-файлы лекций, экспортированные слайды, материалы для чтения | Определения, примеры, вопросы для викторины, учебное руководство | Создавайте учебный процесс с привязкой к источникам |
| Внутренние знания | Руководства, политики, документы для адаптации, спецификации продуктов | Доступные для поиска сводки, ответы, многоразовые заметки | Объединяйте PDF-файлы с заметками встреч, аудио и видео |
Примеры чата с PDF с привязкой к источникам
Чат с PDF с привязкой к источникам полезен, когда пользователь не знает, на какой странице находится ответ. Вместо чтения всего отчёта пользователь может задавать точечные вопросы и проверять контекст источника, прежде чем доверять ответу.
| Вопрос | Полезный ответ | Ссылка на источник для проверки |
|---|---|---|
| Каковы три главных риска в этом отчёте? | Ранжированные риски с краткими пояснениями | Раздел о рисках и ссылки на страницы |
| Что мне подготовить перед встречей? | Точки принятия решений, вопросы и необходимый контекст | Резюме для руководства, рекомендации, приложение |
| Какие доказательства подтверждают основной вывод? | Ключевые данные, примеры или цитируемые утверждения | Таблицы, методология, страницы с результатами, цитаты |
| Что изменилось по сравнению с предыдущей версией? | Краткое описание обновлённых предположений или рекомендаций | Примечания к редакции, изменённые разделы, исходные страницы |
| Составь последующее сообщение на основе этого PDF. | Краткое резюме, решения, которые нужно принять, и следующие действия | Разделы, подтверждающие каждую задачу или утверждение |
Шаблон резюме PDF для копирования
Полезное резюме PDF должно быть достаточно структурированным, чтобы им можно было поделиться, но не настолько сжатым, чтобы читатель потерял контекст. Для отчётов, исследований, политик, руководств и материалов к встречам лучший шаблон обычно представляет собой не один абзац. Это многоуровневый брифинг, который позволяет занятому читателю сначала просмотреть ответ, а затем при необходимости изучить подробности и источники.
Используйте этот шаблон при создании резюме PDF с помощью ИИ. Он позволяет сделать резюме практичным для подготовки к встречам, обновлений для команды, анализа исследований и повторного использования внутренних знаний.
| Раздел | Что включить | Почему это важно |
|---|---|---|
| Ответ в одной строке | Главный вывод в одном предложении | Помогает читателям решить, стоит ли продолжать чтение |
| Резюме для руководства | От пяти до восьми пунктов, охватывающих самые важные моменты | Превращает длинный PDF в краткий материал, которым можно быстро поделиться |
| Ключевые доказательства | Утверждения, показатели, примеры, ссылки на страницы или цитируемые разделы | Позволяет читателям проверить важные утверждения по исходному документу |
| Риски и ограничения | Неясные предположения, отсутствующие данные, слабые доказательства или операционные риски | Не позволяет резюме звучать более уверенно, чем сам PDF |
| Вопросы для обсуждения | Открытые вопросы для встречи, обзора, занятия или обсуждения с заинтересованными сторонами | Переводит PDF от пассивного чтения к активному принятию решений |
| Следующие действия | Задачи, ответственные, сроки или последующие документы, если они доступны | Связывает понимание документа с реальными результатами рабочего процесса |
В HiNoter этот шаблон может стать повторяемым рабочим процессом. Пользователь может загрузить разрешённый PDF, создать краткое резюме, запросить подтверждающие доказательства для каждого пункта, а затем экспортировать брифинг в рабочее пространство, где команда уже работает. Резюме также можно сопоставить с заметками встречи, чтобы предварительно изучаемый PDF и обсуждение на встрече оставались связанными, а не превращались в отдельные файлы.
Запросы к ИИ для подготовки к встрече по PDF
ИИ для создания резюме PDF особенно полезен перед встречами, поскольку превращает длинный предварительный материал в план обсуждения. Цель не в том, чтобы заменить чтение при работе с важными вопросами. Цель — определить разделы, заслуживающие внимания, вопросы, требующие ответов, и решения, которые нельзя откладывать.
Попробуйте такие запросы при использовании HiNoter или другого рабочего процесса с учётом источников для подготовки к встрече:
- Сделай резюме этого PDF для 15-минутной встречи с заинтересованными сторонами и перечисли решения, которые нам нужно принять.
- Извлеки риски, нерешённые вопросы и предположения, которые следует обсудить непосредственно на встрече.
- Преврати этот отчёт в информационную записку для руководителя, который не читал полный документ.
- Перечисли утверждения, требующие проверки по источнику, и укажи для каждого ссылку на страницу или раздел.
- Создай на основе этого PDF план последующих действий с задачами, возможными ответственными и зависимостями.
- Сравни рекомендации в этом PDF с заметками нашей последней встречи.
Эти запросы работают, потому что требуют результата, а не только сокращённой версии документа. Общее резюме сообщает, что содержит PDF. Резюме для подготовки к встрече сообщает, что читатель должен понять, спросить, решить или сделать дальше.
Как оценивать ответы чата по PDF со ссылками на источники
Ссылки на источники не делают ответ ИИ автоматически правильным, но упрощают его проверку. Пользователь должен иметь возможность понять, откуда взялся ответ, проверить, подтверждает ли указанная страница утверждение, и выяснить, не пропустила ли модель важный контекст. Это особенно важно для научных статей, договоров, финансовых отчётов, технических руководств и PDF с нормативными документами.
| Проверка | Хороший признак | Предупреждающий признак |
|---|---|---|
| Охват источников | В ответе указаны соответствующий раздел, страница, таблица или приложение | Ответ звучит уверенно, но не указывает расположение источника |
| Сила утверждения | В ответе используется осторожная формулировка, если в PDF есть неопределённость | Ответ превращает слабые доказательства в убедительную рекомендацию |
| Числа и имена | Показатели, даты, имена и определения совпадают с PDF | Ошибки OCR или извлечения изменяют важные детали |
| Контекст | В ответе объясняется связанное с утверждением предположение или ограничение | В ответе цитируется положение без условия, при котором оно действует |
| Практическая применимость | В ответе разделены факты, решения, вопросы и задачи | Резюме, мнение и последующие действия смешаны в одном расплывчатом абзаце |
HiNoter создан для такой практики проверки. Пользователи могут задавать вопросы о PDF, просматривать подтверждающую ссылку и сохранять связь ответа с источником. Такой подход со ссылками на источники снижает риск галлюцинаций, поскольку рабочий процесс поощряет проверку, а не восприятие результата ИИ как окончательного авторитетного ответа.
Обычный конвертер PDF, ИИ для создания резюме и HiNoter
Многие инструменты для работы с PDF звучат похоже, но решают разные задачи. Конвертер PDF извлекает содержимое. Инструмент для создания резюме PDF сжимает содержимое. Рабочий процесс преобразования PDF в базу знаний помогает использовать содержимое на встречах, в исследованиях, заметках и последующей работе.
| Рабочий процесс | Лучше всего подходит для | Типичный результат | Ограничение |
|---|---|---|---|
| Простой конвертер PDF | Извлечения текста из файла | Необработанный текст, документ Word или скопированный текст | Не определяет, что важно и что делать дальше |
| Базовый ИИ-суммаризатор PDF | Создания сокращённой версии одного документа | Резюме в виде абзаца или списка | Может не содержать ссылок на источники, пунктов действий или возможностей повторного использования в работе |
| Универсальный ИИ-чат с загруженным PDF | Быстрого получения ответов на вопросы о документе | Ответы и краткие объяснения | Качество зависит от извлечения данных, ограничений контекста и опоры на источник |
| Рабочий процесс HiNoter PDF-to-knowledge | Превращения разрешённых к обработке PDF в заметки, материалы для подготовки, ответы и многоразово используемые знания | Резюме, ключевые моменты, материалы для подготовки к встрече, AI Chat с привязкой к источникам, экспорт и связанные заметки | Пользователям по-прежнему необходимо проверять важные утверждения и соблюдать разрешения на использование документов |
Когда не следует использовать ИИ для работы с PDF
Бывают случаи, когда правильным решением будет не загружать PDF, пока не будут прояснены разрешения и меры контроля. Не используйте ИИ-суммаризатор PDF, если документ содержит конфиденциальную информацию, которую вам не разрешено обрабатывать, если договор или политика запрещают обработку третьими сторонами, если PDF содержит персональные данные, требующие особого обращения, или если ситуация требует официальной юридической, медицинской, финансовой проверки или проверки на соответствие требованиям.
В таких случаях используйте одобренные внутренние системы, обратитесь за рекомендациями к владельцу документа или создайте краткое содержание вручную в контролируемой среде. ИИ всё ещё может оказаться полезным позже, но только после того, как будет решён вопрос управления данными. Хороший рабочий процесс с ИИ-суммаризатором PDF должен явно обозначать эту границу, а не скрывать её за удобной кнопкой загрузки.
Вопросы конфиденциальности и безопасности
PDF могут содержать конфиденциальную информацию, даже если выглядят обычными. Договоры, презентации для совета директоров, политики для сотрудников, финансовые отчёты, медицинские документы, юридические записки, исследования клиентов и внутренние спецификации продуктов требуют осторожного обращения. Перед загрузкой PDF в любой ИИ-суммаризатор убедитесь, что обработка документа разрешена вашими договорами, внутренними политиками, требованиями безопасности и обязательствами по конфиденциальности.
Применяйте к резюме, заметкам, экспортированным материалам и ответам AI Chat меры контроля доступа столь же тщательно, как и к исходному PDF. Краткое резюме может быстрее раскрыть наиболее конфиденциальную часть документа, чем сам документ. Для регулируемой или конфиденциальной работы определите требования к хранению, удалению, распространению и аудиту до использования любого рабочего процесса с ИИ-суммаризатором PDF.
Проверка качества перед распространением резюме PDF
Используйте этот список перед отправкой резюме PDF коллеге, руководителю, учебной группе или клиенту. Во-первых, убедитесь, что PDF разрешено обрабатывать с помощью ИИ. Во-вторых, проверьте, является ли документ отсканированным или содержит текстовый слой. В-третьих, проверьте качество извлечения таблиц, страниц, цитат и чисел. В-четвёртых, убедитесь, что в резюме отдельно представлены факты, интерпретация, рекомендации и следующие шаги. В-пятых, сохраняйте видимыми ссылки на страницы для важных утверждений.
Если PDF содержит юридические, медицинские, финансовые, академические или технические сведения, не полагайтесь только на резюме. Используйте резюме как навигационный слой и изучите источник перед принятием решений. Это особенно важно при использовании OCR, поскольку ошибки OCR могут привести к цепочке ошибок в резюме.
Готовы превратить PDF в рабочие знания? Используйте HiNoter для создания резюме разрешённых к обработке PDF, подготовки заметок к встречам, извлечения ключевых моментов и задания вопросов с привязкой к источнику по всем вашим документам.
Часто задаваемые вопросы
Что такое ИИ-суммаризатор PDF?
ИИ-суммаризатор PDF извлекает или считывает содержимое PDF и создаёт сокращённое резюме важной информации. Надёжный рабочий процесс также может создавать ключевые моменты, учебные заметки, материалы для подготовки к встречам, ответы с привязкой к источникам и многоразово используемые знания из отчётов, научных работ, руководств, презентаций и внутренних документов.
Может ли ИИ суммировать отсканированные PDF?
Да, но для отсканированных PDF обычно сначала требуется OCR. OCR преобразует изображения страниц в машиночитаемый текст. Распознанный текст следует проверять, поскольку сканы, рукописный текст, низкая контрастность, колонки, таблицы и повёрнутые страницы могут приводить к ошибкам.
Что такое OCR при создании резюме PDF?
OCR, или оптическое распознавание символов, — это процесс распознавания текста внутри изображения или на отсканированной странице. При создании резюме PDF OCR часто требуется до того, как ИИ сможет суммировать отсканированный PDF как текст.
В чём разница между отсканированным PDF и PDF с текстовым слоем?
PDF с текстовым слоем содержит выделяемый текст, который часто можно извлечь напрямую. Отсканированный PDF обычно представляет собой набор изображений страниц, поэтому перед поиском, копированием, созданием резюме или использованием для вопросов с привязкой к источнику ему требуется OCR.
Может ли HiNoter взаимодействовать с PDF в формате чата?
HiNoter может работать как рабочий процесс PDF-to-knowledge: извлекать или использовать содержимое PDF, создавать резюме и заметки и позволять пользователям задавать вопросы с привязкой к источнику о документе, если обработка PDF разрешена.
Что следует проверить, прежде чем доверять резюме PDF?
Проверьте, есть ли в PDF надёжный текстовый слой или результат OCR, правильно ли извлечены таблицы и сноски, сохранены ли ссылки на страницы и соответствуют ли важные утверждения, числа и цитаты источнику.
Как командам обеспечивать конфиденциальность при использовании ИИ-суммаризатора PDF?
Загружайте, суммируйте, экспортируйте PDF или взаимодействуйте с ними в чате только в том случае, если это разрешено договорами, внутренними политиками, правилами конфиденциальности и разрешениями на использование документов. Применяйте к резюме, заметкам и ответам AI Chat те же меры контроля доступа, что и к исходному документу.