AI for PDF-oppsummering henter ut eller leser PDF-innhold og gjør det om til kortere sammendrag, hovedpunkter, notater og kildehenviste svar. Den beste arbeidsflyten håndterer PDF-er med tekstlag, skannede PDF-er, OCR-kvalitet, sidereferanser, personvern og gjenbruk, slik at rapporter, artikler, håndbøker og dokumenter til møteforberedelser blir til kunnskap i stedet for statiske filer.
Prøv HiNoter for å laste opp tillatte PDF-er og gjøre dem om til sammendrag, notater, hovedpunkter, møteforberedelser og kildehenvist AI Chat.
Hva er AI for PDF-oppsummering?
AI for PDF-oppsummering er programvare som leser innholdet i en PDF og lager en kortere versjon av den viktigste informasjonen. Den kan oppsummere rapporter, forskningsartikler, eksporterte presentasjoner, håndbøker, klassenotater, interne retningslinjer, kontrakter, møteunderlag og andre dokumenter. Et enkelt verktøy lager et kort sammendrag. En mer avansert arbeidsflyt lager sammendrag av deler, hovedpunkter, studienotater, møteforberedelser, spørsmål og kildeforankret chat.
Det viktige skillet er at en PDF er en beholder, ikke alltid ren tekst. Noen PDF-er inneholder et normalt tekstlag. Andre er skannede bilder av sider. Noen kombinerer tekst, bilder, tabeller, fotnoter, spalter, merknader og diagrammer. Før AI kan oppsummere en PDF nøyaktig, må verktøyet hente ut brukbart innhold og bevare nok kildekontekst til gjennomgang.
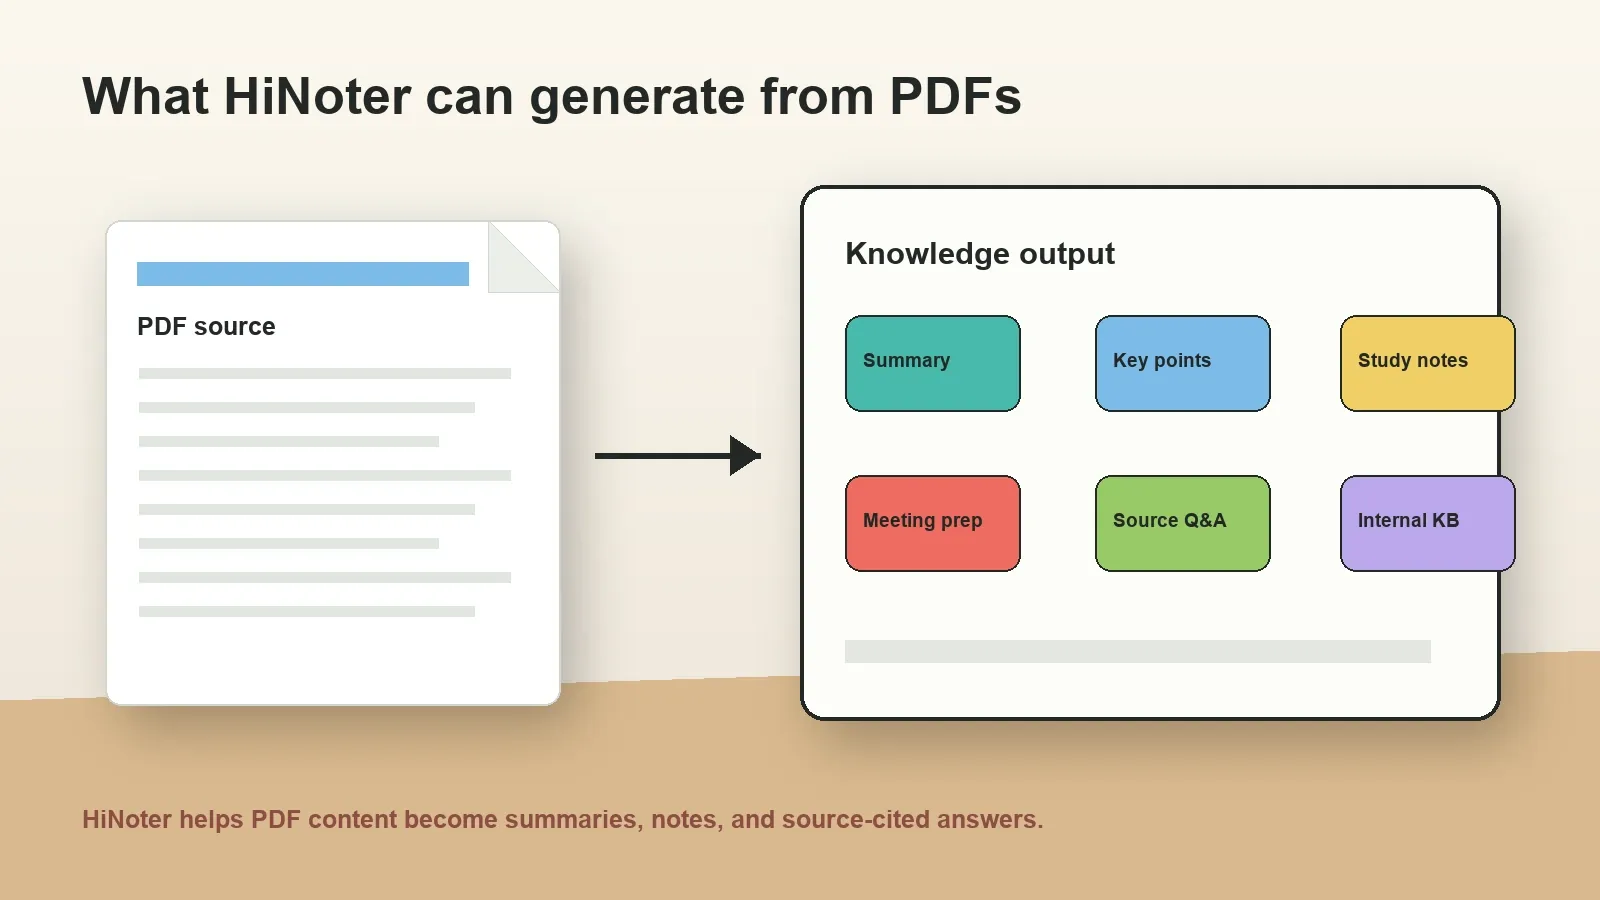
HiNoter er nyttig når målet er å gjøre PDF-er om til kunnskap. Det kan bidra til å hente ut eller bruke PDF-innhold, oppsummere deler, identifisere hovedpunkter, lage forsknings- eller møtenotater og la brukere stille kildehenviste spørsmål om dokumentet.
Definisjoner: OCR, PDF-til-tekst, PDF-oppsummering og kildeforankret PDF-chat
OCR betyr optisk tegngjenkjenning. OCR gjenkjenner tekst i bilder eller skannede sider og konverterer den til maskinlesbar tekst. Ved PDF-oppsummering er OCR ofte forbindelsen mellom et dokument som bare består av bilder, og en tekstkilde som er klar for oppsummering.
PDF-til-tekst betyr å hente ut tekst fra en PDF. Hvis PDF-en allerede har et tekstlag, kan uthentingen være relativt direkte. Hvis PDF-en er skannet, avhenger uthentingen ofte av OCR. Uansett kan den uthentede teksten fortsatt trenge opprydding når spalter, tabeller, fotnoter, topptekster og figurer er involvert.
PDF-oppsummering betyr å gjøre uthentet PDF-innhold om til en kortere forklaring av det som er viktig. Det kan gi et sammendrag for ledelsen, et delvis sammendrag, en punktvis oversikt, en studieguide, et møtenotat eller en liste over risikoer, funn og tiltak.
Kildeforankret PDF-chat betyr å stille spørsmål om en PDF og få svar som er knyttet til kildesider, deler eller utdrag. Dette hjelper brukere med å kontrollere påstander i stedet for å stole på et generisk AI-svar som ikke er knyttet til dokumentet.
PDF-er med tekstlag kontra skannede PDF-er
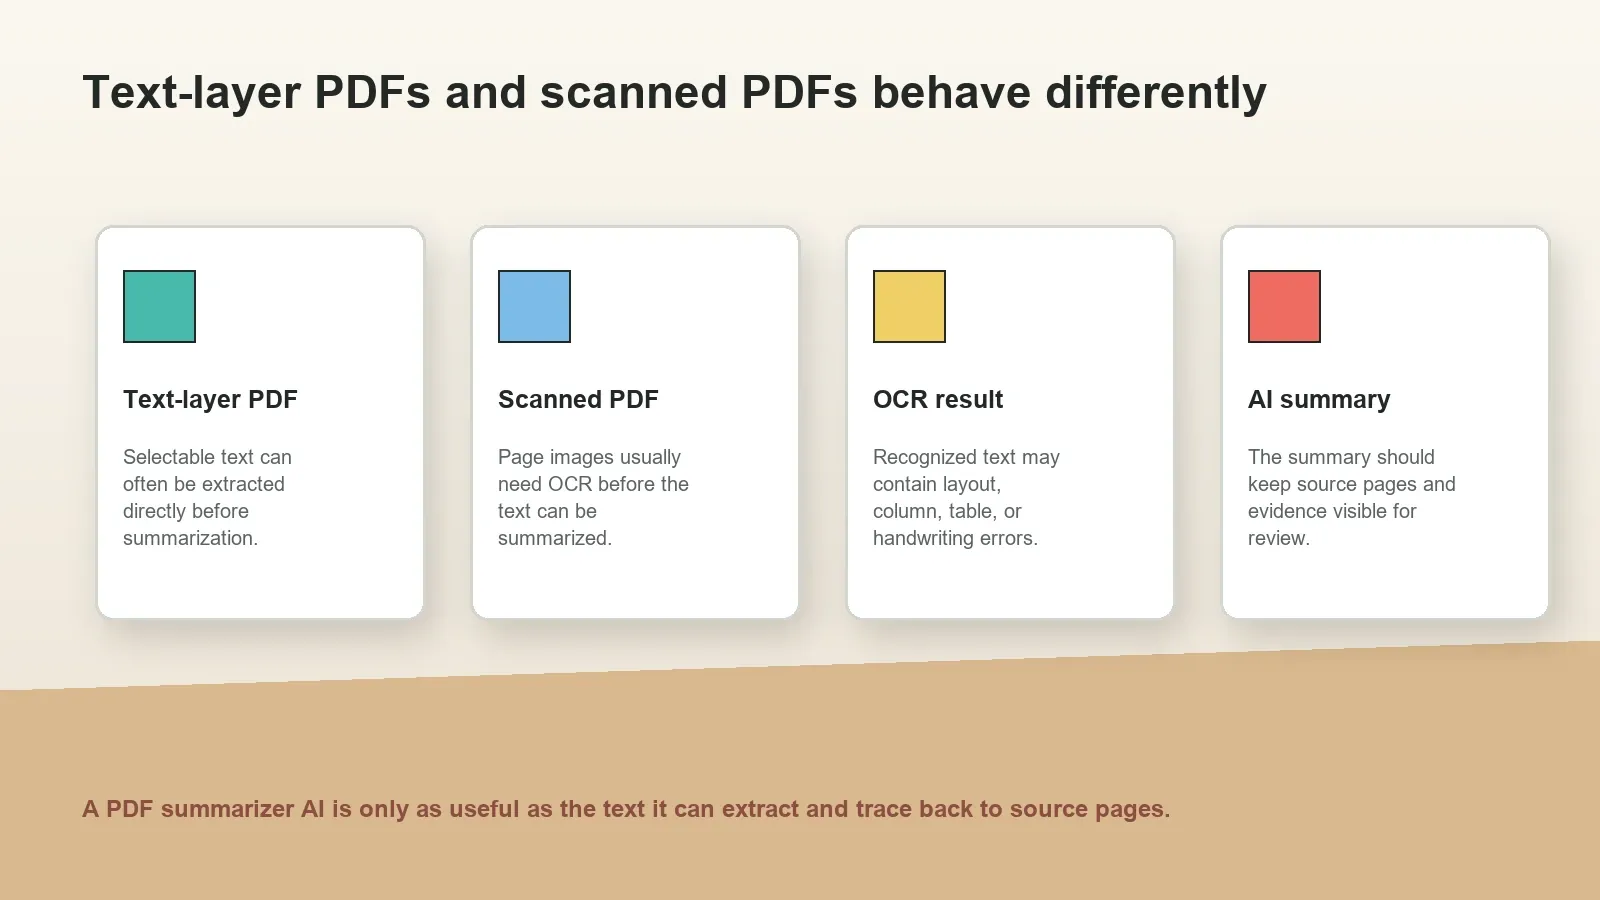
PDF-er med tekstlag og skannede PDF-er fungerer forskjellig. En PDF med tekstlag inneholder tekst som kan merkes. Du kan ofte kopiere ord fra den, søke i den eller hente ut teksten programmatisk. En skannet PDF består vanligvis av et sett med sidebilder. Den kan se lesbar ut for et menneske, men et verktøy kan trenge OCR før det kan søke etter eller oppsummere ordene.
Adobes Acrobat-dokumentasjon beskriver OCR som en metode for å gjenkjenne tekst i skannede dokumenter, slik at den resulterende PDF-en blir søkbar og redigerbar. Det er den praktiske grunnen til at OCR er viktig for AI-oppsummering: Hvis ordene ikke er maskinlesbare, har AI-en kanskje ikke pålitelig tekst å oppsummere.
| PDF-type | Hvordan den fungerer | Beste arbeidsflyt | Vanlig begrensning |
|---|---|---|---|
| PDF med tekstlag | Tekst kan ofte merkes, søkes i og hentes ut | Hent ut tekst, bevar sidereferanser, oppsummer etter del | Tabeller, spalter, fotnoter og figurer kan fortsatt hentes ut på en dårlig måte |
| Skannet PDF | Sider er bildelignende og har kanskje ikke tekst som kan merkes | Kjør OCR, gjennomgå den gjenkjente teksten, og oppsummer deretter | OCR kan feiltolke skanninger med lav kvalitet, håndskrift, stempler og oppsett |
| Blandet PDF | Noen sider har tekst, mens andre er skanninger eller bilder | Hent ut tekst der det er mulig, og bruk OCR på bildesider | Sidekonsistens og kildehenvisninger krever ekstra gjennomgang |
| Kompleks PDF | Kan inneholde diagrammer, tabeller, spalter, skjemaer, figurer og merknader | Oppsummer deler og gjennomgå viktige bevis manuelt | Visuelle data og tabellstruktur overlever kanskje ikke uthentingen på en ryddig måte |
Slik oppsummerer du en PDF med AI
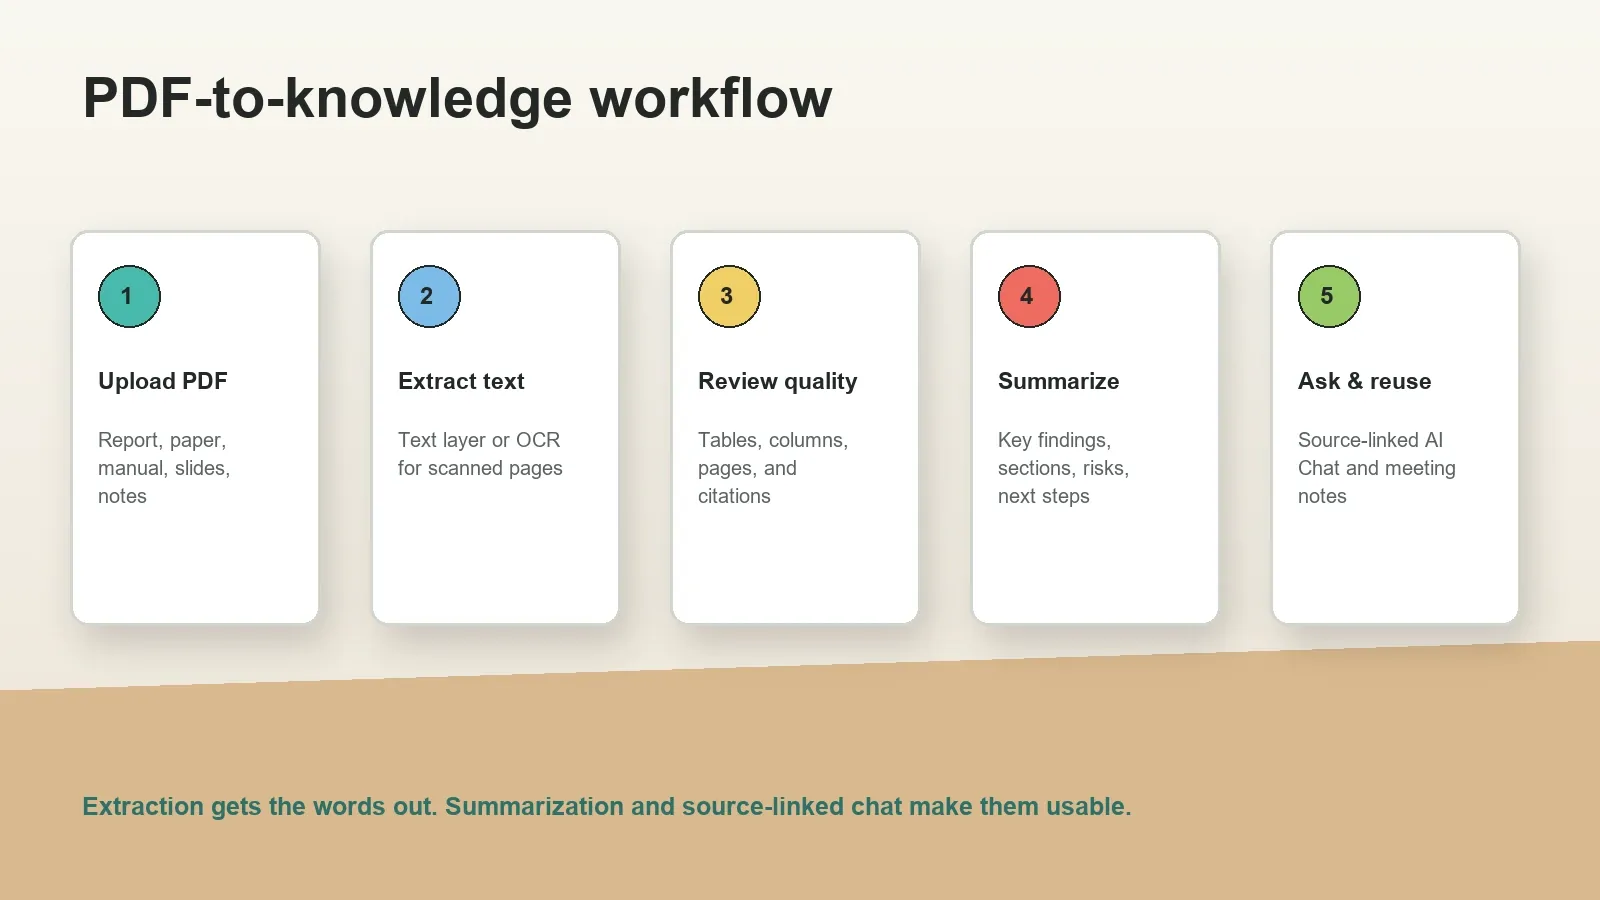
- Bekreft tillatelsen. Bruk bare PDF-er som teamet ditt har tillatelse til å laste opp, behandle, oppsummere, eksportere eller stille spørsmål om. Rapporter, artikler, kontrakter, håndbøker og interne dokumenter kan være sensitive.
- Identifiser PDF-typen. Kontroller om PDF-en har tekst som kan merkes, eller skannede bildesider. Dette avgjør om det første trinnet er tekstuthenting eller OCR.
- Hent ut eller gjenkjenn teksten. Bruk tekstlaget når det er tilgjengelig. Bruk OCR for skannede sider eller PDF-er som bare består av bilder. Bevar sidetall, overskrifter og rekkefølgen på delene når det er mulig.
- Kontroller kvaliteten på uthentingen. Sjekk siderekkefølge, spalter, tabeller, ligninger, fotnoter, diagrammer, sitater, topptekster, håndskrift og roterte sider. Rett opp åpenbare problemer før du stoler på sammendraget.
- Lag sammendraget. Lag et sammendrag for ledelsen, sammendrag av deler, hovedfunn, risikoer, definisjoner, forskningsnotater eller en kort møteforberedelse, avhengig av leserens mål.
- Still kildehenviste spørsmål. Bruk AI Chat til å spørre om bevis, anbefalinger, definisjoner, motsigelser og neste tiltak. Sørg for at side- eller delreferanser er synlige.
- Eksporter på en ansvarlig måte. Del bare sammendraget, notatene eller svarene som tillatelsene dine omfatter. Bruk tilgangskontroller for sammendrag og AI Chat på samme måte som for den opprinnelige PDF-en.
Vanlige tilfeller der PDF-uthenting mislykkes
Mange brukere forventer at AI for PDF-oppsummering skal fungere som en vanlig tekstoppsummerer. Det fungerer bare når dokumentet er tilstrekkelig ryddig. PDF-er kan være visuelt lesbare, men fortsatt vanskelige for programvare å tolke. Et verktøy kan lese spalter i feil rekkefølge, utelate tabelloverskrifter, ignorere fotnoter, slå sammen topptekster med brødteksten eller overse tekst i bilder.
Skannede PDF-filer introduserer et nytt risikolag. OCR-kvaliteten avhenger av skanneoppløsning, kontrast, siderotasjon, bildestøy, språk, skrifttyper, håndskrift, stempler og hvorvidt siden har et komplekst oppsett. Selv et godt OCR-resultat kan feiltolke tall, juridiske referanser, vitenskapelige symboler eller produktnavn.
| Feiltilfelle | Hva som kan gå galt | Slik reduserer du risikoen |
|---|---|---|
| To-spalters oppsett | Avsnitt kan bli lest i feil rekkefølge | Gå gjennom rekkefølgen på delene før du oppsummerer forskningsartikler |
| Tabeller | Overskrifter og celler kan miste sammenhengen | Kontroller tall, rader og kolonner mot PDF-filen |
| Skannede sider | OCR kan feiltolke ord, navn eller symboler | Bruk tydelige skanninger og gjennomgå kritiske deler manuelt |
| Diagrammer og figurer | Visuelle data blir kanskje ikke automatisk konvertert til tekst | Legg til notater eller undersøk figurer når konklusjonene avhenger av visuelle elementer |
| Fotnoter og sitater | Referanser kan bli løsrevet fra påstandene | Hold sidereferanser og sitatkontekst synlige |
| Skjemaer og kontrakter | Avmerkingsbokser, felt og klausuler kan hentes ut på en inkonsekvent måte | Gå gjennom juridiske eller operative dokumenter før du deler sammendrag |
Slik gjør HiNoter PDF-filer om til gjenbrukbar kunnskap
HiNoter bør brukes som en arbeidsflyt fra PDF til kunnskap, ikke bare som en PDF-konverterer. Det første laget er innholdsekstraksjon: tekst fra PDF-filen, eller OCR når dokumentet krever det. Det andre laget er forståelse: sammendrag, hovedpunkter, notater for deler, åpne spørsmål, studienotater og møteforberedelser. Det tredje laget er gjenfinning: kildekoblet AI Chat som hjelper brukeren med å stille spørsmål og spore svarene tilbake til dokumentet.
For en forskningsartikkel kan HiNoter bidra til å identifisere forskningsspørsmålet, metodene, funnene, begrensningene, definisjonene, sitatene og åpne spørsmål. For en rapport kan den produsere et sammendrag for ledelsen, risikoer, anbefalinger, måltall og spørsmål fra interessenter. For en møtepakke kan den gjøre et statisk dokument om til en forberedelsesoversikt med beslutninger som må tas, spørsmål som bør stilles og oppfølgingshandlinger.
Dette henger naturlig sammen med HiNoters bredere arbeidsflyt. Team kan kombinere AI-møtenotater, lyd til tekst, videonotater og PDF-filer i én kildebevisst kunnskapsprosess. I stedet for å spre innsikter på tvers av filer og private notater kan brukere stille spørsmål på tvers av kilder og kontrollere hvor hvert svar kommer fra.
Bruksområder: rapporter, forskning, møteforberedelser, klassenotater og intern kunnskap
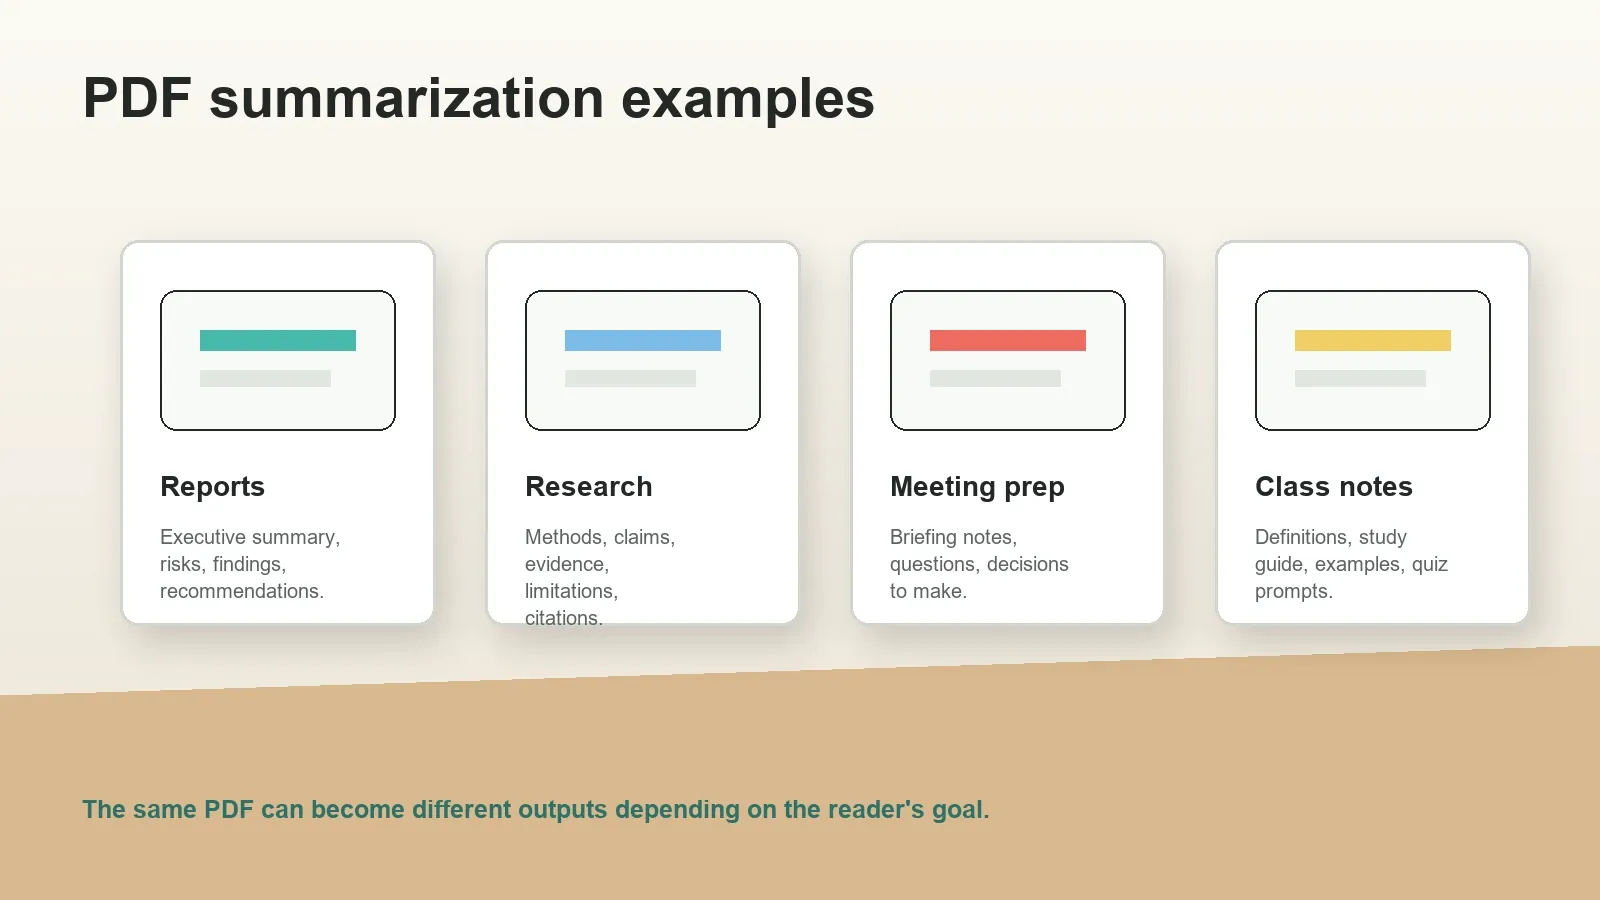
Rapporter inneholder ofte funn, diagrammer, anbefalinger og risikodeler som travle team ikke har tid til å lese i sin helhet. AI for PDF-oppsummering kan lage et sammendrag for ledelsen, fremheve de viktigste måltallene, identifisere risikoer og liste spørsmål fra interessenter før et møte.
Forskningsartikler krever en mer nøyaktig struktur. Et godt sammendrag bør skille mellom sammendrag, forskningsspørsmål, metoder, datasett, funn, begrensninger og sitater. Det bør ikke fremstille større sikkerhet enn det artikkelen gir grunnlag for. Kildekoblede spørsmål er nyttige fordi leserne kan spørre hvor artikkelen underbygger en påstand.
Møteforberedelser er en av arbeidsflytene med høyest verdi. I stedet for å lese en lang PDF-pakke minutter før en samtale kan en bruker generere en forberedelsesoversikt: hva dette dokumentet sier, hva som krever en beslutning, hvilke spørsmål som bør stilles, hvilke risikoer som er viktige og hvilken oppfølging som kan være nødvendig etter møtet.
Klassenotater og studiemateriell drar nytte av definisjoner, eksempler, studiespørsmål, tankekartoversikter og kildekoblede spørsmål og svar. En student kan be dokumentet om å forklare et konsept, men bør fortsatt kontrollere kildesidene før svaret brukes som grunnlag for en oppgave eller eksamen.
Gjenbruk av intern kunnskap gjør PDF-filer om fra statiske dokumenter til søkbar hukommelse. Håndbøker, introduksjonsdokumenter, retningslinjer, produktbeskrivelser og kundeundersøkelser kan bli til sammendrag og kildekoblede svar som hjelper team med å unngå å stille de samme spørsmålene gjentatte ganger.
| Bruksområde | Eksempler på PDF-filer | Nyttig resultat | HiNoter-arbeidsflyt |
|---|---|---|---|
| Rapporter | Markedsrapporter, kundeundersøkelser, kvartalsoppdateringer | Sammendrag for ledelsen, risikoer, måltall, anbefalinger | Still kildekoblede spørsmål før strategimøter |
| Forskning | Artikler, litteraturgjennomganger, tekniske studier | Metoder, funn, begrensninger, sitatbevisste notater | Lag studienotater og evidensbaserte spørsmål og svar |
| Møteforberedelser | Styrepakker, prosjektbeskrivelser, salgsdokumenter | Beslutningsoversikt, spørsmål, tiltak, risikoer | Gjør PDF-filer om til notater før møtet og oppfølgingsoppgaver |
| Klassenotater | Forelesnings-PDF-filer, lysbildeeksporter, lesestoff | Definisjoner, eksempler, quizoppgaver, studieguide | Bygg en kildekoblet studiearbeidsflyt |
| Intern kunnskap | Håndbøker, retningslinjer, introduksjonsdokumenter, produktspesifikasjoner | Søkbare sammendrag, svar, gjenbrukbare notater | Koble PDF-filer sammen med møte-, lyd- og videonotater |
Eksempler på kildekoblet PDF Chat
Kildekoblet PDF Chat er nyttig når en bruker ikke vet hvilken side som inneholder svaret. I stedet for å lese en hel rapport kan brukeren stille målrettede spørsmål og undersøke kildekonteksten før svaret stoles på.
| Spørsmål | Nyttig svar | Kildehenvisning som bør undersøkes |
|---|---|---|
| Hva er de tre største risikoene i denne rapporten? | Rangert oversikt over risikoer med korte forklaringer | Risikodelen og sidehenvisninger |
| Hva bør jeg forberede før møtet? | Beslutningspunkter, spørsmål og nødvendig kontekst | Sammendrag, anbefalinger, vedlegg |
| Hvilke bevis støtter hovedfunnet? | Viktige datapunkter, eksempler eller kildebelagte påstander | Tabeller, metoder, resultatsider, kildehenvisninger |
| Hva er endret siden forrige versjon? | Sammendrag av oppdaterte antakelser eller anbefalinger | Revisjonsnotater, endrede deler, kildesider |
| Skriv et oppfølgingsnotat basert på denne PDF-en. | Kort oppsummering, beslutninger som må tas og neste tiltak | Deler som støtter hver oppgave eller påstand |
PDF-sammendragsmal som kan kopieres
Et nyttig PDF-sammendrag bør være strukturert nok til å kunne deles, men ikke så komprimert at leseren mister konteksten. For rapporter, forskning, retningslinjer, håndbøker og møtepakker er den beste malen vanligvis ikke ett enkelt avsnitt. Det er en lagdelt kortversjon som lar en travel leser skanne svaret først og deretter undersøke detaljer og kilder ved behov.
Bruk denne malen når du oppsummerer en PDF med AI. Den holder sammendraget praktisk for møteforberedelser, teamoppdateringer, gjennomgang av forskning og intern gjenbruk av kunnskap.
| Del | Hva som bør inkluderes | Hvorfor det er viktig |
|---|---|---|
| Svar i én linje | Hovedpoenget i én setning | Hjelper leserne med å avgjøre om de skal lese videre |
| Sammendrag | Fem til åtte punkter som dekker de viktigste poengene | Gjør en lang PDF om til en kortversjon som raskt kan deles |
| Viktige bevis | Påstander, måltall, eksempler, sidehenvisninger eller siterte deler | Lar leserne kontrollere viktige utsagn mot kilden |
| Risikoer og begrensninger | Uklare antakelser, manglende data, svake bevis eller operasjonell risiko | Hindrer at sammendraget virker sikrere enn PDF-en |
| Spørsmål som bør stilles | Åpne spørsmål til et møte, en gjennomgang, en undervisningstime eller en diskusjon med interessenter | Flytter PDF-en fra passiv lesing til aktiv beslutningstaking |
| Neste tiltak | Oppgaver, ansvarlige, frister eller oppfølgingsdokumenter når dette er tilgjengelig | Knytter dokumentforståelse til reelle arbeidsflytresultater |
I HiNoter kan denne malen bli til en repeterbar arbeidsflyt. En bruker kan laste opp en tillatt PDF, generere et kort sammendrag, be om dokumentasjonen bak hvert punkt og deretter eksportere kortversjonen til arbeidsområdet der teamet allerede jobber. Sammendraget kan også kombineres med møtenotater, slik at en PDF som er lest på forhånd og møtediskusjonen forblir koblet sammen i stedet for å bli separate filer.
Ledetekster for møteforberedelser med PDF-oppsummerings-AI
PDF-oppsummerings-AI er spesielt nyttig før møter fordi den gjør en lang forhåndsgjennomgang om til en diskusjonsplan. Målet er ikke å erstatte lesing i arbeid med høy risiko. Målet er å identifisere delene som fortjener oppmerksomhet, spørsmålene som trenger svar, og beslutningene som ikke kan utsettes.
Prøv ledetekster som disse når du bruker HiNoter eller en annen kildebevisst arbeidsflyt for møteforberedelser:
- Oppsummer denne PDF-en for et 15-minutters møte med interessenter, og list opp beslutningene vi må ta.
- Hent ut risikoene, de uavklarte spørsmålene og antakelsene som bør diskuteres i møtet.
- Gjør denne rapporten om til et orienteringsnotat for en leder som ikke har lest hele dokumentet.
- List opp påstandene som trenger kildeverifisering, og vis side- eller delhenvisningen for hver av dem.
- Lag en oppfølgingsplan basert på denne PDF-en med tiltak, mulige ansvarlige og avhengigheter.
- Sammenlign anbefalingene i denne PDF-en med møtenotatene fra den forrige diskusjonen vår.
Disse ledetekstene fungerer fordi de ber om et resultat, ikke bare en kortere versjon av dokumentet. Et generisk sammendrag sier hva PDF-en inneholder. Et sammendrag for møteforberedelser sier hva leseren bør forstå, spørre om, beslutte eller gjøre videre.
Slik vurderer du kildekoblede svar fra PDF-chat
Kildehenvisninger gjør ikke et AI-svar automatisk korrekt, men de gjør svaret enklere å kontrollere. Brukeren bør kunne undersøke hvor svaret kom fra, om den angitte siden støtter påstanden, og om modellen hoppet over viktig kontekst. Dette er spesielt viktig for forskningsartikler, kontrakter, finansielle rapporter, tekniske håndbøker og PDF-er med retningslinjer.
| Kontrollpunkt | Godt tegn | Varseltegn |
|---|---|---|
| Kildedekning | Svaret viser til relevant del, side, tabell eller vedlegg | Svaret er selvsikkert, men viser ikke til et kildested |
| Styrken på påstanden | Svaret bruker forsiktig språk når PDF-en er usikker | Svaret gjør svake bevis om til en sterk anbefaling |
| Tall og navn | Måltall, datoer, navn og definisjoner samsvarer med PDF-en | OCR- eller uttrekksfeil endrer viktige detaljer |
| Kontekst | Svaret forklarer den omkringliggende antakelsen eller begrensningen | Svaret siterer et poeng uten betingelsen som fulgte med det |
| Handlingsrettethet | Svaret skiller mellom fakta, beslutninger, spørsmål og oppgaver | Svaret blander sammendrag, mening og oppfølging i ett vagt avsnitt |
HiNoter er utformet for denne gjennomgangsvanen. Brukere kan stille spørsmål om PDF-en, undersøke den underliggende kilden og holde svaret koblet til kilden. Dette kildekoblede mønsteret reduserer risikoen for hallusinasjoner fordi arbeidsflyten oppmuntrer til verifisering i stedet for å behandle AI-resultatet som en endelig autoritet.
Vanlig PDF-konverterer kontra AI-oppsummerer kontra HiNoter
Mange PDF-verktøy høres like ut, men de løser ulike problemer. En PDF-konverterer trekker ut innhold. En PDF-oppsummerer komprimerer innhold. En arbeidsflyt fra PDF til kunnskap hjelper en person med å bruke innholdet på tvers av møter, forskning, notater og oppfølgingsarbeid.
| Arbeidsflyt | Best for | Typisk resultat | Begrensning |
|---|---|---|---|
| Enkel PDF-konverterer | Å hente ut tekst fra en fil | Råtekst, Word-dokument eller kopiert tekst | Avgjør ikke hva som er viktig eller hva du bør gjøre videre |
| Enkel AI for PDF-oppsummering | Å lage en kortere versjon av ett dokument | Avsnittsoppsummering eller punktliste | Kan mangle kildereferanser, handlingspunkter eller gjenbruk på tvers av arbeidet |
| Generisk AI-chat med opplastet PDF | Å stille raske spørsmål om et dokument | Svar og korte forklaringer | Kvaliteten avhenger av uthenting, kontekstbegrensninger og forankring i kilden |
| HiNoters PDF-til-kunnskap-arbeidsflyt | Å gjøre tillatte PDF-er om til notater, forberedelser, svar og gjenbrukbar kunnskap | Oppsummering, hovedpunkter, møteforberedelser, kildekoblet AI Chat, eksporter og tilkoblede notater | Brukere må fortsatt verifisere sensitive påstander og respektere dokumenttillatelser |
Når du ikke bør bruke AI på en PDF
Det finnes tilfeller der den riktige arbeidsflyten er å unngå å laste opp PDF-en til tillatelser og kontroller er avklart. Ikke bruk en AI for PDF-oppsummering når dokumentet inneholder konfidensiell informasjon du ikke har tillatelse til å behandle, når en kontrakt eller policy hindrer behandling av tredjeparter, når PDF-en inneholder personopplysninger som krever særskilt håndtering, eller når det som står på spill krever formell juridisk, medisinsk, økonomisk eller regulatorisk gjennomgang.
I slike tilfeller bør du bruke internt godkjente systemer, be dokumenteieren om veiledning eller lage en manuell oppsummering i det kontrollerte miljøet. AI kan fortsatt være nyttig senere, men først etter at spørsmålet om datastyring er avklart. En god AI-arbeidsflyt for PDF-oppsummering bør gjøre denne grensen synlig i stedet for å skjule den bak en praktisk opplastingsknapp.
Personvern- og sikkerhetshensyn
PDF-er kan inneholde sensitiv informasjon selv når de ser alminnelige ut. Kontrakter, styrepresentasjoner, personalpolicyer, økonomiske rapporter, medisinske dokumenter, juridiske notater, kundeundersøkelser og interne produktspesifikasjoner krever alle forsiktig håndtering. Før du laster opp en PDF til en AI for oppsummering, må du bekrefte at dokumentet kan behandles i henhold til kontraktene, de interne retningslinjene, sikkerhetskravene og konfidensialitetsforpliktelsene dine.
Bruk tilgangskontroller for oppsummeringer, notater, eksporter og AI Chat-svar like nøye som du bruker dem for den opprinnelige PDF-en. En kort oppsummering kan avsløre den mest sensitive delen av et dokument raskere enn selve dokumentet. For regulert eller konfidensielt arbeid bør du definere forventninger til oppbevaring, sletting, deling og revisjon før du bruker en AI-arbeidsflyt for PDF-oppsummering.
Kvalitetssjekkliste før du deler en PDF-oppsummering
Bruk denne sjekklisten før du sender en PDF-oppsummering til en kollega, leder, studiegruppe eller kunde. Bekreft først at PDF-en er tillatt for AI-behandling. Sjekk deretter om dokumentet er skannet eller har et tekstlag. Gå så gjennom kvaliteten på uthentingen av tabeller, sider, sitater og tall. Bekreft til slutt at oppsummeringen skiller mellom fakta, tolkning, anbefalinger og neste steg. Sørg for at sidereferanser er synlige for viktige påstander.
Hvis PDF-en inneholder juridiske, medisinske, økonomiske, akademiske eller tekniske detaljer, må du ikke stole på oppsummeringen alene. Bruk oppsummeringen som et navigasjonslag, og gå gjennom kilden før du tar beslutninger. Dette er spesielt viktig når OCR ble brukt, fordi OCR-feil kan føre til flere feil i oppsummeringen.
Klar til å gjøre PDF-er om til arbeidskunnskap? Bruk HiNoter til å oppsummere tillatte PDF-er, lage notater til møteforberedelser, hente ut hovedpunkter og stille kildekoblede spørsmål på tvers av dokumentene dine.
Ofte stilte spørsmål
Hva er AI for PDF-oppsummering?
AI for PDF-oppsummering henter ut eller leser innhold fra PDF-er og lager en kortere oppsummering av den viktige informasjonen. En god arbeidsflyt kan også lage hovedpunkter, studienotater, møteforberedelser, kildekoblede svar og gjenbrukbar kunnskap fra rapporter, artikler, håndbøker, presentasjoner og interne dokumenter.
Kan AI oppsummere skannede PDF-er?
Ja, men skannede PDF-er trenger vanligvis OCR først. OCR konverterer sidebilder til maskinlesbar tekst. Den gjenkjente teksten bør gjennomgås fordi skanninger, håndskrift, lav kontrast, kolonner, tabeller og roterte sider kan føre til feil.
Hva er OCR i PDF-oppsummering?
OCR, eller optisk tegngjenkjenning, er prosessen med å gjenkjenne tekst i et bilde eller på en skannet side. Ved PDF-oppsummering er OCR ofte nødvendig før AI kan oppsummere en skannet PDF som tekst.
Hva er forskjellen mellom en skannet PDF og en PDF med tekstlag?
En PDF med tekstlag inneholder tekst som kan markeres, og som ofte kan hentes ut direkte. En skannet PDF består vanligvis av et sett med sidebilder, så den trenger OCR før teksten kan søkes i, kopieres, oppsummeres eller brukes til kildekoblede spørsmål.
Kan HiNoter chatte med en PDF?
HiNoter kan fungere som en PDF-til-kunnskap-arbeidsflyt ved å hente ut eller bruke PDF-innhold, lage oppsummeringer og notater og la brukere stille kildekoblede spørsmål om dokumentet når PDF-en er tillatt for behandling.
Hva bør jeg sjekke før jeg stoler på en PDF-oppsummering?
Sjekk om PDF-en har et pålitelig tekstlag eller OCR-resultat, om tabeller og fotnoter ble hentet ut riktig, om sidereferanser er bevart, og om viktige påstander, tall og sitater samsvarer med kilden.
Hvordan bør team håndtere personvern med AI for PDF-oppsummering?
Last bare opp, oppsummer, eksporter eller chat med PDF-er når kontrakter, interne retningslinjer, konfidensialitetsregler og dokumenttillatelser tillater det. Behandle oppsummeringer, notater og AI Chat-svar med de samme tilgangskontrollene som originaldokumentet.