Конверторът на PDF в текст извлича четим текст от PDF файл, за да можете да го копирате, търсите, обобщавате и използвате повторно. При сканирани PDF файлове OCR разчита текста от изображенията. HiNoter отива още по-далеч, като превръща извлеченото съдържание от PDF в обобщения, ключови точки, бележки за подготовка за срещи и отговори от AI Chat, свързани с източника.
Какво представлява конверторът на PDF в текст?
Конверторът на PDF в текст е софтуер, който взема съдържание, заключено в PDF файл, и го превръща в редактируем и достъпен за търсене текст. Задачата звучи лесно, докато не се сблъскате с реалните PDF файлове, които хората използват: сканирани договори, експортирани презентации, академични статии с бележки под линия, ръководства с колони, бордови отчети, пълни с таблици, и документи с много изображения, в които думите технически са част от картина.
За студент целта може да бъде извличане на основните идеи от научна статия. За продуктов мениджър това може да означава превръщане на клиентски отчет в материал за подготовка за среща. За правен, съпорт или оперативен екип целта може да бъде намиране на точното изречение, което отговаря на даден въпрос, без да се препрочитат петдесет страници. Извличането на необработен текст е полезно, но е само първата стъпка. Истинската стойност идва, когато извлеченото съдържание стане структурирано, обобщено, цитирано и готово за повторна употреба.
Тук HiNoter се вписва естествено. HiNoter е платформа за бележки от срещи и транскрипция с изкуствен интелект, но не се ограничава само до срещи. Екипите могат да я използват за обработка на PDF файлове, аудио, видео и разрешено онлайн съдържание в едно работно пространство. Един отчет може да се превърне в обобщение. Едно ръководство може да стане достъпна за търсене система от въпроси и отговори. PDF файл, използван преди среща, може да се превърне в бележки за подготовка, въпроси, рискове и последващи задачи.
Работен процес за конвертиране на PDF в текст: от статичен файл до полезни бележки
Най-ясният работен процес не се изчерпва с „качете PDF файл и копирайте текста“. По-добрият работен процес за PDF разделя извличането от разбирането. Първо инструментът установява дали документът съдържа избираем текст или изисква OCR. След това извлича съдържанието, запазва достатъчно структура, за да съхрани смисъла, и ви позволява да обобщите, отправите запитване или експортирате резултата.
| Стъпка | Какво се случва | Защо е важно |
|---|---|---|
| 1. Качете PDF файла | Добавете отчет, статия, ръководство, договор, презентация или учебен материал, който имате право да обработвате. | Изходният файл остава свързан с получените бележки и отговори. |
| 2. Определете типа на PDF файла | Системата проверява дали PDF файлът има текстов слой или се нуждае от OCR. | Различните типове PDF файлове изискват различни методи за извличане. |
| 3. Извлечете текста | Избираемият текст се извлича директно; сканираният текст се разчита чрез OCR. | Получавате съдържание, което може да се търси, копира, преглежда и обобщава. |
| 4. Почистете и структурирайте | Разделите, заглавията, таблиците, препратките и контекстът на страниците се запазват, когато е възможно. | Чистата структура намалява риска от неточни обобщения и разпокъсани бележки. |
| 5. Обобщавайте и задавайте въпроси | HiNoter създава обобщения, ключови точки, бележки за подготовка за срещи и отговори от AI Chat, свързани с източника. | PDF файлът се превръща в използваемо знание, а не просто в извлечен текст. |
Ако изграждате повтаряем процес за екипа, свържете работния процес за PDF с цялостната си система за бележки. Например екипи, които вече използват AI Chat за знания от срещи, могат да използват същия модел на задаване на въпроси, свързани с източника, и за съдържание от PDF файлове. Мениджър може да попита какво се е променило между два клиентски отчета. Студент може да попита за основния аргумент в дадена статия. Ръководител на съпорт екип може да попита къде в ръководството е обяснено правило за конфигурация.
OCR, PDF файлове с текстов слой и сканирани PDF файлове
Не всички PDF файлове съхраняват думите по един и същи начин. Някои PDF файлове включват реален текстов слой, което означава, че можете да избирате думи с курсора. Други са сканирани изображения или снимки на страници, което означава, че документът съдържа изображения, на които случайно е изобразен текст. Конверторът на PDF в текст трябва да обработва и двата типа, иначе резултатът ще изглежда ненадежден.
Какво е OCR?
OCR означава оптично разпознаване на символи. OCR разчита текст от изображение, сканиран документ или снимка и превръща видимите символи в машинночетим текст. Той е полезен за сканирани PDF файлове, снимани страници, по-стари формуляри, хартиени договори и експортирани презентации, базирани на изображения.
Качеството на OCR зависи от източника. Ясните сканирани документи, изправените страници, високият контраст, четливите шрифтове и минималното количество ръкописен текст дават по-добри резултати. Наклонените страници, изображенията с ниска резолюция, печатите, сенките, сложните таблици и смесените езици могат да създадат грешки. Добрият работен процес улеснява прегледа, вместо да се преструва, че всеки сканиран документ е перфектен.
Какво представлява PDF файлът с текстов слой?
PDF файлът с текстов слой вече съдържа машинночетим текст зад визуалното оформление. Обикновено можете да избирате, копирате и търсите думите във файла. PDF файловете с текстов слой често се създават чрез експортиране от Google Docs, Microsoft Word, инструменти за дизайн, платформи за отчети или системи за публикуване.
Тези файлове обикновено се конвертират по-лесно от сканираните документи, но и при тях има особености. Оформлението с няколко колони може да бъде извлечено в неправилен ред на четене. Горните и долните колонтитули могат да се повтарят. Таблиците могат да се разпаднат на объркващи фрагменти. Бележките под линия, цитатите и страничните полета могат да попаднат на места, които затрудняват четенето на извлечения текст. Затова полезният работен процес за PDF трябва да включва почистване, обобщения по раздели и проверка на източниците.
Сканирани PDF файлове срещу текстови PDF файлове: какво да очаквате
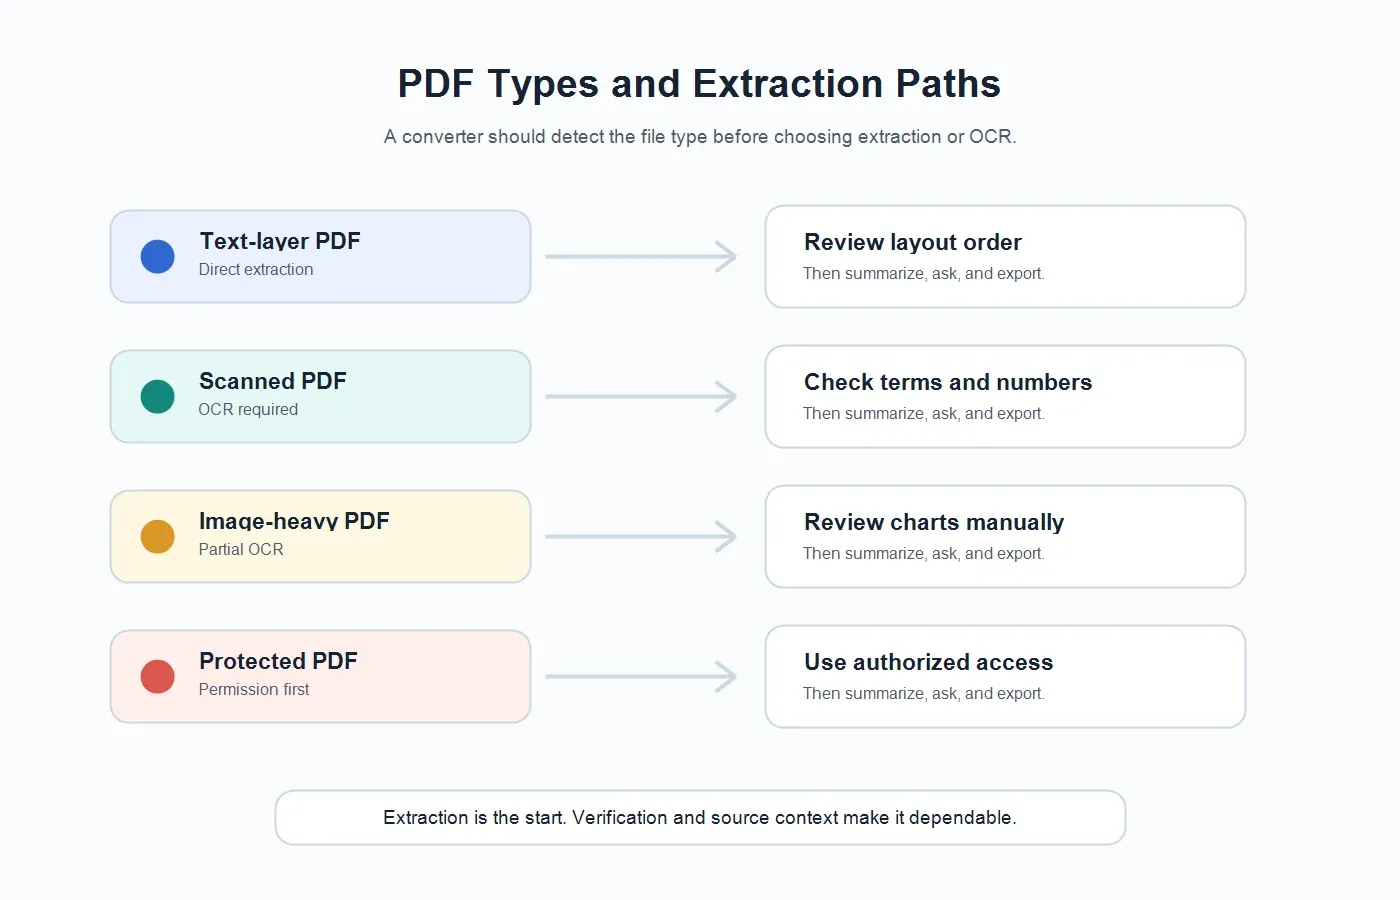
Преди да оцените даден конвертор, определете типа на PDF файла. Един и същ инструмент може да работи отлично с чист отчет с текстов слой и неубедително с фотографиран договор. Тази таблица представя практичен поглед върху обичайния резултат.
| Тип PDF файл | Как се намира текстът | Обичайно ограничение | Най-добър работен процес с HiNoter |
|---|---|---|---|
| PDF файл с текстов слой | Конверторът извлича вградения избираем текст. | Колоните, горните и долните колонтитули и таблиците могат да се появят в неправилен ред. | Извлечете текста, обобщете го по раздели и задайте въпроси, свързани с източника. |
| Сканиран PDF файл | OCR разчита думите от изображенията на страниците. | Точността зависи от качеството на сканирането, контраста, наклона и яснотата на шрифта. | Изпълнете OCR, прегледайте критичните термини и създайте бележки и ключови точки. |
| PDF файл с много изображения | Текстът може да е вграден в диаграми, екранни снимки или изображения на слайдове. | Диаграмите и схемите може да изискват човешки преглед за пълно разбиране. | Извлечете видимия текст, обобщете изложението и отбележете разделите с много визуално съдържание. |
| PDF файл, защитен с парола | Достъпът зависи от разрешенията и ограниченията на файла. | Някои файлове не могат да бъдат обработени, докато оторизиран потребител не ги отключи. | Използвайте само документи, до които имате законен достъп, след което обработете разрешения файл. |
| PDF файл с много таблици | Извличането на текст прочита клетките, етикетите и стойностите, когато е възможно. | Сложните таблици могат да загубят връзките между редовете и колоните. | Извлечете текста, прегледайте числата и задайте целеви въпроси с контекст от източника. |
Защо само извлеченият текст обикновено не е достатъчен
Много инструменти за PDF спират в момента, в който създадат текста. Това е полезно, ако единствената ви цел е да копирате цитат или да индексирате файл. По-малко полезно е, когато PDF файлът съдържа двадесет страници научни изследвания, подробен пазарен отчет, политически документ, договор или обучително ръководство. Все още трябва да прочетете извлечения текст, да прецените кое е важно, да намерите твърденията, които си струва да цитирате, и да превърнете документа в нещо, което екипът ви може да използва.
За служителите, работещи със знания, по-дълбокият проблем не е достъпът до думи. Това е сигналът. Кои раздели са важни? Какви са рисковете? Какви въпроси трябва да внесем в срещата? Кои твърдения се нуждаят от проверка? Какво се е променило спрямо предишната версия? Какво действие трябва да предприеме някой, след като прочете това?
HiNoter е полезен тук, защото третира текста от PDF като изходен материал за структурирано знание. PDF файлът може да се превърне в обобщение за ръководители, кратък изследователски доклад, набор от бележки за подготовка за среща, тематична карта или пространство за въпроси и отговори с възможност за търсене. Ако вече използвате HiNoter като работен процес за бележки от срещи с изкуствен интелект, обработката на PDF файлове става част от същия цикъл на управление на знанията, вместо отделна задача за документи.
PDF към текст срещу обобщение на PDF срещу чат с PDF
Тези резултати решават различни задачи. Необработеният препис на PDF файла не е същото като обобщение, а обобщението не е същото като отговор в чат, основан на източника. Екипите постигат по-добри резултати, когато изберат резултата, който съответства на решението, което трябва да вземат.
| Резултат | Какво ви предоставя | Най-подходяща употреба |
|---|---|---|
| Извлечен текст | Четимите думи от PDF файла, с почистване, когато е възможно. | Копиране на цитати, търсене в документа, архивиране на текст или подготовка на изходен файл. |
| Резюме на PDF файла | По-кратко обяснение на основните идеи, констатации, рискове или препоръки. | Бързо разбиране на отчет преди среща, занятие или преглед. |
| Основни точки | Ключови изводи, организирани по тема, раздел или значение за вземането на решения. | Информиране на ръководител, подготовка на екипен отчет или създаване на учебни бележки. |
| Бележки за подготовка на среща | Въпроси, точки от дневния ред, рискове и решения, предложени въз основа на съдържанието на PDF файла. | Превръщане на клиентски отчет, договор или научна статия във фокусирана дискусия. |
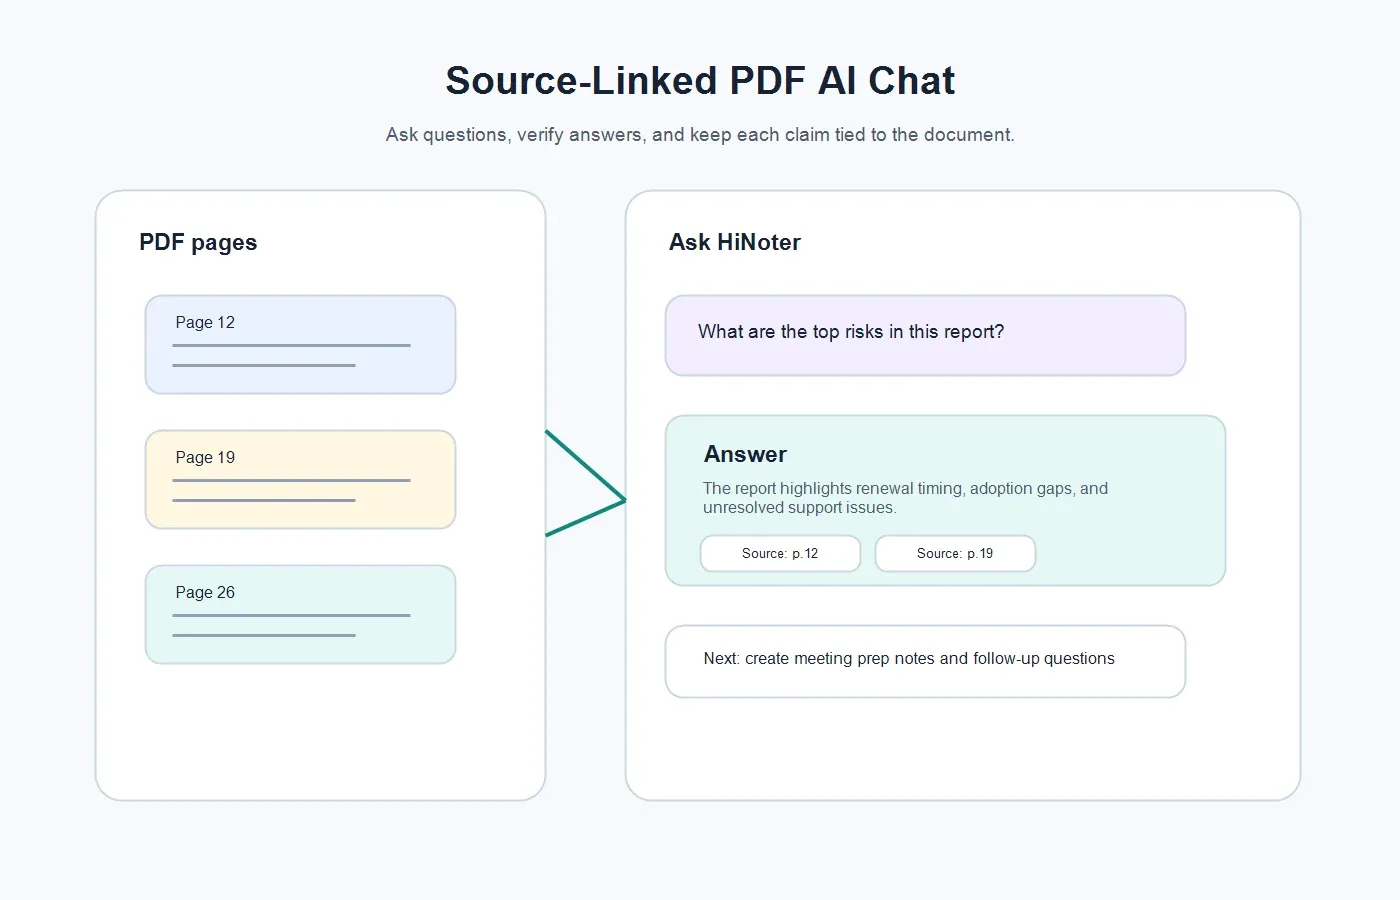
| AI чат с връзки към източника | Отговори, основани на PDF файла, с препратки към съдържанието на източника. | Задаване на конкретни въпроси, без да е необходимо препрочитане на целия документ. |
Ако източникът е записан уебинар или обучителна сесия, а не PDF файл, HiNoter може да поддържа и работни процеси с видео и аудио. За свързани типове съдържание вижте видео към текст и аудио към текст. Важното е последователността: едно работно пространство на екипа може да обработва срещи, документи, видеоклипове и гласово съдържание, вместо знанията да бъдат разпръснати между отделни инструменти.
Как HiNoter превръща PDF файловете в екипни знания
HiNoter работи най-добре, когато PDF файлът е част от реален работен процес. Статичният файл става полезен, когато помага на някого да се подготви, да вземе решение, да обясни или да проследи последващи действия. Ето практическия път.
1. Качете PDF файл, който имате право да обработвате
Започнете с PDF файл, който притежавате, сте създали, получили за работа или по друг начин имате разрешение да използвате. Това е важно за договори, учебни материали, платени отчети, клиентски документи и защитени с авторски права научни изследвания. Инструментът трябва да ви помага да разбирате документи, до които имате законен достъп; не трябва да се използва за заобикаляне на ограниченията за достъп или за повторно използване на съдържание без разрешение.
2. Извлечете текста или стартирайте OCR
HiNoter идентифицира четимото съдържание и го подготвя за преглед. Ако PDF файлът има текстов слой, извличането може да бъде директно. Ако е сканиран, OCR помага за възстановяване на видимия текст. При важни документи проверявайте имената, датите, числата, клаузите, цитатите и всеки раздел, в който форматирането може да повлияе на тълкуването.
3. Генерирайте резюме на раздел
Доброто резюме на PDF файл не трябва да свежда документа до общи твърдения. То трябва да запазва структурата на източника: проблем, доказателства, препоръка, риск, ограничение и следваща стъпка. За отчет това може да означава отделно резюмиране на изпълнителния преглед, констатациите, методологията и препоръките. За договор може да означава отделяне на задълженията, сроковете, условията за подновяване и отворените въпроси.
4. Създайте основни точки и подготовка за среща
След като съдържанието бъде извлечено, HiNoter може да го превърне в практични бележки. Продуктовият екип може да поиска основните проблеми на клиентите. Търговският екип може да поиска сигнали за покупка или възражения. Студентът може да поиска теза, доказателства и определения. Ръководителят може да поиска решенията, които трябва да бъдат взети на следващата среща. Тук PDF файлът се превръща от материал за четене в използваем контекст за екипа.
5. Задавайте въпроси с връзки към източника
AI чатът с връзки към източника е разликата между уверен и надежден отговор. Вместо да получава свободен AI отговор, потребителят може да зададе въпрос и да проследи отговора обратно до съдържанието на PDF файла. Това е особено важно за научни изследвания, съответствие с изискванията, технически ръководства, ангажименти към клиенти и отчети за ръководството.
Пример: Превръщане на клиентски PDF отчет в подготовка за среща
Представете си, че мениджър „Успех на клиентите“ получава PDF файл с тримесечен бизнес преглед преди разговор за подновяване. Документът включва графики за използването на продукта, история на поддръжката, текущи рискове, бележки за бюджета, коментари на заинтересованите страни и цели за следващото тримесечие. Извличането на текста е полезно, но не казва на мениджъра как да проведе срещата.
С HiNoter същият PDF файл може да се превърне в кратък бриф за подготовка. Мениджърът може да попита: Кои са основните рискове за подновяването? Кои заявки за продукта се появяват повече от веднъж? Какви ангажименти пое клиентът? Кои въпроси трябва да зададем по време на разговора? Какво трябва да бъде изпратено на екипа по акаунта преди срещата?
Получените бележки могат да включват резюме за ръководството в един абзац, три риска, пет въпроса към клиента, хронология на ангажиментите и кратко предаване на информацията към вътрешния екип. След срещата HiNoter може да свърже дискусията на живо с контекста на PDF файла, така че отчетът да не остава в папка, докато реалните решения се преместват в лични бележки или чатове.
Пример: Резюмиране на научна статия, без да се губи източникът
Студентите, анализаторите и изследователите често се нуждаят от повече от резюме в един абзац. Те трябва да знаят изследователския въпрос, метода, извадката, основната констатация, ограниченията и твърденията, които си струва да бъдат цитирани. Обикновеният конвертор от PDF към текст може да възстанови думите, но няма автоматично да определи кои части са важни за литературен обзор, брифинг или презентация.
По-полезният работен процес е да извлечете текста, да обобщите всеки основен раздел, да изброите ключовите термини, да идентифицирате най-силните доказателства и да зададете последващи въпроси с препратки. Например: Какво е централното твърдение на статията? Какви доказателства го подкрепят? Кои допускания трябва да бъдат поставени под въпрос? Кой абзац дефинира основното понятие? Кой раздел обяснява ограниченията?
Тъй като HiNoter поддържа отговори с връзки към източника, потребителят може да запази връзката между резюмето и оригиналното съдържание. Това прави резултата по-лесен за проверка и повторна употреба в учебни бележки, изследователски записки или екипни документи.
Често срещани проблеми при извличане от PDF и как да се справите с тях
PDF файловете са създадени така, че да запазват визуалното оформление, а не винаги да улесняват извличането на текст. Когато резултатите изглеждат небрежно, проблемът често е във формата на източника, а не просто в конвертора. Ето кои проблеми си струва да проверите, преди да разчитате на резултата.
| Проблем | Какво може да видите | Как да подобрите резултата |
|---|---|---|
| Ниско качество на сканирането | Липсващи думи, неправилни символи или прекъснати редове. | Използвайте по-ясно сканиране, подобрете контраста и прегледайте ръчно важните термини. |
| Оформление с няколко колони | Текстът от една колона може да се смеси с текста от друга. | Обобщавайте по раздели и проверете реда на прочитане, преди да споделите. |
| Сложни таблици | Връзките между редовете и колоните може да се загубят. | Прегледайте числата и етикетите, след което задайте конкретни въпроси за таблицата. |
| Горни и долни колонтитули | Повтарящият се текст на страниците може да затрудни извличането. | Почистете повтарящия се материал, преди да създадете окончателните бележки. |
| Защитен файл | Конверторът може да няма достъп до съдържанието. | Използвайте само упълномощена версия на документа и спазвайте ограниченията за файла. |
Контролен списък за качество, преди да споделите бележки от PDF файл
AI може да ускори процеса, но бележките по документи все пак заслужават преглед. Преди да споделите резюме на PDF файл с екип, проверете елементите, които могат да променят значението на документа.
- Потвърдете заглавието на документа, датата, автора, версията и източника.
- Прегледайте имената, продуктовите термини, акронимите, числата, сроковете и цитатите.
- Проверете дали PDF файлът е сканиран, текстов, с много таблици или с много изображения.
- Попитайте се дали резюмето запазва структурата и ограниченията на документа.
- Проверете ключовите твърдения спрямо препратките към източника, преди да ги използвате при вземане на решения.
- Разделяйте фактите от тълкуванията, препоръките и отворените въпроси.
- Експортирайте окончателните бележки в работното пространство, в което екипът вече работи.
За много екипи именно последната стъпка е мястото, където работата с документи се проваля. Някой прочита PDF файла, създава лично резюме и изпраща съобщение, което никога не се превръща в трайно екипно знание. HiNoter може да помогне за преодоляване на тази празнина, като експортира структурирани бележки в екипни системи като Notion и Google Docs, така че резултатът да бъде там, където хората планират, пишат и проследяват последващи действия.
За какво да използвате конвертор от PDF към текст
Конверторът от PDF към текст е полезен винаги, когато съдържанието е ценно, но е затворено в статичен формат. Най-добрите случаи на употреба не са свързани само с конвертирането; те са свързани с намаляване на времето между получаването на документ и ефективното използване на информацията в него.
Доклади и резюмета за ръководството
Докладите за ръководството често съдържат повече подробности, отколкото заетите читатели могат да възприемат преди среща. Извличането на текста ви позволява да създадете кратко резюме, да идентифицирате препоръчаните решения и да подготвите въпроси за обсъждането. HiNoter може да превърне дълъг PDF файл в кратък документ, който откроява проблема, доказателствата, препоръката, риска и следващата стъпка.
Договори и документи с политики
Договорите и PDF документите с политики изискват внимателно прочитане. AI не трябва да заменя правния преглед, но може да помогне при организирането на първоначалния преглед: задължения, дати за подновяване, изключения, отворени въпроси и условия, които изискват човешко внимание. Отговорите с връзки към източника са особено полезни тук, тъй като читателят може да провери всяка важна точка спрямо оригиналния текст.
Научни статии и записки от занятия
Академичните PDF файлове са умишлено наситени с информация. Студентите и изследователите могат да използват извличане на текст и AI резюмета, за да идентифицират определения, методи, твърдения, доказателства и ограничения. Вместо да копира параграфи в отделно приложение за записки, потребителят може да превърне статията в структурирани учебни записки и да задава последващи въпроси.
Ръководства и информация за поддръжка
Екипите за поддръжка често работят с ръководства, продуктови наръчници, инструкции за настройка и PDF файлове за отстраняване на неизправности. Работен процес за чат с възможност за търсене в PDF файлове може да помогне на агентите да откриват правилния отговор по-бързо, особено когато препратките към източника показват откъде идва инструкцията. Крайният резултат може да се използва повторно във вътрешна документация или чернови на отговори към клиенти.
Подготовка за срещи и последващи действия
Някои PDF файлове не са крайният резултат; те са контекст за среща. Доклад за клиент, предложение от доставчик, пакет за борд, продуктова спецификация или преглед на проект могат да бъдат превърнати в бележки за подготовка преди разговора. След срещата HiNoter може да свърже контекста от PDF файла с действителното обсъждане, резюмето, решенията и задачите за изпълнение.
Насоки за поверителност и разрешения
Преди да качите PDF файл в конвертор или AI инструмент, потвърдете, че имате право да го обработвате. Това е особено важно за поверителни договори, досиета на служители, здравни документи, финансови отчети, клиентски данни, платени изследвания, учебни материали и съдържание, защитено с авторски права. Използвайте одобрени от компанията работни процеси за чувствителни документи и премахвайте информацията, която не е необходимо да бъде обработвана.
Практичен навик за защита на поверителността е да класифицирате файла преди качване. Попитайте се дали е публичен, вътрешен, поверителен, регулиран или предоставен от клиент. След това решете кой трябва да има достъп до извлечения текст, резюмето, отговорите от чата и експортираните файлове. Инструментът трябва да намалява рутинната работа, без да създава ново неконтролирано копие на чувствителна информация.
За екипите разрешенията трябва да бъдат също толкова целенасочени, колкото и самите бележки. Резюме на PDF файл, използвано за подготовка за среща, може да принадлежи в споделено работно пространство на проекта. Анализът на договор може да бъде достъпен само за правния екип и отговорниците за клиента. Резюме на изследване може да е подходящо за по-широк екип. Правилният работен процес зависи от съдържанието, а не само от удобството на конвертора.
Кога PDF конверторът трябва да се превърне в AI работен процес за знания
Използвайте обикновен конвертор, когато трябва само да копирате текст. Използвайте AI работен процес за знания, когато документът ще повлияе на решение, среща, проект, учебен курс, отношения с клиент или вътрешен процес. В момента, в който някой попита „какво означава това?“ или „какво трябва да направим следващо?“, суровото извличане вече не е достатъчно.
HiNoter е създаден за тази втора категория. Той може да приеме съдържанието на документа, да го обобщи, да идентифицира ключовите точки, да подготви бележки за срещи и да поддържа AI Chat с връзки към източника. Същото работно пространство може да обработва и записи на срещи, видеоклипове, аудио и бележки, така че PDF файлът да стане част от по-голям запис на знания, а не еднократно преобразуване.
Ако имате нужда от повече от текст, HiNoter превръща съдържанието на PDF файла в извлечен текст плюс резюме, ключови точки, бележки за срещи, експортирани файлове и Q&A с възможност за търсене. Качете разрешен PDF файл, прегледайте извлеченото съдържание и използвайте резултата, за да се подготвите, вземете решение, преподавате, информирате или проследите действията с по-малко ръчен труд.
Често задавани въпроси относно работните процеси за конвертиране на PDF в текст
Кой е най-добрият начин за конвертиране на PDF в текст?
Най-добрият метод зависи от типа на PDF файла. Ако PDF файлът съдържа избираем текст, директното извличане обикновено е най-бързо. Ако е сканиран или базиран на изображения, използвайте OCR. За бизнес или изследователска работа използвайте работен процес, който също обобщава разделите и поддържа препратки към източника за преглед.
Може ли конверторът от PDF в текст да чете сканирани документи?
Да, ако включва OCR. OCR може да разчита текст от сканирани страници и изображения, но качеството зависи от яснотата на сканирането, четливостта на шрифта, ъгъла на страницата, контраста и това дали файлът съдържа ръкописен текст, печати или сложни оформления.
Каква е разликата между извличане на текст от PDF и обобщаване на PDF?
Извличането от PDF изважда думите от файла. Обобщаването на PDF обяснява основните точки в по-кратка форма. Извличането ви помага да получите достъп до текста; обобщаването ви помага да разберете съдържанието по-бързо.
Какво представлява чатът с PDF, базиран на източника?
Чатът с PDF, базиран на източника, ви позволява да задавате въпроси относно PDF файл и да получавате отговори, свързани обратно със съдържанието на източника. Това е полезно, когато трябва да проверите откъде идва даден отговор, вместо да разчитате на общ отговор от AI.
Може ли HiNoter да обобщава PDF файлове?
HiNoter може да помогне за превръщането на съдържанието на PDF файлове в структурирани резюмета, ключови точки, бележки и отговори от AI Chat с връзки към източника. Той е особено полезен, когато PDF файловете трябва да се превърнат в материали за подготовка за срещи, изследователски бележки, вътрешна документация или знания за екипа.
Трябва ли да преглеждам генерираните от AI резюмета на PDF файлове?
Да. Преглеждайте критични подробности като числа, дати, имена, правни термини, цитати, задължения и препоръки. AI резюметата са полезни за бързина, но важните решения трябва да останат свързани с изходния документ.