PDF-tekstimuunnin poimii PDF-tiedostosta luettavan tekstin, jotta voit kopioida, hakea, tiivistää ja käyttää sitä uudelleen. Skannatuissa PDF-tiedostoissa OCR lukee tekstin kuvista. HiNoter menee pidemmälle muuttamalla poimitun PDF-sisällön tiivistelmiksi, pääkohdiksi, kokousvalmistelumuistiinpanoiksi ja lähteisiin linkitetyiksi tekoälychat-vastauksiksi.
Mikä on PDF-tekstimuunnin?
PDF-tekstimuunnin on ohjelmisto, joka ottaa PDF-tiedoston sisään lukitun sisällön ja muuttaa sen muokattavaksi ja haettavaksi tekstiksi. Tehtävä kuulostaa yksinkertaiselta, kunnes vastaan tulevat oikean maailman PDF-tiedostot: skannatut sopimukset, viedyt esityskalvot, alaviitteitä sisältävät akateemiset artikkelit, palstoitetut käyttöoppaat, taulukoita täynnä olevat hallituksen raportit ja kuvapainotteiset asiakirjat, joissa sanat ovat teknisesti osa kuvaa.
Opiskelijalle tavoitteena voi olla poimia tutkimusartikkelista keskeiset ideat. Tuotepäällikölle tavoitteena voi olla muuttaa asiakasraportti kokousvalmisteluksi. Lakiasioiden, tuen tai operatiivisen toiminnan tiimille tavoitteena voi olla löytää täsmällinen lause, joka vastaa kysymykseen ilman viidenkymmenen sivun uudelleenlukemista. Raakatekstin poiminta on hyödyllistä, mutta se on vasta ensimmäinen askel. Todellinen arvo syntyy, kun poimitusta sisällöstä tulee jäsenneltyä, tiivistettyä, lähteistettyä ja uudelleenkäytettävää.
Tässä HiNoter sopii kokonaisuuteen luontevasti. HiNoter on tekoälyä hyödyntävä kokousmuistiinpano- ja transkriptioalusta, mutta se ei rajoitu kokouksiin. Tiimit voivat käyttää sitä PDF-tiedostojen, äänen, videon ja sallitun verkkosisällön käsittelyyn samassa työtilassa. Raportista voi tulla tiivistelmä. Käyttöoppaasta voi tulla haettava kysymys–vastaus-sisältö. Ennen kokousta käytetystä PDF-tiedostosta voi tulla valmistelumuistiinpanoja, kysymyksiä, riskejä ja seurantatehtäviä.
PDF-tekstimuuntimen työnkulku: staattisesta tiedostosta hyödyllisiksi muistiinpanoiksi
Selkein työnkulku ei ole yksinkertaisesti ”lataa PDF ja kopioi teksti”. Parempi PDF-työnkulku erottaa poiminnan ymmärtämisestä. Ensin työkalu tunnistaa, sisältääkö asiakirja valittavaa tekstiä vai edellyttääkö se OCR:ää. Sen jälkeen se poimii sisällön, säilyttää riittävästi rakennetta merkityksen säilyttämiseksi ja antaa sinun tiivistää, tehdä kyselyitä tai viedä tuloksen.
| Vaihe | Mitä tapahtuu | Miksi se on tärkeää |
|---|---|---|
| 1. Lataa PDF | Lisää raportti, artikkeli, käyttöopas, sopimus, esityskalvot tai kurssimoniste, jonka käsittelyyn sinulla on lupa. | Lähdetiedosto pysyy yhdistettynä siitä syntyviin muistiinpanoihin ja vastauksiin. |
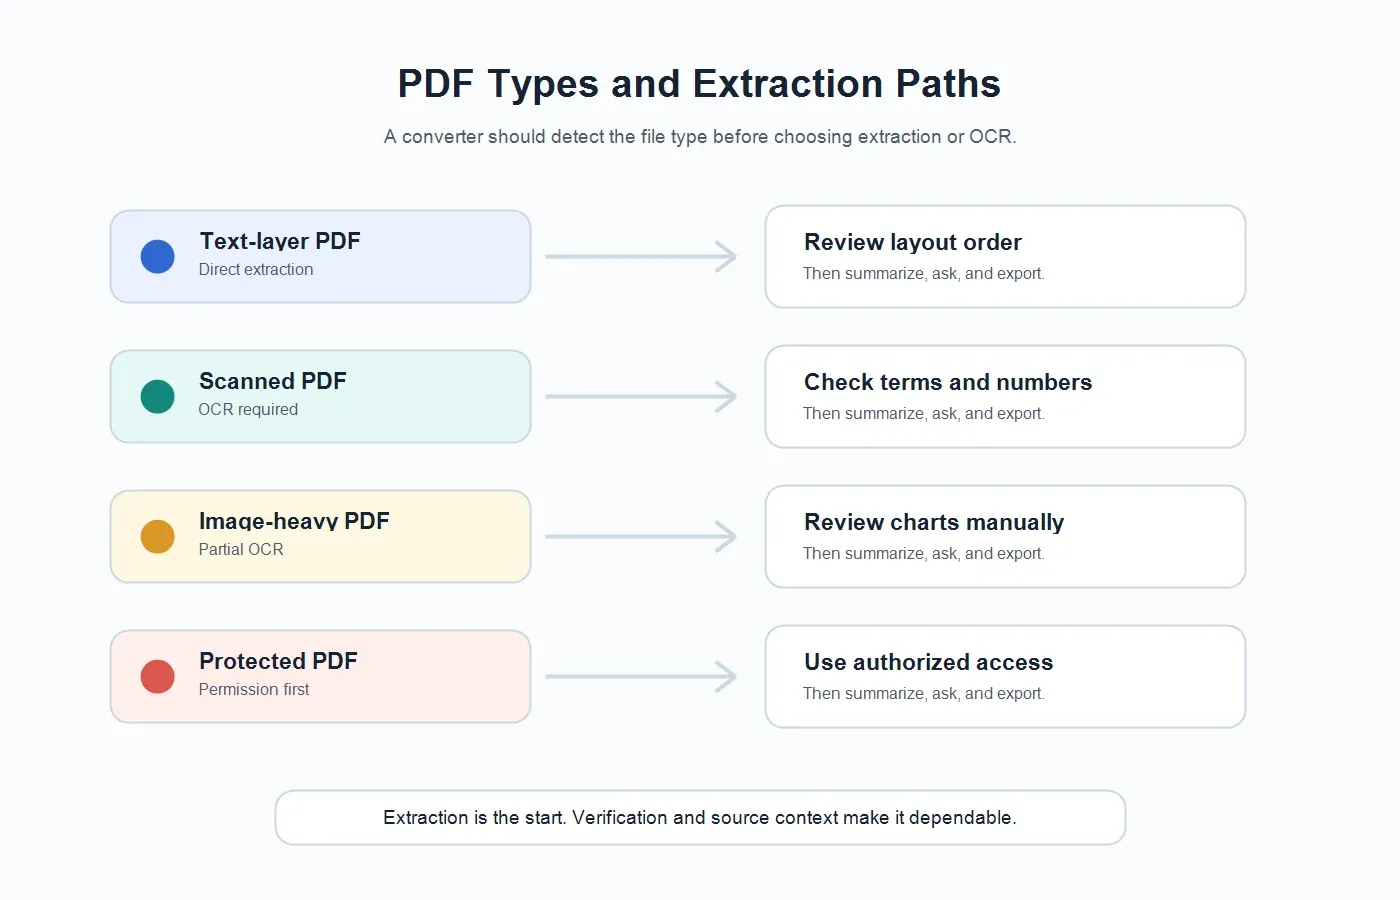
| 2. Tunnista PDF-tyyppi | Järjestelmä tarkistaa, sisältääkö PDF tekstitason vai tarvitseeko se OCR:ää. | Eri PDF-tyypit edellyttävät erilaisia poimintamenetelmiä. |
| 3. Poimi teksti | Valittava teksti poimitaan suoraan; skannattu teksti luetaan OCR:n avulla. | Saat sisältöä, jota voidaan hakea, kopioida, tarkastella ja tiivistää. |
| 4. Siivoa ja jäsennä | Osioiden, otsikoiden, taulukoiden, lähdeviitteiden ja sivukontekstin rakenne säilytetään mahdollisuuksien mukaan. | Selkeä rakenne vähentää virheellisiä tiivistelmiä ja rikkoutuneita muistiinpanoja. |
| 5. Tiivistä ja kysy | HiNoter luo tiivistelmiä, pääkohtia, kokousvalmistelumuistiinpanoja ja lähteisiin linkitettyjä tekoälychat-vastauksia. | PDF:stä tulee hyödynnettävää tietoa, ei vain poimittua tekstiä. |
Jos rakennat toistettavaa tiimiprosessia, yhdistä PDF-työnkulku laajempaan muistiinpanojärjestelmääsi. Esimerkiksi tiimit, jotka käyttävät jo tekoälychatia kokoustietoon, voivat käyttää samaa lähteisiin linkitettyä kyselytapaa PDF-sisällölle. Esihenkilö voi kysyä, mikä muuttui kahden asiakasraportin välillä. Opiskelija voi kysyä artikkelin keskeistä väitettä. Tuen vetäjä voi kysyä, missä käyttöoppaassa selitetään määritysperiaate.
OCR, tekstitason PDF:t ja skannatut PDF:t selitettyinä
Kaikki PDF-tiedostot eivät tallenna sanoja samalla tavalla. Joissakin PDF-tiedostoissa on varsinainen tekstikerros, mikä tarkoittaa, että voit valita sanoja kohdistimella. Toiset ovat skannattuja sivuja tai valokuvia sivuista, jolloin asiakirja sisältää kuvia, joissa sattuu olemaan tekstiä. PDF-tekstimuuntimen on pystyttävä käsittelemään molempia, tai tulos tuntuu epäluotettavalta.
Mikä on OCR?
OCR on lyhenne sanoista optical character recognition eli optinen merkintunnistus. OCR lukee tekstin kuvasta, skannauksesta tai valokuvasta ja muuntaa näkyvät merkit koneellisesti luettavaksi tekstiksi. Se on hyödyllinen skannatuissa PDF-tiedostoissa, valokuvatuissa sivuissa, vanhoissa lomakkeissa, paperisopimuksissa ja kuvapohjaisissa esitysvienneissä.
OCR:n laatu riippuu lähteestä. Selkeät skannaukset, suorat sivut, suuri kontrasti, luettavat fontit ja vähäinen käsinkirjoitus tuottavat parempia tuloksia. Vinojen sivujen, matalan resoluution kuvien, leimojen, varjojen, monimutkaisten taulukoiden ja useiden kielten yhdistelmät voivat aiheuttaa virheitä. Hyvä työnkulku tekee tarkistamisesta helppoa sen sijaan, että se teeskentelisi jokaisen skannatun asiakirjan olevan täydellinen.
Mikä on tekstitason PDF?
Tekstitason PDF sisältää jo koneellisesti luettavaa tekstiä visuaalisen asettelun taustalla. Voit yleensä valita, kopioida ja hakea tiedostossa olevia sanoja. Tekstitason PDF:t ovat usein peräisin Google Docsista, Microsoft Wordista, suunnittelutyökaluista, raportointialustoista tai julkaisujärjestelmistä tehdyistä vienneistä.
Nämä tiedostot on yleensä helpompi muuntaa kuin skannaukset, mutta niissäkin on erityistapauksia. Monipalstaiset asettelut voidaan poimia väärässä lukemisjärjestyksessä. Ylä- ja alatunnisteet voivat toistua. Taulukot voivat hajota sekaviksi palasiksi. Alaviitteet, viittaukset ja sivupalkit voivat päätyä paikkoihin, joissa poimitusta tekstistä tulee vaikealukuista. Siksi hyödylliseen PDF-työnkulkuun tulisi sisältyä puhdistus, osioiden tiivistelmät ja lähteiden tarkistaminen.
Skannatut PDF:t ja tekstipohjaiset PDF:t: mitä odottaa
Ennen kuin arvioit muunninta, tunnista PDF-tyyppi. Sama työkalu voi toimia erinomaisesti selkeän tekstitason raportin kanssa ja huonosti valokuvatun sopimuksen kanssa. Tämä taulukko antaa käytännön kuvan siitä, mitä yleensä tapahtuu.
| PDF-tyyppi | Miten teksti löydetään | Yleinen rajoitus | Paras HiNoter-työnkulku |
|---|---|---|---|
| Tekstitason PDF | Muunnin poimii upotetun valittavan tekstin. | Palstat, ylä- ja alatunnisteet sekä taulukot voivat esiintyä väärässä järjestyksessä. | Poimi teksti, tiivistä osioittain ja esitä sitten lähteisiin linkitettyjä kysymyksiä. |
| Skannattu PDF | OCR lukee sanat sivukuvista. | Tarkkuus riippuu skannauksen laadusta, kontrastista, vinoudesta ja fontin selkeydestä. | Suorita OCR, tarkista kriittiset termit ja luo sitten muistiinpanot ja pääkohdat. |
| Kuvapainotteinen PDF | Teksti voi olla upotettuna kaavioihin, kuvakaappauksiin tai esityskalvokuvina. | Kaaviot ja piirrokset voivat edellyttää ihmisen tarkistusta täydellisen merkityksen ymmärtämiseksi. | Poimi näkyvä teksti, tiivistä kerronta ja merkitse visuaalisesti painottuneet osiot. |
| Salasanasuojattu PDF | Käyttöoikeus riippuu luvista ja tiedoston rajoituksista. | Joidenkin tiedostojen käsittely ei ole mahdollista ennen kuin valtuutettu käyttäjä avaa niiden lukituksen. | Käytä vain asiakirjoja, joihin sinulla on lainmukainen pääsy, ja käsittele sitten sallittu tiedosto. |
| Taulukkopainotteinen PDF | Tekstin poiminta lukee solut, otsikot ja arvot mahdollisuuksien mukaan. | Monimutkaiset taulukot voivat menettää rivi- ja sarakeyhteytensä. | Poimi teksti, tarkista luvut ja esitä kohdennettuja kysymyksiä lähdekontekstin avulla. |
Miksi pelkkä poimittu teksti ei yleensä riitä
Monet PDF-työkalut lopettavat toimintansa heti, kun ne ovat tuottaneet tekstiä. Se on hyödyllistä, jos ainoa tavoitteesi on kopioida lainaus tai indeksoida tiedosto. Se on vähemmän hyödyllistä, kun PDF sisältää kaksikymmentä sivua tutkimusta, tiiviin markkinaraportin, toimintaperiaateasiakirjan, sopimuksen tai koulutusoppaan. Sinun on edelleen luettava poimittu teksti, päätettävä, mikä on tärkeää, löydettävä lähdeviittauksen arvoiset väitteet ja muutettava asiakirja muotoon, jota tiimisi voi käyttää.
Tietotyöntekijöille syvempi ongelma ei ole sanojen saatavuus. Se on olennaisen erottaminen. Mitkä osiot ovat tärkeitä? Mitkä ovat riskit? Mitä kysymyksiä meidän pitäisi ottaa mukaan kokoukseen? Mitkä väitteet on tarkistettava? Mikä muuttui edelliseen versioon verrattuna? Mihin toimiin jonkun pitäisi ryhtyä tämän lukemisen jälkeen?
HiNoter on hyödyllinen tässä, koska se käsittelee PDF-tekstiä jäsennellyn tiedon lähdemateriaalina. PDF:stä voi tulla johdon tiivistelmä, tutkimusmuistio, joukko kokousvalmistelumuistiinpanoja, aihekartta tai haettava kysymys–vastaus-tila. Jos käytät jo HiNoteria tekoälyä hyödyntävien kokousmuistiinpanojen työnkulkuun, PDF-käsittelystä tulee osa samaa tietokiertoa erillisen asiakirjarutiinin sijaan.
PDF tekstiksi vs. PDF-tiivistelmä vs. PDF-chat
Nämä tulosteet ratkaisevat eri tehtäviä. PDF-tiedoston raakatekstiversio ei ole sama asia kuin tiivistelmä, eikä tiivistelmä ole sama asia kuin lähteeseen perustuva chat-vastaus. Tiimit saavat parempia tuloksia, kun ne valitsevat tarpeitaan vastaavan tulosteen.
| Tuloste | Mitä se antaa sinulle | Paras käyttötapaus |
|---|---|---|
| Poimittu teksti | PDF-tiedoston luettavat sanat ja mahdollisuuksien mukaan siistitty teksti. | Lainausten kopiointi, asiakirjan hakutoiminnot, tekstin arkistointi tai lähdetiedoston valmistelu. |
| PDF-yhteenveto | Lyhyempi selitys tärkeimmistä ajatuksista, havainnoista, riskeistä tai suosituksista. | Raportin nopea ymmärtäminen ennen kokousta, oppituntia tai tarkistusta. |
| Keskeiset kohdat | Aiheen, osion tai päätöksenteon kannalta merkityksellisyyden mukaan järjestetyt luettelomerkityt pääkohdat. | Esihenkilön briiffaaminen, tiimipäivityksen valmistelu tai muistiinpanojen tekeminen opiskelua varten. |
| Kokoukseen valmistautumisen muistiinpanot | PDF-sisällöstä ehdotetut kysymykset, asialistakohdat, riskit ja päätökset. | Asiakasraportin, sopimuksen tai tutkimusartikkelin muuttaminen kohdennetuksi keskusteluksi. |
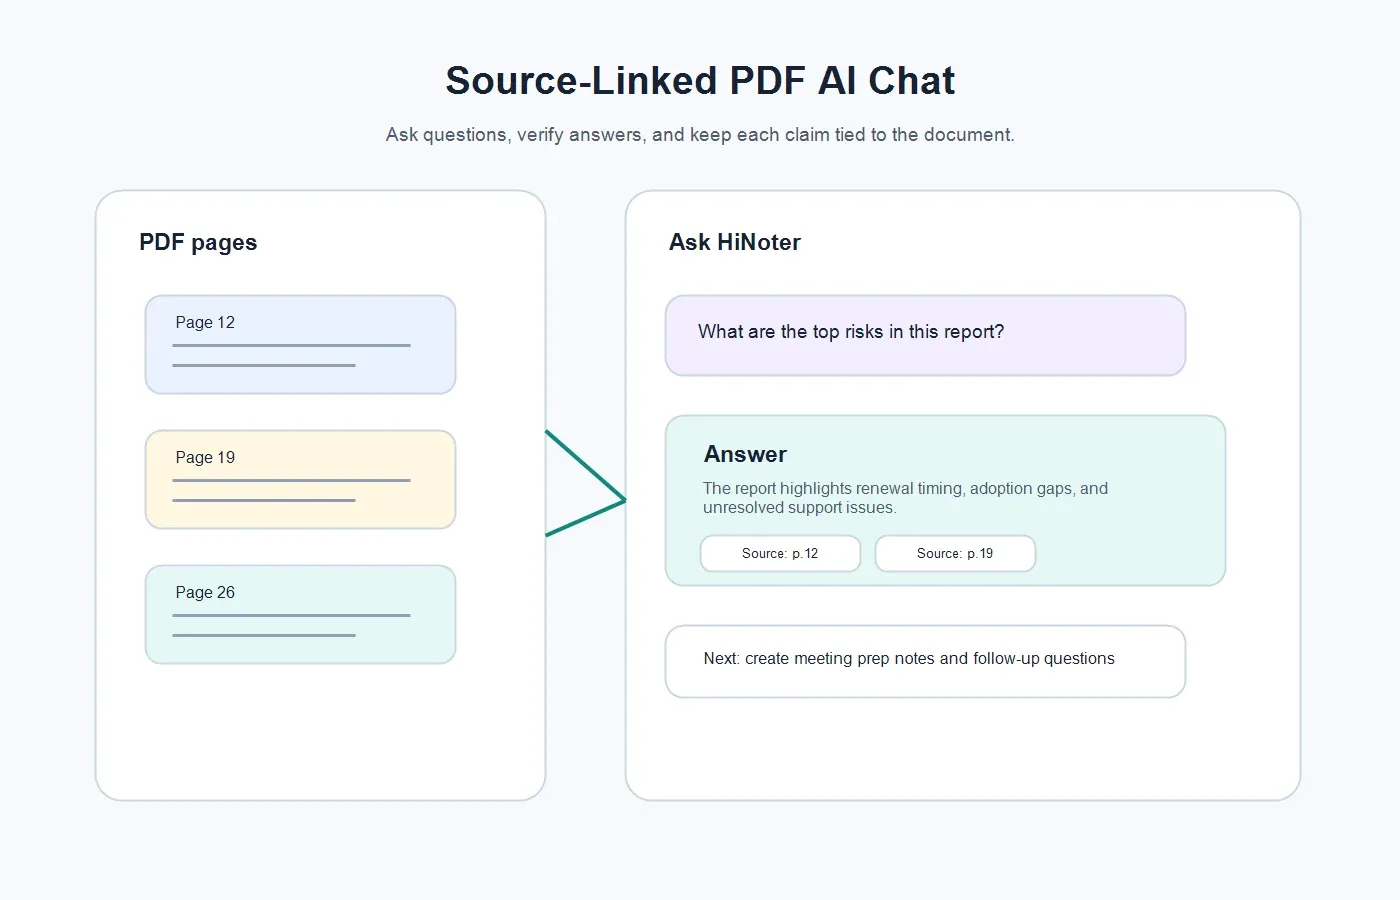
| Lähteisiin linkitetty tekoälychat | PDF-tiedostoon perustuvat vastaukset sekä viittaukset takaisin lähdesisältöön. | Tarkkojen kysymysten esittäminen ilman koko asiakirjan uudelleenlukemista. |
Jos lähde on tallennettu webinaari tai koulutustilaisuus PDF-tiedoston sijaan, HiNoter tukee myös video- ja äänityönkulkuja. Aiheeseen liittyviä sisältötyyppejä ovat videon muuntaminen tekstiksi ja äänen muuntaminen tekstiksi. Tärkeintä on johdonmukaisuus: yksi tiimin työtila voi käsitellä kokouksia, asiakirjoja, videoita ja äänisisältöä sen sijaan, että tieto hajautuisi erillisiin työkaluihin.
Miten HiNoter muuttaa PDF-tiedostot tiimin tiedoksi
HiNoter toimii parhaiten, kun PDF on osa todellista työnkulkua. Staattisesta tiedostosta tulee hyödyllinen, kun se auttaa jotakuta valmistautumaan, tekemään päätöksen, selittämään tai seuraamaan asioita. Käytännön eteneminen on seuraava.
1. Lataa PDF, jonka käsittelyyn sinulla on lupa
Aloita PDF-tiedostosta, jonka omistat, jonka olet luonut, jonka olet saanut työtä varten tai jonka käyttöön sinulla on muuten lupa. Tämä on tärkeää sopimusten, kurssimateriaalien, maksullisten raporttien, asiakasasiakirjojen ja tekijänoikeudella suojatun tutkimuksen kohdalla. Työkalun tulisi auttaa sinua ymmärtämään asiakirjoja, joita voit käyttää lainmukaisesti; sitä ei tule käyttää käyttörajoitusten kiertämiseen tai sisällön uudelleenkäyttöön ilman lupaa.
2. Poimi teksti tai suorita OCR
HiNoter tunnistaa luettavan sisällön ja valmistelee sen tarkastelua varten. Jos PDF-tiedostossa on tekstikerros, poiminta voidaan tehdä suoraan. Jos tiedosto on skannattu, OCR auttaa palauttamaan näkyvän tekstin. Tarkista tärkeiden asiakirjojen nimet, päivämäärät, luvut, lausekkeet, viittaukset ja kaikki osiot, joissa muotoilu voi vaikuttaa tulkintaan.
3. Luo osioyhteenveto
Hyvän PDF-yhteenvedon ei pitäisi pelkistää asiakirjaa yleisluontoisiksi lausumiksi. Sen tulisi säilyttää lähteen rakenne: ongelma, näyttö, suositus, riski, rajoitus ja seuraava vaihe. Raportissa tämä voi tarkoittaa johdannon, havaintojen, menetelmien ja suositusten yhteenvetoa erikseen. Sopimuksessa se voi tarkoittaa velvoitteiden, määräaikojen, uusimisehtojen ja avoimien kysymysten erottamista toisistaan.
4. Luo keskeiset kohdat ja kokousvalmistelut
Kun sisältö on poimittu, HiNoter voi muuttaa sen käytännön muistiinpanoiksi. Tuotetiimi voi pyytää asiakaskokemuksen kipukohtia. Myyntitiimi voi pyytää ostoaikeista kertovia signaaleja tai vastaväitteitä. Opiskelija voi pyytää pääväitettä, näyttöä ja määritelmiä. Esihenkilö voi pyytää seuraavassa kokouksessa tarvittavia päätöksiä. Tässä vaiheessa PDF muuttuu lukumateriaalista käyttökelpoiseksi tiimin kontekstiksi.
5. Esitä lähteisiin linkitettyjä kysymyksiä
Lähteisiin linkitetty tekoälychat erottaa itsevarman vastauksen luotettavasta vastauksesta. Irrallisen tekoälyvastauksen sijaan käyttäjä voi esittää kysymyksen ja jäljittää vastauksen PDF-sisältöön. Tämä on erityisen tärkeää tutkimuksessa, vaatimustenmukaisuudessa, teknisissä käyttöoppaissa, asiakassitoumuksissa ja johdon raporteissa.
Esimerkki: Asiakkaan PDF-raportin muuttaminen kokousvalmisteluiksi
Kuvitellaan, että asiakkuuspäällikkö saa neljännesvuosittaisen liiketoimintakatsauksen PDF-tiedostona ennen uusimispuhelua. Asiakirja sisältää tuotteen käyttöönottokaavioita, tukihistorian, avoimia riskejä, budjettihuomioita, sidosryhmien kommentteja ja seuraavan vuosineljänneksen tavoitteita. Tekstin poiminta on hyödyllistä, mutta se ei kerro esihenkilölle, miten kokous tulisi käydä.
HiNoterin avulla samasta PDF-tiedostosta voi tulla tiivis valmistelumuistio. Esihenkilö voi kysyä: Mitkä ovat tärkeimmät uusimiseen liittyvät riskit? Mitkä tuote-esitykset toistuvat useammin kuin kerran? Mihin sitoumuksiin asiakas ryhtyi? Mitä kysymyksiä meidän tulisi esittää puhelussa? Mitä tilitiimille tulisi lähettää ennen kokousta?
Muistiinpanot voivat sisältää yhden kappaleen johdon yhteenvedon, kolme riskiä, viisi kysymystä asiakkaalle, sitoumusten aikajanan ja lyhyen siirron sisäiselle tiimille. Kokouksen jälkeen HiNoter voi yhdistää käydyn keskustelun PDF-kontekstiin, jotta raportti ei jää kansioon samalla kun todelliset päätökset siirtyvät yksityisiin muistiinpanoihin tai chat-keskusteluihin.
Esimerkki: Tutkimusartikkelin tiivistäminen lähdettä kadottamatta
Opiskelijat, analyytikot ja tutkijat tarvitsevat usein enemmän kuin kappaleen mittaisen yhteenvedon. Heidän on tiedettävä tutkimuskysymys, menetelmä, otos, tärkein havainto, rajoitukset ja mainitsemisen arvoiset väitteet. Raaka PDF-tekstimuunnin voi palauttaa sanat, mutta se ei automaattisesti päätä, mitkä osat ovat tärkeitä kirjallisuuskatsausta, briiffausta tai esitystä varten.
Hyödyllisempi työnkulku on poimia teksti, tiivistää jokainen pääosio, luetella keskeiset termit, tunnistaa vahvin näyttö ja esittää jatkokysymyksiä viitteineen. Esimerkiksi: Mikä on artikkelin keskeinen väite? Mikä näyttö tukee sitä? Mitä oletuksia pitäisi kyseenalaistaa? Missä kappaleessa pääkäsite määritellään? Missä osiossa selitetään rajoitukset?
Koska HiNoter tukee lähteisiin linkitettyjä vastauksia, käyttäjä voi pitää yhteenvedon yhteydessä alkuperäiseen sisältöön. Näin tulos on helpompi tarkistaa ja käyttää uudelleen luentomuistiinpanoissa, tutkimusmuistioissa tai tiimin asiakirjoissa.
Yleiset PDF-poiminnan ongelmat ja niiden käsittely
PDF-tiedostot on suunniteltu säilyttämään visuaalinen asettelu, eivätkä ne aina helpota tekstin poimintaa. Jos tulokset näyttävät sekavilta, ongelma on usein lähteen muodossa eikä pelkästään muuntimessa. Seuraavat ongelmat kannattaa tarkistaa ennen kuin luotat tulokseen.
| Ongelma | Mitä saatat nähdä | Miten tulosta voi parantaa |
|---|---|---|
| Heikkolaatuinen skannaus | Puuttuvia sanoja, vääriä merkkejä tai rikkoutuneita rivejä. | Käytä selkeämpää skannausta, paranna kontrastia ja tarkista tärkeät termit manuaalisesti. |
| Monipalstainen asettelu | Yhden palstan teksti voi sekoittua toisen palstan tekstiin. | Tiivistä osioittain ja tarkista lukujärjestys ennen jakamista. |
| Monimutkaiset taulukot | Rivit ja sarakkeet voivat menettää keskinäiset suhteensa. | Tarkista luvut ja otsikot ja esitä sitten taulukkoa koskevia täsmällisiä kysymyksiä. |
| Ylä- ja alatunnisteet | Toistuva sivuteksti voi sotkea poimintaa. | Siivoa toistuva sisältö ennen lopullisten muistiinpanojen luomista. |
| Suojattu tiedosto | Muunnin ei ehkä pääse käsiksi sisältöön. | Käytä vain asiakirjan luvallista versiota ja noudata tiedoston rajoituksia. |
Laatutarkistus ennen PDF-muistiinpanojen jakamista
Tekoäly voi nopeuttaa prosessia, mutta asiakirjamuistiinpanot on silti tarkistettava. Ennen kuin jaat PDF-yhteenvedon tiimille, tarkista kohdat, jotka voivat muuttaa asiakirjan merkitystä.
- Vahvista asiakirjan nimi, päivämäärä, kirjoittaja, versio ja lähde.
- Tarkista nimet, tuotetermit, lyhenteet, luvut, määräajat ja viittaukset.
- Tarkista, oliko PDF skannattu, tekstipohjainen, taulukkopainotteinen vai kuvapainotteinen.
- Kysy, säilyttääkö yhteenveto asiakirjan rakenteen ja rajoitukset.
- Vahvista keskeiset väitteet lähdeviitteitä vasten ennen niiden käyttämistä päätöksissä.
- Erota tosiasiat tulkinnoista, suosituksista ja avoimista kysymyksistä.
- Vie lopulliset muistiinpanot työtilaan, jossa tiimi työskentelee jo.
Monille tiimeille juuri viimeinen vaihe on kohta, jossa asiakirjatyö hajoaa. Joku lukee PDF-tiedoston, luo yksityisen yhteenvedon ja lähettää viestin, josta ei koskaan tule pysyvää tiimitietoa. HiNoter voi auttaa sulkemaan tämän aukon viemällä rakenteiset muistiinpanot tiimijärjestelmiin, kuten Notioniin ja Google Docsiin, jotta tulos voi elää siellä, missä ihmiset suunnittelevat, kirjoittavat ja seuraavat asioita.
Mihin PDF-tekstimuunninta kannattaa käyttää
PDF-tekstimuunnin on hyödyllinen aina, kun sisältö on arvokasta mutta jää jumiin staattiseen muotoon. Parhaat käyttötapaukset eivät liity vain muuntamiseen, vaan siihen, että asiakirjan vastaanottamisen ja sen tietojen tehokkaan hyödyntämisen välinen aika lyhenee.
Raportit ja johdon katsaukset
Johdon raportit sisältävät usein enemmän yksityiskohtia kuin kiireiset lukijat ehtivät omaksua ennen kokousta. Tekstin poimimisen avulla voit laatia tiiviin yhteenvedon, tunnistaa suositellut päätökset ja valmistella kysymyksiä keskustelua varten. HiNoter voi muuttaa pitkän PDF-tiedoston tiiviiksi katsaukseksi, jossa korostuvat ongelma, todisteet, suositus, riski ja seuraava vaihe.
Sopimukset ja toimintaperiaateasiakirjat
Sopimukset ja toimintaperiaatteita käsittelevät PDF-tiedostot vaativat huolellista lukemista. Tekoälyn ei pitäisi korvata oikeudellista tarkastelua, mutta se voi auttaa järjestämään ensimmäisen läpikäynnin: velvoitteet, uusimispäivät, poikkeukset, avoimet kysymykset ja ehdot, jotka vaativat ihmisen huomiota. Lähteisiin linkitetyt vastaukset ovat tässä erityisen hyödyllisiä, koska lukija voi tarkistaa jokaisen tärkeän kohdan alkuperäisestä tekstistä.
Tutkimusartikkelit ja luentomuistiinpanot
Akateemiset PDF-tiedostot ovat tarkoituksella tiiviitä. Opiskelijat ja tutkijat voivat käyttää tekstin poimintaa ja tekoälyn laatimia yhteenvetoja määritelmien, menetelmien, väitteiden, todisteiden ja rajoitusten tunnistamiseen. Sen sijaan että kappaleita kopioitaisiin erilliseen muistiinpanosovellukseen, käyttäjä voi muuttaa artikkelin jäsennellyiksi opiskelumuistiinpanoiksi ja esittää jatkokysymyksiä.
Käyttöoppaat ja tukitietämys
Tukitiimit käsittelevät usein käyttöoppaita, tuoteoppaita, asennusohjeita ja vianmääritystä käsitteleviä PDF-tiedostoja. Haettavissa oleva PDF-keskustelutyönkulku voi auttaa asiakaspalvelijoita löytämään oikean vastauksen nopeammin, erityisesti silloin, kun lähdeviitteet osoittavat, mistä ohje on peräisin. Lopullista tuotosta voidaan hyödyntää uudelleen sisäisessä dokumentaatiossa tai asiakasvastausluonnoksissa.
Kokoukseen valmistautuminen ja seuranta
Jotkin PDF-tiedostot eivät ole lopullisia tuotoksia, vaan ne tarjoavat taustatietoa kokousta varten. Asiakasraportti, toimittajan ehdotus, hallituksen kokousaineisto, tuotemäärittely tai projektikatsaus voidaan muuttaa valmistelumuistiinpanoiksi ennen puhelua. Kokouksen jälkeen HiNoter voi yhdistää PDF:n tarjoaman taustan varsinaiseen keskusteluun, yhteenvetoon, päätöksiin ja toimenpiteisiin.
Tietosuoja- ja käyttöoikeusohjeet
Ennen kuin lataat PDF-tiedoston muuntimeen tai tekoälytyökaluun, varmista, että sinulla on lupa käsitellä sitä. Tämä on erityisen tärkeää luottamuksellisten sopimusten, työntekijätietojen, terveydenhuollon asiakirjojen, talousraporttien, asiakastietojen, maksullisen tutkimuksen, kurssimateriaalien ja tekijänoikeudella suojatun sisällön kohdalla. Käytä arkaluonteisten asiakirjojen käsittelyyn yrityksen hyväksymiä työnkulkuja ja poista tiedot, joita ei tarvitse käsitellä.
Käytännöllinen tietosuojatapa on luokitella tiedosto ennen lataamista. Kysy, onko se julkinen, sisäinen, luottamuksellinen, säännelty tai asiakkaan toimittama. Päätä sitten, kenellä pitäisi olla pääsy poimittuun tekstiin, yhteenvetoon, keskusteluvastauksiin ja vienteihin. Työkalun pitäisi vähentää rutiinityötä luomatta uutta hallitsematonta kopiota arkaluonteisista tiedoista.
Tiimeissä käyttöoikeuksien tulisi olla yhtä harkittuja kuin muistiinpanojenkin. Kokoukseen valmistautumiseen käytetty PDF-yhteenveto voi kuulua jaettuun projektityötilaan. Sopimusanalyysi voi kuulua vain lakitiimille ja asiakkuuksien omistajille. Tutkimusyhteenveto voi sopia laajemman tiimin käyttöön. Oikea työnkulku riippuu sisällöstä, ei vain muuntimen tarjoamasta kätevyydestä.
Milloin PDF-muuntimen tulisi muuttua tekoälypohjaiseksi tietotyönkuluksi
Käytä yksinkertaista muunninta, kun sinun tarvitsee vain kopioida tekstiä. Käytä tekoälypohjaista tietotyönkulkua, kun asiakirja vaikuttaa päätökseen, kokoukseen, projektiin, oppituntiin, asiakassuhteeseen tai sisäiseen prosessiin. Heti kun joku kysyy ”mitä tämä tarkoittaa?” tai ”mitä meidän pitäisi tehdä seuraavaksi?”, pelkkä tekstin poiminta ei riitä.
HiNoter on suunniteltu tähän jälkimmäiseen käyttötarkoitukseen. Se voi käsitellä asiakirjan sisältöä, tehdä siitä yhteenvedon, tunnistaa keskeiset kohdat, valmistella kokousmuistiinpanoja ja tukea lähteisiin linkitettyä AI Chat -keskustelua. Sama työtila voi käsitellä myös kokoustallenteita, videoita, ääntä ja muistiinpanoja, joten PDF-tiedostosta tulee osa laajempaa tietokokonaisuutta yksittäisen muunnoksen sijaan.
Jos tarvitset muutakin kuin tekstiä, HiNoter muuttaa PDF-sisällön poimituksi tekstiksi sekä yhteenvedoksi, keskeisiksi kohdiksi, kokousmuistiinpanoiksi, vienneiksi ja haettavaksi kysymys-vastausmateriaaliksi. Lataa käsittelyyn sallittu PDF, tarkista poimittu sisältö ja käytä tuotosta valmistautumiseen, päätöksentekoon, opettamiseen, tilannekatsauksiin tai seurantaan vähemmällä manuaalisella työllä.
Usein kysyttyä PDF-tiedostojen tekstiksi muuntamisen työnkuluista
Mikä on paras tapa muuntaa PDF tekstiin?
Paras menetelmä riippuu PDF-tiedoston tyypistä. Jos PDF sisältää valittavaa tekstiä, suora poiminta on yleensä nopeinta. Jos se on skannattu tai kuvapohjainen, käytä OCR:ää. Liiketoiminta- tai tutkimustyössä käytä työnkulkua, joka myös tekee osioista yhteenvedon ja pitää lähdeviitteet saatavilla tarkistamista varten.
Voiko PDF-tekstimuunnin lukea skannattuja asiakirjoja?
Kyllä, jos se sisältää OCR:n. OCR voi lukea tekstiä skannatuilta sivuilta ja kuvista, mutta laatu riippuu skannauksen selkeydestä, fontin luettavuudesta, sivun kulmasta, kontrastista sekä siitä, sisältääkö tiedosto käsinkirjoitusta, leimoja tai monimutkaisia asetteluja.
Mikä ero on PDF-tekstin poiminnan ja PDF-yhteenvedon välillä?
PDF-tekstin poiminta irrottaa sanat tiedostosta. PDF-yhteenveto selittää pääkohdat lyhyemmässä muodossa. Poiminta auttaa pääsemään käsiksi tekstiin, kun taas yhteenveto auttaa ymmärtämään sisällön nopeammin.
Mitä on lähteeseen perustuva PDF-keskustelu?
Lähteeseen perustuvassa PDF-keskustelussa voit esittää PDF-tiedostoa koskevia kysymyksiä ja saada vastauksia, jotka on yhdistetty lähteen sisältöön. Tämä on hyödyllistä, kun haluat tarkistaa, mistä vastaus on peräisin, sen sijaan että luottaisit yleiseen tekoälyvastaukseen.
Voiko HiNoter tehdä PDF-tiedostoista yhteenvedon?
HiNoter voi auttaa muuttamaan PDF-sisällön jäsennellyiksi yhteenvedoiksi, keskeisiksi kohdiksi, muistiinpanoiksi ja lähteisiin linkitetyiksi AI Chat -vastauksiksi. Se on erityisen hyödyllinen, kun PDF-tiedostoista on tehtävä kokoukseen valmistautumisen aineistoa, tutkimusmuistiinpanoja, sisäistä dokumentaatiota tai tiimin tietämystä.
Pitäisikö tekoälyn laatimat PDF-yhteenvedot tarkistaa?
Kyllä. Tarkista kriittiset yksityiskohdat, kuten luvut, päivämäärät, nimet, oikeudelliset ehdot, lähdeviitteet, velvoitteet ja suositukset. Tekoälyn laatimat yhteenvedot ovat hyödyllisiä nopeuden kannalta, mutta tärkeät päätökset tulisi aina yhdistää lähdeasiakirjaan.