Konverter PDF-a u tekst izdvaja čitljiv tekst iz PDF-a kako biste ga mogli kopirati, pretraživati, sažimati i ponovno upotrebljavati. Kod skeniranih PDF-ova OCR čita tekst sa slika. HiNoter ide korak dalje pretvarajući izdvojeni sadržaj PDF-a u sažetke, ključne točke, bilješke za pripremu sastanka i odgovore AI Chata povezane s izvorom.
Što je konverter PDF-a u tekst?
Konverter PDF-a u tekst softver je koji sadržaj zaključan unutar PDF-a pretvara u tekst koji se može uređivati i pretraživati. Zadatak zvuči jednostavno dok se ne susretnete sa stvarnim PDF-ovima koje ljudi upotrebljavaju: skeniranim ugovorima, izvezenim prezentacijama, akademskim radovima s fusnotama, priručnicima sa stupcima, izvješćima uprave punima tablica i dokumentima s mnogo slika u kojima su riječi tehnički dio slike.
Za studenta cilj može biti izdvojiti ključne ideje iz istraživačkog rada. Za voditelja proizvoda to može biti pretvaranje izvješća korisnika u pripremu za sastanak. Za pravni, korisnički ili operativni tim cilj može biti pronaći točnu rečenicu koja odgovara na pitanje bez ponovnog čitanja pedeset stranica. Izdvajanje sirovog teksta korisno je, ali samo je prvi korak. Prava vrijednost nastaje kada izdvojeni sadržaj postane strukturiran, sažet, citiran i ponovno upotrebljiv.
Tu se HiNoter prirodno uklapa. HiNoter je platforma za AI bilješke sa sastanaka i transkripciju, ali nije ograničena na sastanke. Timovi je mogu upotrebljavati za obradu PDF-ova, zvuka, videozapisa i dopuštenog mrežnog sadržaja u jednom radnom prostoru. Izvješće može postati sažetak. Priručnik može postati Q&A koji se može pretraživati. PDF koji se koristi prije sastanka može postati priprema za sastanak, uključujući pitanja, rizike i naknadne zadatke.
Tijek rada konvertera PDF-a u tekst: od statične datoteke do korisnih bilješki
Najčišći tijek rada nije jednostavno „prenesi PDF i kopiraj tekst”. Bolji tijek rada za PDF razdvaja izdvajanje od razumijevanja. Najprije alat utvrđuje ima li dokument tekst koji se može odabrati ili je potreban OCR. Zatim izdvaja sadržaj, zadržava dovoljno strukture za očuvanje značenja te omogućuje sažimanje, postavljanje upita ili izvoz rezultata.
| Korak | Što se događa | Zašto je važno |
|---|---|---|
| 1. Prenesite PDF | Dodajte izvješće, rad, priručnik, ugovor, prezentaciju ili materijal za nastavu koji smijete obrađivati. | Izvorna datoteka ostaje povezana s nastalim bilješkama i odgovorima. |
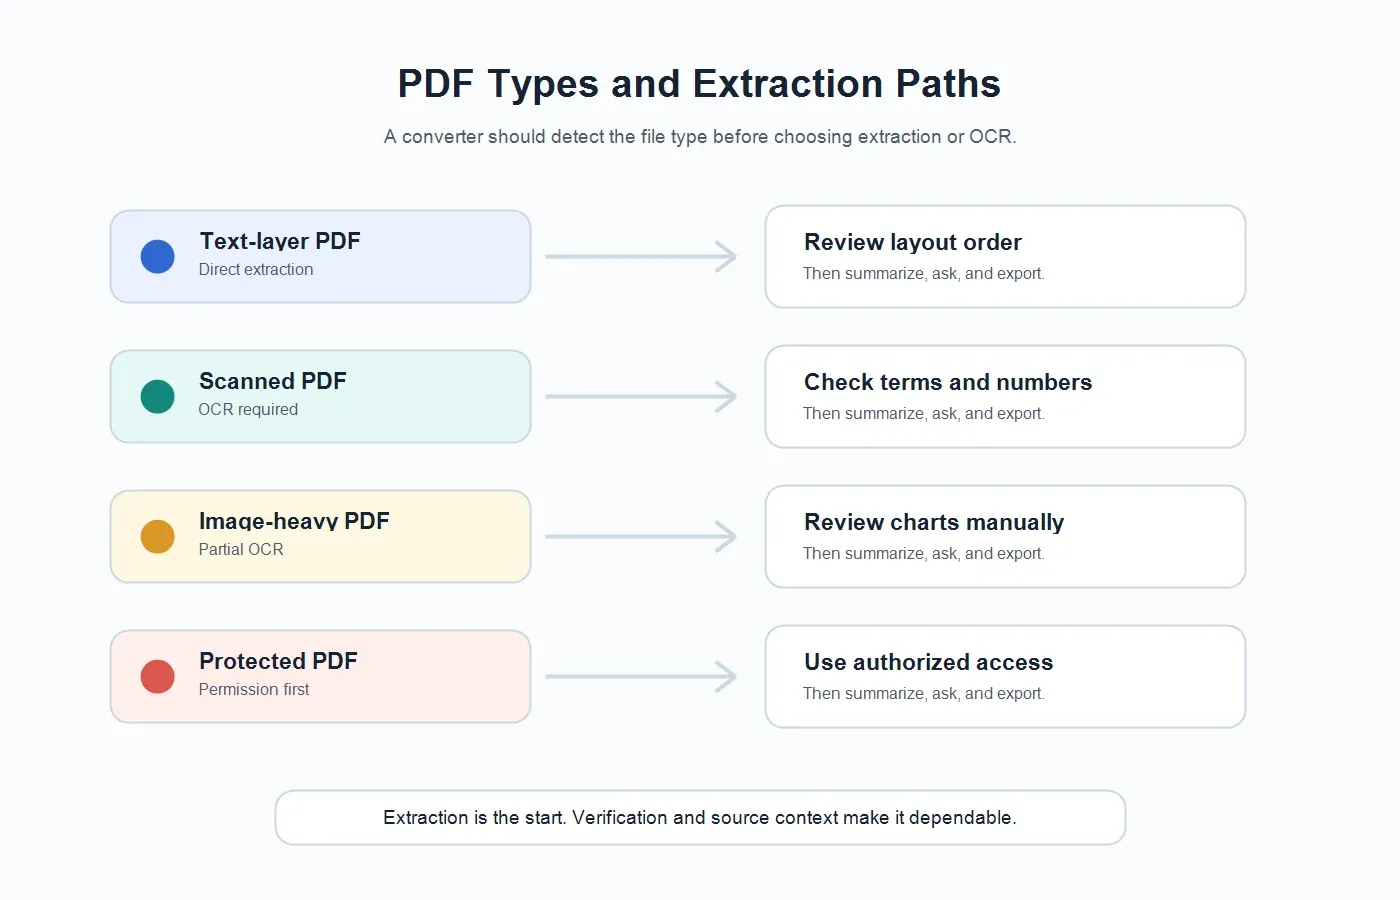
| 2. Otkrivanje vrste PDF-a | Sustav provjerava ima li PDF tekstualni sloj ili je potreban OCR. | Različite vrste PDF-ova zahtijevaju različite metode izdvajanja. |
| 3. Izdvojite tekst | Tekst koji se može odabrati izdvaja se izravno; tekst iz skeniranih dokumenata čita se putem OCR-a. | Dobivate sadržaj koji se može pretraživati, kopirati, pregledavati i sažimati. |
| 4. Očistite i strukturirajte | Odjeljci, naslovi, tablice, reference i kontekst stranice čuvaju se gdje je to moguće. | Čista struktura smanjuje broj pogrešnih sažetaka i neurednih bilješki. |
| 5. Sažmite i pitajte | HiNoter izrađuje sažetke, ključne točke, bilješke za pripremu sastanka i odgovore AI Chata povezane s izvorom. | PDF postaje upotrebljivo znanje, a ne samo izdvojeni tekst. |
Ako gradite ponovljiv timski proces, povežite tijek rada za PDF sa svojim širim sustavom bilješki. Na primjer, timovi koji već upotrebljavaju AI Chat za znanje sa sastanaka mogu upotrebljavati isti obrazac postavljanja pitanja povezanih s izvorom i za sadržaj PDF-a. Voditelj može pitati što se promijenilo između dvaju izvješća korisnika. Student može pitati koji je glavni argument rada. Voditelj korisničke podrške može pitati gdje priručnik objašnjava pravilo konfiguracije.
Objašnjenje OCR-a, PDF-ova s tekstualnim slojem i skeniranih PDF-ova
Ne pohranjuju svi PDF-ovi riječi na isti način. Neki PDF-ovi sadrže stvarni tekstualni sloj, što znači da riječi možete odabrati pokazivačem. Drugi su skenovi ili fotografije stranica, što znači da dokument sadrži slike na kojima se slučajno nalazi tekst. Konverter PDF-a u tekst mora podržavati obje vrste, inače će se rezultat činiti nepouzdanim.
Što je OCR?
OCR označava optičko prepoznavanje znakova. OCR čita tekst sa slike, skena ili fotografije i pretvara vidljive znakove u strojno čitljiv tekst. Koristan je za skenirane PDF-ove, fotografirane stranice, starije obrasce, papirnate ugovore i izvoze prezentacija temeljenih na slikama.
Kvaliteta OCR-a ovisi o izvoru. Jasni skenovi, ravne stranice, visok kontrast, čitljivi fontovi i malo rukopisa daju bolje rezultate. Iskrivljene stranice, slike niske razlučivosti, žigovi, sjene, složene tablice i miješani jezici mogu uzrokovati pogreške. Dobar tijek rada olakšava pregled umjesto da se pretvara da je svaki skenirani dokument savršen.
Što je PDF s tekstualnim slojem?
PDF s tekstualnim slojem već sadrži strojno čitljiv tekst iza vizualnog rasporeda. Riječi u datoteci obično možete odabrati, kopirati i pretraživati. PDF-ovi s tekstualnim slojem često nastaju izvozom iz alata Google Docs, Microsoft Word, dizajnerskih alata, platformi za izvješćivanje ili sustava za objavljivanje.
Te je datoteke obično lakše pretvoriti nego skenove, ali i dalje imaju rubne slučajeve. Rasporedi s više stupaca mogu se izdvojiti pogrešnim redoslijedom čitanja. Zaglavlja i podnožja mogu se ponavljati. Tablice se mogu razlomiti na zbunjujuće dijelove. Fusnote, citati i bočne trake mogu završiti na mjestima zbog kojih je izdvojeni tekst teško čitati. Zato bi koristan tijek rada za PDF trebao uključivati čišćenje, sažetke odjeljaka i provjeru izvora.
Skenirani PDF-ovi u odnosu na tekstualne PDF-ove: što očekivati
Prije nego što procijenite konverter, odredite vrstu PDF-a. Isti se alat može pokazati izvrsnim na čistom izvješću s tekstualnim slojem, a neurednim na fotografiranom ugovoru. Ova tablica pruža praktičan pregled onoga što se obično događa.
| Vrsta PDF-a | Kako se pronalazi tekst | Uobičajeno ograničenje | Najbolji tijek rada u HiNoteru |
|---|---|---|---|
| PDF s tekstualnim slojem | Konverter izdvaja ugrađeni tekst koji se može odabrati. | Stupci, zaglavlja, podnožja i tablice mogu se pojaviti pogrešnim redoslijedom. | Izdvojite tekst, sažmite ga po odjeljcima, a zatim postavite pitanja povezana s izvorom. |
| Skenirani PDF | OCR čita riječi sa slika stranica. | Točnost ovisi o kvaliteti skena, kontrastu, nagibu i jasnoći fonta. | Pokrenite OCR, pregledajte ključne pojmove, a zatim izradite bilješke i ključne točke. |
| PDF s mnogo slika | Tekst može biti ugrađen u grafikone, snimke zaslona ili slike slajdova. | Grafikoni i dijagrami mogu zahtijevati ljudski pregled za potpuno razumijevanje. | Izdvojite vidljivi tekst, sažmite narativ i označite odjeljke s mnogo vizualnog sadržaja. |
| PDF zaštićen lozinkom | Pristup ovisi o dopuštenjima i ograničenjima datoteke. | Neke se datoteke ne mogu obraditi dok ih ovlašteni korisnik ne otključa. | Upotrebljavajte samo dokumente kojima zakonito možete pristupiti, a zatim obradite dopuštenu datoteku. |
| PDF s mnogo tablica | Izdvajanje teksta čita ćelije, oznake i vrijednosti gdje je to moguće. | Složene tablice mogu izgubiti odnose između redaka i stupaca. | Izdvojite tekst, pregledajte brojeve i postavite ciljana pitanja s kontekstom izvora. |
Zašto sam izdvojeni tekst obično nije dovoljan
Mnogi PDF alati zaustavljaju se u trenutku kada proizvedu tekst. To je korisno ako vam je jedini cilj kopirati citat ili indeksirati datoteku. Manje je korisno kada je PDF istraživanje od dvadeset stranica, opsežno tržišno izvješće, dokument s pravilima, ugovor ili priručnik za obuku. I dalje morate pročitati izdvojeni tekst, odlučiti što je važno, pronaći tvrdnje vrijedne citiranja i pretvoriti dokument u nešto što vaš tim može upotrebljavati.
Za radnike koji se bave znanjem dublji problem nije pristup riječima. Problem je signal. Koji su odjeljci važni? Koji su rizici? Koja pitanja trebamo ponijeti na sastanak? Koje tvrdnje treba provjeriti? Što se promijenilo od posljednje verzije? Koju bi radnju netko trebao poduzeti nakon čitanja?
HiNoter je ovdje koristan jer tekst PDF-a tretira kao izvorni materijal za strukturirano znanje. PDF može postati izvršni sažetak, kratko istraživačko izvješće, skup bilješki za pripremu sastanka, tematska mapa ili prostor za pretraživi Q&A. Ako već upotrebljavate HiNoter kao tijek rada za AI bilješke sa sastanaka , obrada PDF-a postaje dio iste petlje znanja umjesto zasebnog posla s dokumentima.
PDF u tekst u odnosu na sažetak PDF-a i chat s PDF-om
Ti rezultati rješavaju različite zadatke. Sirovi prijepis PDF-a nije isto što i sažetak, a sažetak nije isto što i odgovor u chatu utemeljen na izvoru. Timovi postižu bolje rezultate kada odaberu izlaz koji odgovara odluci koju trebaju donijeti.
| Izlaz | Što vam pruža | Najbolji slučaj upotrebe |
|---|---|---|
| Ekstrahirani tekst | Čitljive riječi iz PDF-a, uz čišćenje gdje je to moguće. | Kopiranje citata, pretraživanje dokumenta, arhiviranje teksta ili priprema izvorne datoteke. |
| Sažetak PDF-a | Kraće objašnjenje glavnih ideja, nalaza, rizika ili preporuka. | Brzo razumijevanje izvješća prije sastanka, predavanja ili pregleda. |
| Ključne točke | Sažeti zaključci organizirani prema temi, odjeljku ili važnosti za donošenje odluka. | Informiranje nadređenog, priprema novosti za tim ili izrada bilježaka za učenje. |
| Bilješke za pripremu sastanka | Pitanja, točke dnevnog reda, rizici i odluke predložene na temelju sadržaja PDF-a. | Pretvaranje korisničkog izvješća, ugovora ili znanstvenog rada u usmjerenu raspravu. |
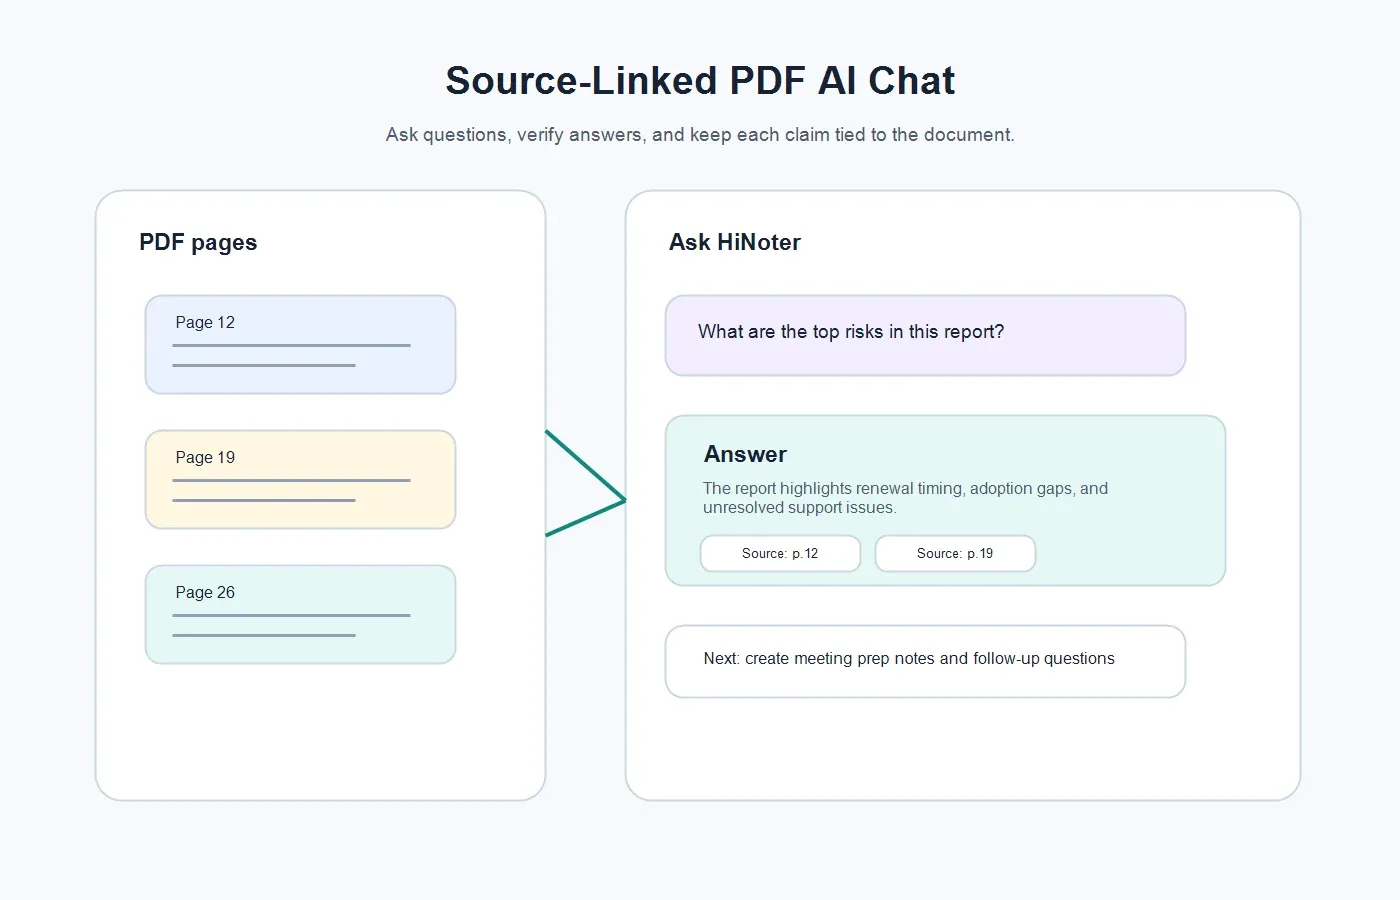
| AI chat povezan s izvorom | Odgovori utemeljeni na PDF-u, s poveznicama na izvorni sadržaj. | Postavljanje preciznih pitanja bez ponovnog čitanja cijelog dokumenta. |
Ako je izvor snimljeni webinar ili edukacija, a ne PDF, HiNoter može podržati i tijekove rada s videozapisima i zvukom. Za povezane vrste sadržaja pogledajte pretvaranje videozapisa u tekst i pretvaranje zvuka u tekst. Važna je dosljednost: jedan timski radni prostor može obrađivati sastanke, dokumente, videozapise i glasovni sadržaj umjesto rasipanja znanja po zasebnim alatima.
Kako HiNoter pretvara PDF-ove u znanje tima
HiNoter najbolje funkcionira kada je PDF dio stvarnog tijeka rada. Statična datoteka postaje korisna kada nekome pomaže da se pripremi, donese odluku, nešto objasni ili provede daljnje korake. Evo praktičnog postupka.
1. Prenesite PDF koji smijete obrađivati
Započnite s PDF-om koji posjedujete, koji ste izradili, primili za potrebe posla ili ga na drugi način smijete koristiti. To je važno za ugovore, nastavne materijale, plaćena izvješća, korisničke dokumente i autorski zaštićena istraživanja. Alat bi vam trebao pomoći da razumijete dokumente kojima možete zakonito pristupiti; ne bi se trebao koristiti za zaobilaženje ograničenja pristupa ili ponovnu upotrebu sadržaja bez dopuštenja.
2. Ekstrahirajte tekst ili pokrenite OCR
HiNoter prepoznaje čitljivi sadržaj i priprema ga za pregled. Ako PDF ima tekstualni sloj, ekstrakcija može biti izravna. Ako je skeniran, OCR pomaže u vraćanju vidljivog teksta. Za važne dokumente provjerite imena, datume, brojke, klauzule, citate i svaki odjeljak u kojem bi oblikovanje moglo utjecati na tumačenje.
3. Izradite sažetak odjeljka
Dobar sažetak PDF-a ne bi trebao svesti dokument na općenite tvrdnje. Trebao bi očuvati strukturu izvora: problem, dokaze, preporuku, rizik, ograničenje i sljedeći korak. Za izvješće to može značiti zasebno sažimanje izvršnog pregleda, nalaza, metodologije i preporuka. Za ugovor to može značiti odvajanje obveza, rokova, uvjeta obnove i otvorenih pitanja.
4. Izradite ključne točke i pripremu za sastanak
Nakon ekstrakcije sadržaja HiNoter ga može pretvoriti u praktične bilješke. Proizvodni tim može zatražiti probleme korisnika. Prodajni tim može zatražiti signale za kupnju ili prigovore. Student može zatražiti tezu, dokaze i definicije. Voditelj može zatražiti odluke koje treba donijeti na sljedećem sastanku. Tu PDF prelazi iz materijala za čitanje u upotrebljiv kontekst za tim.
5. Postavite pitanja povezana s izvorom
AI chat povezan s izvorom razlika je između samouvjerenog i pouzdanog odgovora. Umjesto labavog odgovora umjetne inteligencije, korisnik može postaviti pitanje i pratiti odgovor natrag do sadržaja PDF-a. To je posebno važno za istraživanja, usklađenost, tehničke priručnike, obveze prema korisnicima i izvješća za vodstvo.
Primjer: Pretvaranje korisničkog PDF izvješća u pripremu za sastanak
Zamislite da voditelj uspjeha korisnika primi PDF tromjesečnog poslovnog pregleda prije poziva o obnovi suradnje. Dokument uključuje grafikone korištenja proizvoda, povijest podrške, otvorene rizike, bilješke o proračunu, komentare dionika i ciljeve za sljedeće tromjesečje. Ekstrakcija teksta korisna je, ali voditelju ne govori kako voditi sastanak.
Uz HiNoter isti PDF može postati sažet pripremni dokument. Voditelj može pitati: Koji su najveći rizici za obnovu suradnje? Koji se zahtjevi za proizvod pojavljuju više puta? Koje je obveze korisnik preuzeo? Koja bismo pitanja trebali postaviti tijekom poziva? Što treba poslati timu za korisnički račun prije sastanka?
Dobivene bilješke mogu uključivati izvršni sažetak u jednom odlomku, tri rizika, pet pitanja za korisnika, vremenski slijed obveza i kratku predaju internom timu. Nakon sastanka HiNoter može povezati razgovor uživo s kontekstom PDF-a, tako da izvješće ne ostane u mapi dok se stvarne odluke sele u privatne bilješke ili chatove.
Primjer: Sažimanje znanstvenog rada bez gubitka izvora
Studentima, analitičarima i istraživačima često je potrebno više od sažetka u jednom odlomku. Moraju znati istraživačko pitanje, metodu, uzorak, glavni nalaz, ograničenja i tvrdnje vrijedne citiranja. Uobičajeni pretvarač PDF-a u tekst može vratiti riječi, ali neće automatski odlučiti koji su dijelovi važni za pregled literature, brifing ili prezentaciju.
Korisniji je tijek rada ekstrahirati tekst, sažeti svaki važan odjeljak, navesti ključne pojmove, prepoznati najjače dokaze i postaviti dodatna pitanja s referencama. Na primjer: Koja je središnja tvrdnja rada? Koji je dokazi podupiru? Koje pretpostavke treba preispitati? Koji odlomak definira glavni pojam? Koji odjeljak objašnjava ograničenja?
Budući da HiNoter podržava odgovore povezane s izvorom, korisnik može zadržati povezanost sažetka s izvornim sadržajem. To olakšava provjeru i ponovnu upotrebu rezultata u bilješkama s nastave, istraživačkim dopisima ili timskim dokumentima.
Uobičajeni problemi pri ekstrakciji PDF-a i kako ih riješiti
PDF-ovi su izrađeni tako da očuvaju vizualni raspored, a ne nužno da olakšaju ekstrakciju teksta. Kada rezultati izgledaju neuredno, problem je često u formatu izvora, a ne samo u pretvaraču. Evo problema koje vrijedi provjeriti prije nego što se oslonite na rezultat.
| Problem | Što možete vidjeti | Kako poboljšati rezultat |
|---|---|---|
| Niska kvaliteta skena | Nedostajuće riječi, pogrešni znakovi ili prekinuti redci. | Upotrijebite jasniji sken, poboljšajte kontrast i ručno provjerite važne pojmove. |
| Raspored u više stupaca | Tekst iz jednog stupca može se pomiješati s drugim. | Sažmite prema odjeljcima i provjerite redoslijed čitanja prije dijeljenja. |
| Složene tablice | Redci i stupci mogu izgubiti međusobne odnose. | Provjerite brojke i oznake, a zatim postavite konkretna pitanja o tablici. |
| Zaglavlja i podnožja | Ponavljajući tekst sa stranica može zatrpati ekstrakciju. | Očistite ponavljajući sadržaj prije izrade konačnih bilješki. |
| Zaštićena datoteka | Konverter možda neće moći pristupiti sadržaju. | Upotrebljavajte samo ovlaštenu verziju dokumenta i poštujte ograničenja datoteke. |
Kontrolni popis kvalitete prije dijeljenja bilješki iz PDF-a
Umjetna inteligencija može ubrzati postupak, ali bilješke o dokumentu i dalje treba pregledati. Prije nego što podijelite sažetak PDF-a s timom, provjerite stavke koje mogu promijeniti značenje dokumenta.
- Potvrdite naslov dokumenta, datum, autora, verziju i izvor.
- Provjerite imena, nazive proizvoda, kratice, brojke, rokove i citate.
- Provjerite je li PDF skeniran, temeljen na tekstu, prepun tablica ili prepun slika.
- Pitajte se čuva li sažetak strukturu i ograničenja dokumenta.
- Provjerite ključne tvrdnje prema izvornim referencama prije nego što ih upotrijebite u donošenju odluka.
- Odvojite činjenice od tumačenja, preporuka i otvorenih pitanja.
- Izvezite konačne bilješke u radni prostor u kojem tim već radi.
Za mnoge timove upravo je posljednji korak mjesto na kojem se rad s dokumentima prekida. Netko pročita PDF, izradi privatni sažetak i pošalje poruku koja nikad ne postane trajno znanje tima. HiNoter može pomoći premostiti taj jaz izvozom strukturiranih bilješki u timske sustave kao što su Notion i Google Docs, tako da rezultat može biti tamo gdje ljudi planiraju, pišu i prate daljnje korake.
Za što koristiti pretvarač PDF-a u tekst
Pretvarač PDF-a u tekst koristan je kad god je sadržaj vrijedan, ali zarobljen u statičnom formatu. Najbolji slučajevi upotrebe ne odnose se samo na pretvaranje; riječ je o skraćivanju vremena između primitka dokumenta i kvalitetnog korištenja njegovih informacija.
Izvješća i sažeci za rukovodstvo
Izvješća za rukovodstvo često sadrže više pojedinosti nego što ih zaposleni čitatelji mogu usvojiti prije sastanka. Izdvajanje teksta omogućuje izradu sažetka, prepoznavanje preporučenih odluka i pripremu pitanja za raspravu. HiNoter može pretvoriti dugačak PDF u sažetak koji ističe problem, dokaze, preporuku, rizik i sljedeći korak.
Ugovori i dokumenti s pravilima
Ugovori i PDF-ovi s pravilima zahtijevaju pažljivo čitanje. Umjetna inteligencija ne bi trebala zamijeniti pravnu provjeru, ali može pomoći u organizaciji prvog pregleda: obveze, datumi obnove, iznimke, otvorena pitanja i odredbe koje zahtijevaju ljudsku pažnju. Odgovori povezani s izvorom ovdje su posebno korisni jer čitatelj može provjeriti svaku važnu tvrdnju u izvornom tekstu.
Istraživački radovi i bilješke s predavanja
Akademski PDF-ovi namjerno su sadržajno gusti. Studenti i istraživači mogu koristiti izdvajanje teksta zajedno sa sažecima koje je izradila umjetna inteligencija kako bi prepoznali definicije, metode, tvrdnje, dokaze i ograničenja. Umjesto kopiranja odlomaka u zasebnu aplikaciju za bilješke, korisnik može pretvoriti rad u strukturirane bilješke za učenje i postavljati dodatna pitanja.
Priručnici i znanje za podršku
Timovi za podršku često rade s priručnicima, vodičima za proizvode, uputama za postavljanje i PDF-ovima za otklanjanje poteškoća. Tijek rada s razgovorom o PDF-u koji se može pretraživati može agentima pomoći da brže pronađu pravi odgovor, osobito kada izvorne reference pokazuju odakle uputa potječe. Konačni rezultat može se ponovno upotrijebiti u internoj dokumentaciji ili nacrtima odgovora korisnicima.
Priprema za sastanak i daljnje aktivnosti
Neki PDF-ovi nisu konačni rezultat; oni su kontekst za sastanak. Izvješće o korisniku, prijedlog dobavljača, materijali za upravu, specifikacija proizvoda ili pregled projekta mogu se pretvoriti u bilješke za pripremu prije poziva. Nakon sastanka HiNoter može povezati kontekst PDF-a sa stvarnom raspravom, sažetkom, odlukama i zadacima.
Smjernice za privatnost i dopuštenja
Prije učitavanja bilo kojeg PDF-a u pretvarač ili alat umjetne inteligencije provjerite smijete li ga obrađivati. To je osobito važno za povjerljive ugovore, evidencije zaposlenika, zdravstvene dokumente, financijska izvješća, podatke korisnika, plaćena istraživanja, materijale za tečajeve i sadržaj zaštićen autorskim pravima. Za osjetljive dokumente koristite tijekove rada koje je odobrila tvrtka i uklonite informacije koje ne treba obrađivati.
Praktična navika vezana uz privatnost jest klasificirati datoteku prije učitavanja. Zapitajte se je li javna, interna, povjerljiva, regulirana ili ju je dostavio korisnik. Zatim odlučite tko treba imati pristup izdvojenom tekstu, sažetku, odgovorima u razgovoru i izvezenim datotekama. Alat bi trebao smanjiti rutinski posao bez stvaranja nove nekontrolirane kopije osjetljivih informacija.
Za timove bi dopuštenja trebala biti jednako promišljena kao i same bilješke. Sažetak PDF-a koji se koristi za pripremu sastanka možda pripada zajedničkom radnom prostoru projekta. Analiza ugovora možda treba biti dostupna samo pravnom timu i vlasnicima korisničkih računa. Sažetak istraživanja možda može biti dostupan širem timu. Ispravan tijek rada ovisi o sadržaju, a ne samo o praktičnosti pretvarača.
Kada pretvarač PDF-a treba postati tijek rada za znanje uz pomoć umjetne inteligencije
Koristite jednostavan pretvarač kada samo trebate kopirati tekst. Tijek rada za znanje uz pomoć umjetne inteligencije koristite kada će dokument utjecati na odluku, sastanak, projekt, nastavu, odnos s korisnikom ili interni proces. Čim netko pita "što ovo znači?" ili "što bismo trebali učiniti sljedeće?", samo izdvajanje više nije dovoljno.
HiNoter je osmišljen za tu drugu kategoriju. Može preuzeti sadržaj dokumenta, sažeti ga, prepoznati ključne točke, pripremiti bilješke sa sastanka i omogućiti AI Chat s poveznicama na izvore. Isti radni prostor može obrađivati i snimke sastanaka, videozapise, audiozapise i bilješke, pa PDF postaje dio šireg zapisa znanja, a ne jednokratna konverzija.
Ako vam treba više od teksta, HiNoter pretvara sadržaj PDF-a u izdvojeni tekst sa sažetkom, ključnim točkama, bilješkama sa sastanka, izvozima i mogućnošću pretraživanja pitanja i odgovora. Učitajte dopušteni PDF, pregledajte izdvojeni sadržaj i upotrijebite rezultat za pripremu, donošenje odluka, podučavanje, informiranje ili daljnje aktivnosti uz manje ručnog rada.
Često postavljana pitanja o tijekovima rada za pretvaranje PDF-a u tekst
Koji je najbolji način za pretvaranje PDF-a u tekst?
Najbolja metoda ovisi o vrsti PDF-a. Ako PDF sadrži tekst koji se može označiti, izravno izdvajanje obično je najbrže. Ako je skeniran ili se temelji na slikama, koristite OCR. Za poslovni ili istraživački rad koristite tijek rada koji također sažima odjeljke i zadržava izvorne reference dostupnima za pregled.
Može li pretvarač PDF-a u tekst čitati skenirane dokumente?
Da, ako uključuje OCR. OCR može čitati tekst sa skeniranih stranica i slika, ali kvaliteta ovisi o jasnoći skena, čitljivosti fonta, kutu stranice, kontrastu te o tome sadrži li datoteka rukopis, pečate ili složene rasporede.
Koja je razlika između izdvajanja sadržaja iz PDF-a i sažimanja PDF-a?
Izdvajanje iz PDF-a izvlači riječi iz datoteke. Sažimanje PDF-a objašnjava glavne točke u kraćem obliku. Izdvajanje vam pomaže pristupiti tekstu, a sažimanje vam pomaže brže razumjeti sadržaj.
Što je razgovor o PDF-u utemeljen na izvoru?
Razgovor o PDF-u utemeljen na izvoru omogućuje vam postavljanje pitanja o PDF-u i primanje odgovora povezanih s izvornim sadržajem. To je korisno kada trebate provjeriti odakle odgovor potječe, umjesto da se oslanjate na generički odgovor umjetne inteligencije.
Može li HiNoter sažeti PDF datoteke?
HiNoter može pomoći pretvoriti sadržaj PDF-a u strukturirane sažetke, ključne točke, bilješke i odgovore AI Chata povezane s izvorom. Posebno je koristan kada PDF-ovi trebaju postati priprema za sastanak, istraživačke bilješke, interna dokumentacija ili znanje tima.
Trebam li pregledati sažetke PDF-a koje je izradila umjetna inteligencija?
Da. Pregledajte ključne pojedinosti poput brojeva, datuma, imena, pravnih izraza, citata, obveza i preporuka. Sažeci umjetne inteligencije korisni su zbog brzine, ali važne odluke trebaju ostati povezane s izvornim dokumentom.