En PDF-til-tekst-konverter udtrækker læsbar tekst fra en PDF, så du kan kopiere, søge i, opsummere og genbruge den. For scannede PDF'er læser OCR tekst fra billeder. HiNoter går videre ved at omdanne udtrukket PDF-indhold til opsummeringer, hovedpunkter, noter til mødeforberedelse og AI Chat-svar med kildelinks.
Hvad er en PDF-til-tekst-konverter?
En PDF-til-tekst-konverter er software, der tager indhold, som er låst inde i en PDF, og omdanner det til redigerbar, søgbar tekst. Opgaven lyder enkel, indtil du møder de virkelige PDF'er, som folk faktisk bruger: scannede kontrakter, eksporterede præsentationer, akademiske artikler med fodnoter, manualer med kolonner, bestyrelsesrapporter fulde af tabeller og billedtunge dokumenter, hvor ordene teknisk set er en del af et billede.
For en studerende kan målet være at udtrække de vigtigste idéer fra en forskningsartikel. For en produktchef kan det være at omdanne en kunderapport til mødeforberedelse. For et juridisk team, supportteam eller driftsteam kan målet være at finde den præcise sætning, der besvarer et spørgsmål, uden at genlæse halvtreds sider. Rå tekstudtræk er nyttigt, men det er kun det første skridt. Den virkelige værdi opstår, når det udtrukne indhold bliver struktureret, opsummeret, kildeangivet og genanvendeligt.
Det er her, HiNoter passer naturligt ind. HiNoter er en platform til AI-mødenoter og transskription, men den er ikke begrænset til møder. Teams kan bruge den til at behandle PDF'er, lyd, video og tilladt onlineindhold i ét arbejdsområde. En rapport kan blive til en opsummering. En manual kan blive til søgbar spørgsmål og svar. En PDF, der bruges før et møde, kan blive til forberedelsesnoter, spørgsmål, risici og opfølgningsopgaver.
Arbejdsgang for PDF-til-tekst-konvertering: Fra statisk fil til nyttige noter
Den enkleste arbejdsgang er ikke bare "upload en PDF og kopier teksten". En bedre PDF-arbejdsgang adskiller udtræk fra forståelse. Først identificerer værktøjet, om dokumentet har tekst, der kan markeres, eller kræver OCR. Derefter udtrækker det indholdet, bevarer tilstrækkelig struktur til at fastholde betydningen og lader dig opsummere, stille spørgsmål til eller eksportere resultatet.
| Trin | Hvad sker der? | Hvorfor er det vigtigt? |
|---|---|---|
| 1. Upload PDF'en | Tilføj en rapport, artikel, manual, kontrakt, præsentation eller undervisningsopgave, som du har tilladelse til at behandle. | Kildefilen forbliver forbundet med de resulterende noter og svar. |
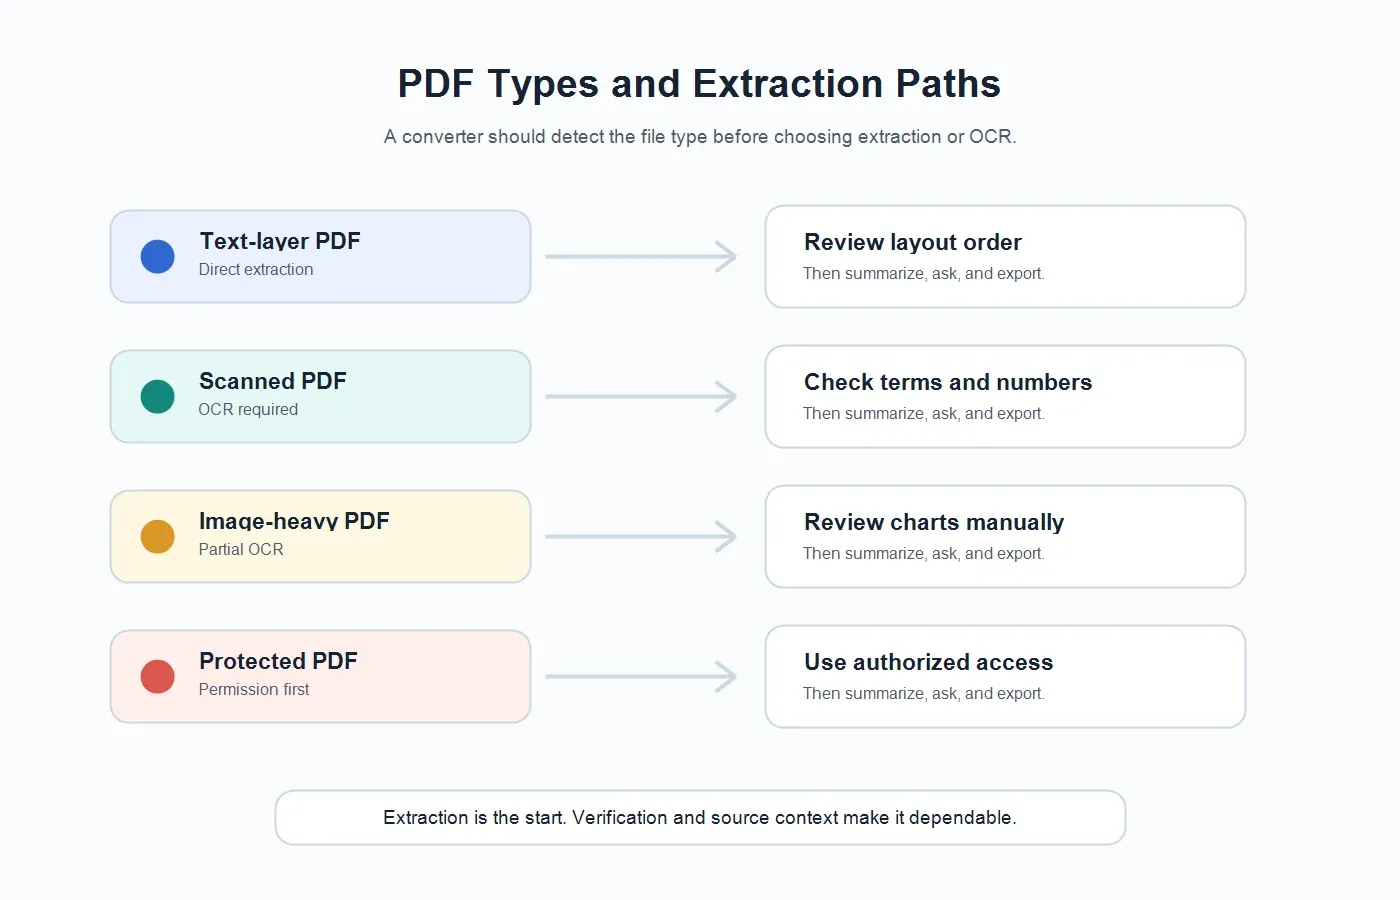
| 2. Identificer PDF-typen | Systemet kontrollerer, om PDF'en har et tekstlag eller kræver OCR. | Forskellige PDF-typer kræver forskellige udtræksmetoder. |
| 3. Udtræk tekst | Tekst, der kan markeres, hentes direkte; scannet tekst aflæses gennem OCR. | Du får indhold, der kan søges i, kopieres, gennemgås og opsummeres. |
| 4. Rens og strukturer | Afsnit, overskrifter, tabeller, referencer og sidekontekst bevares, hvor det er muligt. | En ren struktur reducerer fejl i opsummeringer og ødelagte noter. |
| 5. Opsummer og spørg | HiNoter opretter opsummeringer, hovedpunkter, noter til mødeforberedelse og AI Chat-svar med kildelinks. | PDF'en bliver til anvendelig viden, ikke bare udtrukket tekst. |
Hvis du er ved at opbygge en gentagelig teamproces, kan du forbinde PDF-arbejdsgangen med dit bredere notesystem. Teams, der allerede bruger AI Chat til mødeviden, kan for eksempel bruge det samme mønster for kildelinkede spørgsmål til PDF-indhold. En leder kan spørge, hvad der har ændret sig mellem to kunderapporter. En studerende kan spørge efter hovedargumentet i en artikel. En supportleder kan spørge, hvor en manual forklarer en konfigurationsregel.
OCR, PDF'er med tekstlag og scannede PDF'er forklaret
Ikke alle PDF'er gemmer ord på samme måde. Nogle PDF'er indeholder et ægte tekstlag, hvilket betyder, at du kan markere ord med markøren. Andre er scanninger eller fotos af sider, hvilket betyder, at dokumentet indeholder billeder, der tilfældigvis viser tekst. En PDF-til-tekst-konverter skal kunne håndtere begge dele, ellers vil resultatet føles upålideligt.
Hvad er OCR?
OCR står for optisk tegngenkendelse. OCR læser tekst fra et billede, en scanning eller et foto og omdanner de synlige tegn til maskinlæsbar tekst. Det er nyttigt til scannede PDF'er, fotograferede sider, ældre formularer, papirkontrakter og billedbaserede eksporterede præsentationer.
OCR-kvaliteten afhænger af kilden. Klare scanninger, lige sider, høj kontrast, læselige skrifttyper og minimal håndskrift giver bedre resultater. Skæve sider, billeder i lav opløsning, stempler, skygger, komplekse tabeller og blandede sprog kan skabe fejl. En god arbejdsgang gør gennemgang nem i stedet for at lade som om, at alle scannede dokumenter er perfekte.
Hvad er en PDF med tekstlag?
En PDF med tekstlag indeholder allerede maskinlæsbar tekst bag det visuelle layout. Du kan normalt markere, kopiere og søge i ordene i filen. PDF'er med tekstlag stammer ofte fra eksporterede dokumenter fra Google Docs, Microsoft Word, designværktøjer, rapporteringsplatforme eller publiceringssystemer.
Disse filer er normalt nemmere at konvertere end scanninger, men de har stadig særlige tilfælde. Layout med flere kolonner kan blive udtrukket i den forkerte læserækkefølge. Sidehoveder og sidefødder kan blive gentaget. Tabeller kan blive opdelt i forvirrende fragmenter. Fodnoter, citater og sidebokse kan ende steder, der gør den udtrukne tekst svær at læse. Derfor bør en nyttig PDF-arbejdsgang omfatte oprydning, sektionsopsummeringer og kildekontrol.
Scannede PDF'er vs. tekst-PDF'er: Hvad kan du forvente?
Identificér PDF-typen, før du vurderer en konverter. Det samme værktøj kan fungere fremragende på en ren rapport med tekstlag og rodet på en fotograferet kontrakt. Denne tabel giver et praktisk overblik over, hvad der normalt sker.
| PDF-type | Hvordan findes teksten? | Typisk begrænsning | Bedste HiNoter-arbejdsgang |
|---|---|---|---|
| PDF med tekstlag | Konverteren udtrækker indlejret tekst, der kan markeres. | Kolonner, sidehoveder, sidefødder og tabeller kan optræde i forkert rækkefølge. | Udtræk tekst, opsummer efter afsnit, og stil derefter kildelinkede spørgsmål. |
| Scannet PDF | OCR læser ord fra billeder af sider. | Nøjagtigheden afhænger af scanningskvalitet, kontrast, skævhed og skrifttypens tydelighed. | Kør OCR, gennemgå kritiske termer, og opret derefter noter og hovedpunkter. |
| Billedtung PDF | Tekst kan være indlejret i diagrammer, skærmbilleder eller billeder af slides. | Diagrammer og illustrationer kan kræve menneskelig gennemgang for at få den fulde betydning. | Udtræk synlig tekst, opsummer fortællingen, og markér billedtunge afsnit. |
| Adgangskodebeskyttet PDF | Adgangen afhænger af tilladelser og filbegrænsninger. | Nogle filer kan ikke behandles, før de låses op af en autoriseret bruger. | Brug kun dokumenter, som du har lovlig adgang til, og behandl derefter den tilladte fil. |
| PDF med mange tabeller | Tekstudtræk læser celler, etiketter og værdier, hvor det er muligt. | Komplekse tabeller kan miste forbindelserne mellem rækker og kolonner. | Udtræk tekst, gennemgå tal, og stil målrettede spørgsmål med kildekontekst. |
Hvorfor udtrukket tekst alene normalt ikke er nok
Mange PDF-værktøjer stopper, når de har produceret tekst. Det er nyttigt, hvis dit eneste mål er at kopiere et citat eller indeksere en fil. Det er mindre nyttigt, når PDF'en er tyve siders forskning, en tæt markedsrapport, et politisk dokument, en kontrakt eller en træningsmanual. Du skal stadig læse den udtrukne tekst, afgøre hvad der er vigtigt, finde de påstande, der er værd at citere, og omdanne dokumentet til noget, dit team kan bruge.
For vidensarbejdere er det dybere problem ikke adgang til ord. Det er signalet. Hvilke afsnit er vigtige? Hvilke risici er der? Hvilke spørgsmål bør vi tage med til mødet? Hvilke påstande skal verificeres? Hvad har ændret sig siden den seneste version? Hvilken handling bør nogen foretage efter at have læst dette?
HiNoter er nyttigt her, fordi det behandler PDF-tekst som kildemateriale til struktureret viden. PDF'en kan blive til en ledelsesopsummering, en researchbrief, et sæt noter til mødeforberedelse, et emnekort eller et søgbart spørgsmål-og-svar-område. Hvis du allerede bruger HiNoter som en arbejdsgang til AI-mødenoter , bliver PDF-behandling en del af den samme videnssløjfe i stedet for en separat dokumentopgave.
PDF til tekst vs. PDF-opsummering vs. PDF-chat
Disse output løser forskellige opgaver. En rå transskription af PDF'en er ikke det samme som en opsummering, og en opsummering er ikke det samme som et kildebaseret chatsvar. Teams opnår bedre resultater, når de vælger det output, der passer til den beslutning, de skal træffe.
| Output | Hvad det giver dig | Bedste anvendelse |
|---|---|---|
| Udtrukket tekst | De læsbare ord fra PDF'en med oprydning, hvor det er muligt. | Kopiering af citater, søgning i dokumentet, arkivering af tekst eller forberedelse af en kildefil. |
| PDF-resumé | En kortere forklaring af de vigtigste idéer, resultater, risici eller anbefalinger. | Hurtigt at forstå en rapport før et møde, en undervisningstime eller en gennemgang. |
| Hovedpunkter | Punktvise hovedpointer organiseret efter emne, afsnit eller relevans for beslutninger. | Orientering af en leder, forberedelse af en teamopdatering eller oprettelse af studienoter. |
| Noter til mødeforberedelse | Spørgsmål, dagsordenspunkter, risici og beslutninger foreslået ud fra PDF'ens indhold. | At omdanne en kunderapport, kontrakt eller forskningsartikel til en fokuseret diskussion. |
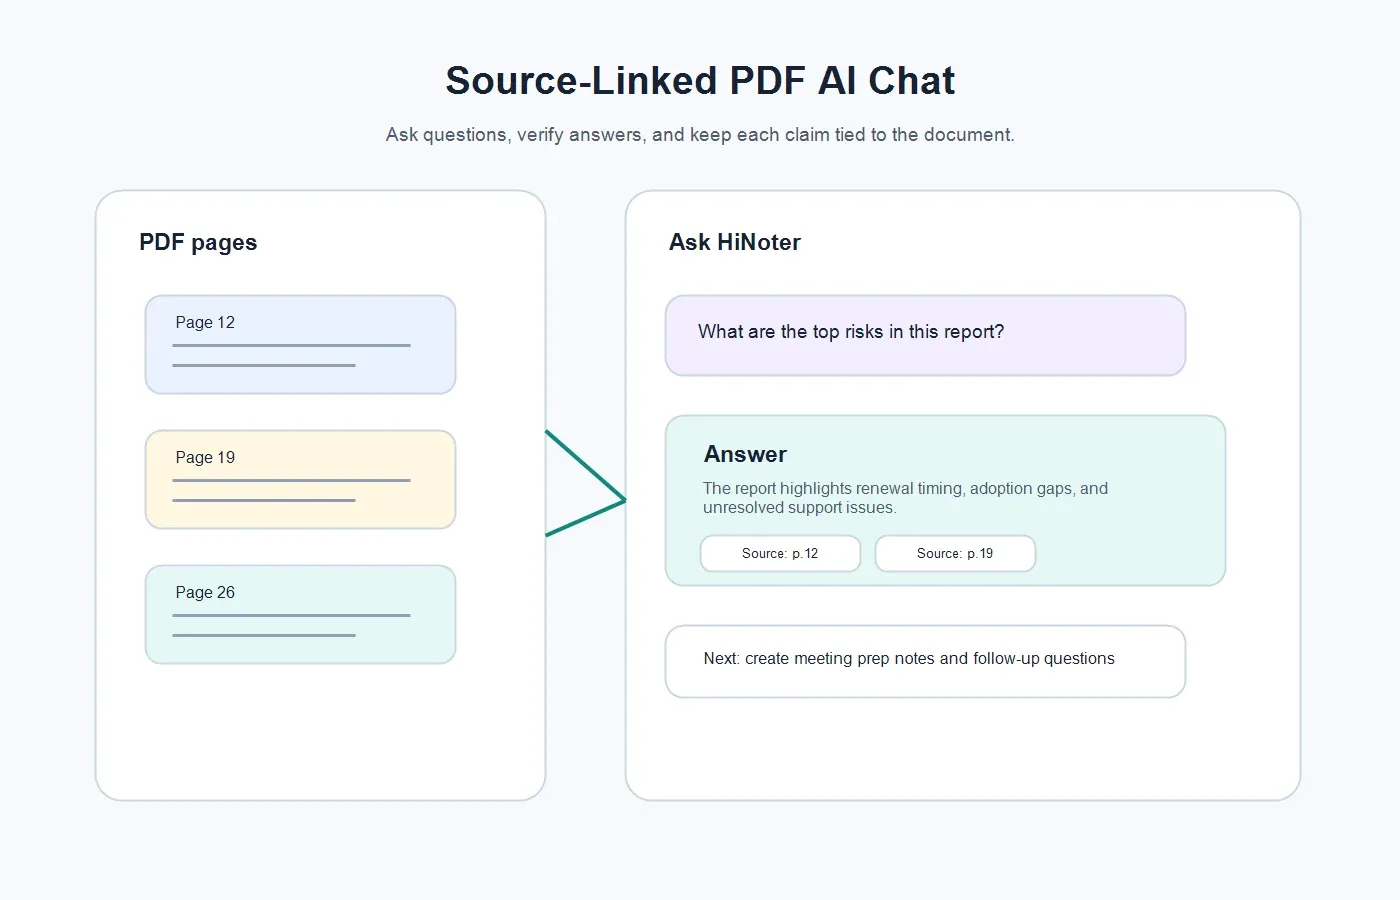
| Kildeknyttet AI-chat | Svar baseret på PDF'en med henvisninger tilbage til kildeindholdet. | At stille præcise spørgsmål uden at genlæse hele dokumentet. |
Hvis kilden er et optaget webinar eller en undervisningssession i stedet for en PDF, kan HiNoter også understøtte video- og lydarbejdsgange. Se video til tekst og lyd til tekst for relaterede indholdstyper. Det vigtige er ensartethed: Ét teamarbejdsområde kan håndtere møder, dokumenter, videoer og stemmeindhold i stedet for at sprede viden på separate værktøjer.
Sådan omdanner HiNoter PDF'er til teamviden
HiNoter fungerer bedst, når PDF'en er en del af en reel arbejdsgang. En statisk fil bliver nyttig, når den hjælper nogen med at forberede, beslutte, forklare eller følge op. Her er den praktiske proces.
1. Upload en PDF, du har tilladelse til at behandle
Start med en PDF, du ejer, har oprettet, har modtaget i forbindelse med arbejdet eller på anden måde har tilladelse til at bruge. Det er vigtigt for kontrakter, kursusmaterialer, betalte rapporter, kundedokumenter og ophavsretligt beskyttet forskning. Et værktøj bør hjælpe dig med at forstå dokumenter, som du har lovlig adgang til; det bør ikke bruges til at omgå adgangsbegrænsninger eller genbruge indhold uden tilladelse.
2. Udtræk tekst eller kør OCR
HiNoter identificerer det læsbare indhold og forbereder det til gennemgang. Hvis PDF'en har et tekstlag, kan udtrækningen ske direkte. Hvis den er scannet, hjælper OCR med at gendanne synlig tekst. For kritiske dokumenter skal du gennemgå navne, datoer, tal, klausuler, henvisninger og alle afsnit, hvor formateringen kan påvirke fortolkningen.
3. Generér et resumé af et afsnit
Et godt PDF-resumé bør ikke reducere dokumentet til generiske udsagn. Det bør bevare kildens struktur: problem, evidens, anbefaling, risiko, begrænsning og næste skridt. For en rapport kan det betyde, at ledelsesoverblikket, resultaterne, metoden og anbefalingerne opsummeres separat. For en kontrakt kan det betyde, at forpligtelser, frister, fornyelsesvilkår og åbne spørgsmål adskilles.
4. Opret hovedpunkter og mødeforberedelse
Når indholdet er udtrukket, kan HiNoter omdanne det til praktiske noter. Et produktteam kan bede om kundernes udfordringer. Et salgsteam kan spørge efter købssignaler eller indvendinger. En studerende kan spørge efter tese, evidens og definitioner. En leder kan spørge efter de beslutninger, der er nødvendige på det næste møde. Det er her, PDF'en går fra læsemateriale til brugbar teamkontekst.
5. Stil kildeknyttede spørgsmål
Kildeknyttet AI-chat er forskellen mellem et selvsikkert svar og et troværdigt svar. I stedet for at modtage et løst AI-svar kan brugeren stille et spørgsmål og spore svaret tilbage til PDF-indholdet. Det er særligt vigtigt for forskning, compliance, tekniske manualer, kundeforpligtelser og ledelsesrapporter.
Eksempel: Omdannelse af en kunderapport i PDF-format til mødeforberedelse
Forestil dig, at en customer success-manager modtager en PDF med en kvartalsvis forretningsgennemgang før et fornyelsesopkald. Dokumentet indeholder diagrammer over produktanvendelse, supporthistorik, åbne risici, budgetnoter, kommentarer fra interessenter og mål for næste kvartal. Det er nyttigt at udtrække teksten, men det fortæller ikke manageren, hvordan mødet skal gennemføres.
Med HiNoter kan den samme PDF blive til en kort forberedelsesbrief. Manageren kan spørge: Hvad er de største fornyelsesrisici? Hvilke produktønsker optræder mere end én gang? Hvilke forpligtelser påtog kunden sig? Hvilke spørgsmål bør vi stille under opkaldet? Hvad skal sendes til account-teamet før mødet?
De resulterende noter kan indeholde et resumé på ét afsnit til ledelsen, tre risici, fem spørgsmål til kunden, en tidslinje over forpligtelser og en kort overlevering til det interne team. Efter mødet kan HiNoter forbinde den aktuelle diskussion med PDF-konteksten, så rapporten ikke ligger i en mappe, mens de faktiske beslutninger flyttes til private noter eller chattråde.
Eksempel: Opsummering af en forskningsartikel uden at miste kilden
Studerende, analytikere og forskere har ofte brug for mere end et resumé på ét afsnit. De har brug for at kende forskningsspørgsmålet, metoden, stikprøven, hovedresultatet, begrænsningerne og de påstande, der er værd at citere. En rå PDF-til-tekst-konverter kan gendanne ordene, men den afgør ikke automatisk, hvilke dele der er vigtige for et litteraturstudie, en briefing eller en præsentation.
En mere nyttig arbejdsgang er at udtrække teksten, opsummere hvert større afsnit, opliste nøglebegreberne, identificere den stærkeste evidens og stille opfølgende spørgsmål med henvisninger. For eksempel: Hvad er artiklens centrale påstand? Hvilken evidens understøtter den? Hvilke antagelser bør udfordres? Hvilket afsnit definerer hovedbegrebet? Hvilket afsnit forklarer begrænsningerne?
Fordi HiNoter understøtter kildeknyttede svar, kan brugeren holde resuméet forbundet med det oprindelige indhold. Det gør resultatet lettere at kontrollere og lettere at genbruge i noter fra undervisningen, forskningsnotater eller teamdokumenter.
Almindelige problemer ved PDF-udtrækning, og hvordan de håndteres
PDF'er er skabt til at bevare et visuelt layout, ikke altid til at gøre tekstudtrækning let. Når resultaterne ser rodede ud, skyldes problemet ofte kildeformatet og ikke blot konverteren. Her er de problemer, det er værd at kontrollere, før du stoler på resultatet.
| Problem | Det kan du se | Sådan forbedres resultatet |
|---|---|---|
| Lav scanningskvalitet | Manglende ord, forkerte tegn eller ødelagte linjer. | Brug en tydeligere scanning, forbedr kontrasten, og gennemgå vigtige termer manuelt. |
| Layout med flere kolonner | Tekst fra én kolonne kan blive blandet med tekst fra en anden. | Opsummér efter afsnit, og kontrollér læserækkefølgen, før du deler resultatet. |
| Komplekse tabeller | Rækker og kolonner kan miste deres sammenhænge. | Gennemgå tal og etiketter, og stil derefter specifikke spørgsmål om tabellen. |
| Sidehoveder og sidefødder | Gentaget tekst fra siderne kan rode udtrækningen til. | Ryd gentaget materiale op, før du opretter de endelige noter. |
| Beskyttet fil | Konverteren kan muligvis ikke få adgang til indholdet. | Brug kun en autoriseret version af dokumentet, og respekter filbegrænsningerne. |
Kvalitetstjek, før du deler PDF-noter
AI kan sætte fart på processen, men dokumentnoter fortjener stadig at blive gennemgået. Før du deler et PDF-resumé med et team, skal du kontrollere de punkter, der kan ændre dokumentets betydning.
- Bekræft dokumentets titel, dato, forfatter, version og kilde.
- Gennemgå navne, produkttermer, akronymer, tal, frister og henvisninger.
- Kontrollér, om PDF'en er scannet, tekstbaseret, tabeltung eller billedtung.
- Spørg, om resuméet bevarer dokumentets struktur og begrænsninger.
- Kontrollér vigtige påstande mod kildehenvisninger, før du bruger dem i beslutninger.
- Adskil fakta fra fortolkning, anbefalinger og åbne spørgsmål.
- Eksportér de endelige noter til det arbejdsområde, hvor teamet allerede arbejder.
For mange teams er det sidste trin der, hvor dokumentarbejdet bryder sammen. Nogen læser PDF'en, opretter et privat resumé og sender en besked, der aldrig bliver til varig teamviden. HiNoter kan hjælpe med at lukke dette hul ved at eksportere strukturerede noter til teamsystemer som Notion og Google Docs, så resultatet kan være tilgængeligt dér, hvor folk planlægger, skriver og følger op.
Hvad kan du bruge en PDF-til-tekst-konverter til?
En PDF-til-tekst-konverter er nyttig, når indholdet er værdifuldt, men fanget i et statisk format. De bedste anvendelser handler ikke kun om konvertering; de handler om at reducere tiden fra modtagelsen af et dokument til effektiv brug af dets information.
Rapporter og ledelsesbriefinger
Ledelsesrapporter indeholder ofte flere detaljer, end travle læsere kan nå at absorbere før et møde. Ved at udtrække teksten kan du opbygge et kort resumé, identificere anbefalede beslutninger og forberede spørgsmål til diskussionen. HiNoter kan omdanne en lang PDF til en kort briefing, der fremhæver problemet, belægget, anbefalingen, risikoen og det næste skridt.
Kontrakter og politikdokumenter
Kontrakter og PDF-filer med politikker kræver omhyggelig læsning. AI bør ikke erstatte juridisk gennemgang, men kan hjælpe med at organisere den første gennemgang: forpligtelser, fornyelsesdatoer, undtagelser, åbne spørgsmål og vilkår, der kræver menneskelig opmærksomhed. Svar med kildehenvisninger er særligt nyttige her, fordi læseren kan verificere hvert vigtigt punkt i forhold til den oprindelige tekst.
Forskningsartikler og undervisningsnoter
Akademiske PDF-filer er bevidst tætte. Studerende og forskere kan bruge tekstudtræk sammen med AI-resuméer til at identificere definitioner, metoder, påstande, belæg og begrænsninger. I stedet for at kopiere afsnit ind i en separat noteapp kan brugeren omdanne artiklen til strukturerede studienoter og stille opfølgende spørgsmål.
Manualer og supportviden
Supportteams arbejder ofte med manualer, produktvejledninger, opsætningsinstruktioner og fejlfindings-PDF'er. En søgbar PDF-chatproces kan hjælpe medarbejdere med at finde det rigtige svar hurtigere, især når kildehenvisninger viser, hvor instruktionen stammer fra. Det endelige resultat kan genbruges i intern dokumentation eller udkast til kundesvar.
Møde forberedelse og opfølgning
Nogle PDF-filer er ikke det endelige resultat; de danner kontekst for et møde. En kunderapport, leverandørforslag, bestyrelsespakke, produktspecifikation eller projektreview kan omdannes til forberedelsesnoter før samtalen. Efter mødet kan HiNoter forbinde PDF-konteksten med den faktiske diskussion, resuméet, beslutningerne og handlingspunkterne.
Retningslinjer for privatliv og tilladelser
Før du uploader en PDF til en konverter eller et AI-værktøj, skal du bekræfte, at du har tilladelse til at behandle den. Dette er især vigtigt for fortrolige kontrakter, medarbejderoplysninger, sundhedsdokumenter, finansielle rapporter, kundedata, betalingsbelagt forskning, kursusmaterialer og ophavsretligt beskyttet indhold. Brug virksomhedsgodkendte arbejdsgange til følsomme dokumenter, og fjern oplysninger, der ikke behøver at blive behandlet.
En praktisk privatlivsvane er at klassificere filen før upload. Spørg, om den er offentlig, intern, fortrolig, reguleret eller leveret af en kunde. Beslut derefter, hvem der skal have adgang til den udtrukne tekst, resuméet, chatsvarene og eksportfilerne. Værktøjet bør reducere rutinearbejdet uden at skabe en ny ukontrolleret kopi af følsomme oplysninger.
For teams bør tilladelser være lige så gennemtænkte som selve noterne. Et PDF-resumé, der bruges til mødeforberedelse, kan høre hjemme i et delt projektarbejdsområde. En kontraktanalyse bør måske kun være tilgængelig for juridisk afdeling og kundeansvarlige. Et forskningsresumé kan være passende for et bredere team. Den rigtige arbejdsgang afhænger af indholdet, ikke kun af konverterens bekvemmelighed.
Hvornår en PDF-konverter bør blive til en AI-arbejdsgang for viden
Brug en simpel konverter, når du kun har brug for at kopiere tekst. Brug en AI-arbejdsgang for viden, når dokumentet vil påvirke en beslutning, et møde, et projekt, et kursus, en kunderelation eller en intern proces. I det øjeblik nogen spørger "hvad betyder dette?" eller "hvad bør vi gøre som det næste?", er rå tekstudtræk ikke nok.
HiNoter er udviklet til den anden kategori. Den kan tage dokumentets indhold, opsummere det, identificere centrale punkter, forberede mødenoter og understøtte kildehenvist AI Chat. Det samme arbejdsområde kan også håndtere mødeoptagelser, videoer, lyd og noter, så PDF-filen bliver en del af en større vidensregistrering i stedet for en engangskonvertering.
Hvis du har brug for mere end tekst, omdanner HiNoter PDF-indhold til udtrukket tekst samt resumé, centrale punkter, mødenoter, eksportfiler og søgbar Q&A. Upload en tilladt PDF, gennemgå det udtrukne indhold, og brug resultatet til at forberede, beslutte, undervise, briefe eller følge op med mindre manuelt arbejde.
Ofte stillede spørgsmål om arbejdsgange til konvertering fra PDF til tekst
Hvad er den bedste måde at konvertere en PDF til tekst på?
Den bedste metode afhænger af PDF-typen. Hvis PDF-filen indeholder tekst, der kan markeres, er direkte udtræk normalt hurtigst. Hvis den er scannet eller billedbaseret, skal du bruge OCR. Til forretnings- eller forskningsarbejde bør du bruge en arbejdsgang, der også opsummerer afsnit og bevarer kildehenvisninger til gennemgang.
Kan en PDF-til-tekst-konverter læse scannede dokumenter?
Ja, hvis den indeholder OCR. OCR kan læse tekst fra scannede sider og billeder, men kvaliteten afhænger af scannets tydelighed, skrifttypens læsbarhed, sidens vinkel, kontrasten, og om filen indeholder håndskrift, stempler eller komplekse layout.
Hvad er forskellen mellem PDF-udtræk og PDF-opsummering?
PDF-udtræk trækker ord ud af filen. PDF-opsummering forklarer hovedpunkterne i en kortere form. Udtræk hjælper dig med at få adgang til teksten; opsummering hjælper dig med at forstå indholdet hurtigere.
Hvad er kildeforankret PDF-chat?
Kildeforankret PDF-chat lader dig stille spørgsmål om en PDF og modtage svar, der kan føres tilbage til kildeindholdet. Det er nyttigt, når du har brug for at verificere, hvor et svar stammer fra, i stedet for at stole på et generisk AI-svar.
Kan HiNoter opsummere PDF-filer?
HiNoter kan hjælpe med at omdanne PDF-indhold til strukturerede resuméer, centrale punkter, noter og kildehenviste AI Chat-svar. Det er især nyttigt, når PDF-filer skal blive til mødeforberedelse, forskningsnoter, intern dokumentation eller teamviden.
Bør jeg gennemgå AI-genererede PDF-resuméer?
Ja. Gennemgå kritiske detaljer som tal, datoer, navne, juridiske vilkår, kildehenvisninger, forpligtelser og anbefalinger. AI-resuméer er nyttige for hastighedens skyld, men vigtige beslutninger bør fortsat være forbundet med kildedokumentet.