En PDF til tekst-konverterer trekker ut lesbar tekst fra en PDF slik at du kan kopiere, søke, oppsummere og gjenbruke den. For skannede PDF-er leser OCR tekst fra bilder. HiNoter går lenger ved å gjøre uttrukket PDF-innhold om til sammendrag, hovedpunkter, notater til møteforberedelser og kildekoblede svar fra AI Chat.
Hva er en PDF til tekst-konverterer?
En PDF til tekst-konverterer er programvare som tar innhold som er låst inne i en PDF og gjør det om til redigerbar, søkbar tekst. Oppgaven høres enkel ut helt til du møter de virkelige PDF-ene folk faktisk bruker: skannede kontrakter, eksporterte presentasjoner, akademiske artikler med fotnoter, håndbøker med kolonner, styrerapporter fulle av tabeller og bilderike dokumenter der ordene teknisk sett er en del av et bilde.
For en student kan målet være å hente ut hovedidéene fra en forskningsartikkel. For en produktsjef kan det være å gjøre en kunderapport om til møteforberedelser. For et juridisk-, support- eller driftsteam kan målet være å finne den nøyaktige setningen som svarer på et spørsmål uten å lese femti sider på nytt. Rå tekstuttrekking er nyttig, men det er bare det første steget. Den virkelige verdien oppstår når det uttrukne innholdet blir strukturert, oppsummert, kildebelagt og gjenbrukbart.
Det er her HiNoter passer naturlig inn. HiNoter er en plattform for AI-møtenotater og transkripsjon, men den er ikke begrenset til møter. Team kan bruke den til å behandle PDF-er, lyd, video og tillatt nettinnhold i ett arbeidsområde. En rapport kan bli til et sammendrag. En håndbok kan bli til søkbar spørsmål og svar. En PDF som brukes før et møte, kan bli til forberedelsesnotater, spørsmål, risikoer og oppfølgingsoppgaver.
Arbeidsflyt for PDF til tekst-konvertering: Fra statisk fil til nyttige notater
Den ryddigste arbeidsflyten er ikke bare «last opp en PDF og kopier teksten». En bedre PDF-arbeidsflyt skiller uttrekking fra forståelse. Først identifiserer verktøyet om dokumentet har valbar tekst eller krever OCR. Deretter trekker det ut innholdet, beholder nok struktur til å bevare meningen og lar deg oppsummere, stille spørsmål eller eksportere resultatet.
| Trinn | Hva skjer | Hvorfor det er viktig |
|---|---|---|
| 1. Last opp PDF-en | Legg til en rapport, artikkel, håndbok, kontrakt, presentasjon eller utdeling du har tillatelse til å behandle. | Kildefilen forblir koblet til de resulterende notatene og svarene. |
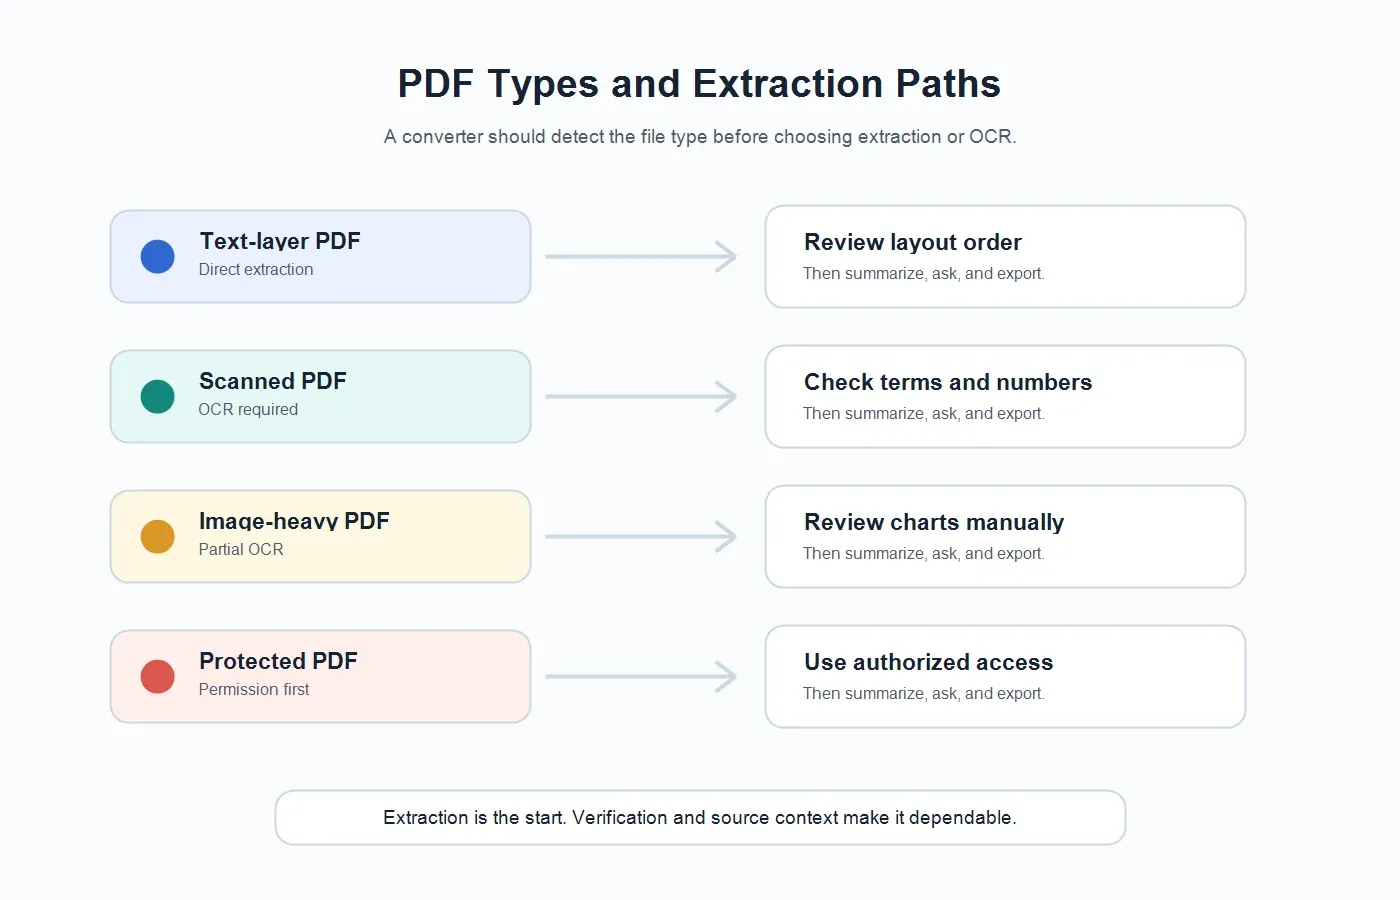
| 2. Finn PDF-typen | Systemet sjekker om PDF-en har et tekstlag eller trenger OCR. | Ulike PDF-typer krever ulike uttrekkingsmetoder. |
| 3. Trekk ut tekst | Valbar tekst hentes direkte, mens skannet tekst leses gjennom OCR. | Du får innhold som kan søkes i, kopieres, gjennomgås og oppsummeres. |
| 4. Rydd opp og strukturer | Seksjoner, overskrifter, tabeller, referanser og sidekontekst bevares der det er mulig. | En ryddig struktur reduserer feil i sammendrag og ødelagte notater. |
| 5. Oppsummer og spør | HiNoter lager sammendrag, hovedpunkter, notater til møteforberedelser og kildekoblede svar fra AI Chat. | PDF-en blir til brukbar kunnskap, ikke bare uttrukket tekst. |
Hvis du bygger en repeterbar teamprosess, kan du koble PDF-arbeidsflyten til det bredere notatsystemet ditt. Team som allerede bruker AI Chat til møtekunnskap, kan for eksempel bruke det samme kildekoblede spørsmålsmønsteret for PDF-innhold. En leder kan spørre hva som endret seg mellom to kunderapporter. En student kan spørre etter hovedargumentet i en artikkel. En supportleder kan spørre hvor en håndbok forklarer en konfigurasjonsregel.
OCR, PDF-er med tekstlag og skannede PDF-er forklart
Ikke alle PDF-er lagrer ord på samme måte. Noen PDF-er inneholder et ekte tekstlag, noe som betyr at du kan velge ord med markøren. Andre er skanninger eller bilder av sider, noe som betyr at dokumentet inneholder bilder som tilfeldigvis viser tekst. En PDF til tekst-konverterer må håndtere begge deler, ellers vil resultatet føles upålitelig.
Hva er OCR?
OCR står for optisk tegngjenkjenning. OCR leser tekst fra et bilde, en skanning eller et foto og konverterer de synlige tegnene til maskinlesbar tekst. Det er nyttig for skannede PDF-er, fotograferte sider, eldre skjemaer, papirkontrakter og bildebaserte presentasjonseksporter.
OCR-kvaliteten avhenger av kilden. Tydelige skanninger, rette sider, høy kontrast, lesbare skrifttyper og minimalt med håndskrift gir bedre resultater. Skjeve sider, bilder med lav oppløsning, stempler, skygger, komplekse tabeller og blandede språk kan skape feil. En god arbeidsflyt gjør gjennomgang enkelt i stedet for å late som om alle skannede dokumenter er perfekte.
Hva er en PDF med tekstlag?
En PDF med tekstlag inneholder allerede maskinlesbar tekst bak det visuelle oppsettet. Du kan vanligvis velge, kopiere og søke etter ordene i filen. PDF-er med tekstlag kommer ofte fra eksporteringer fra Google Docs, Microsoft Word, designverktøy, rapporteringsplattformer eller publiseringssystemer.
Disse filene er vanligvis enklere å konvertere enn skanninger, men de har fortsatt særtilfeller. Oppsett med flere kolonner kan bli trukket ut i feil leserekkefølge. Topptekster og bunntekster kan gjentas. Tabeller kan brytes opp i forvirrende fragmenter. Fotnoter, sitater og sidefelt kan havne på steder som gjør den uttrukne teksten vanskelig å lese. Derfor bør en nyttig PDF-arbeidsflyt inkludere opprydding, seksjonssammendrag og kildekontroll.
Skannede PDF-er kontra tekst-PDF-er: Hva du kan forvente
Før du vurderer en konverterer, bør du identifisere PDF-typen. Det samme verktøyet kan føles utmerket på en ryddig rapport med tekstlag og rotete på en fotografert kontrakt. Denne tabellen gir en praktisk oversikt over hva som vanligvis skjer.
| PDF-type | Hvordan tekst blir funnet | Vanlig begrensning | Beste HiNoter-arbeidsflyt |
|---|---|---|---|
| PDF med tekstlag | Konvertereren trekker ut innebygd, valbar tekst. | Kolonner, topptekster, bunntekster og tabeller kan vises i feil rekkefølge. | Trekk ut tekst, oppsummer per seksjon og still deretter kildekoblede spørsmål. |
| Skannet PDF | OCR leser ord fra sidebilder. | Nøyaktigheten avhenger av skannekvalitet, kontrast, skjevhet og skriftens tydelighet. | Kjør OCR, gjennomgå viktige termer og lag deretter notater og hovedpunkter. |
| Bilderik PDF | Tekst kan være innebygd i diagrammer, skjermbilder eller lysbilder. | Diagrammer og illustrasjoner kan kreve menneskelig gjennomgang for full forståelse. | Trekk ut synlig tekst, oppsummer fortellingen og marker bilderike seksjoner. |
| Passordbeskyttet PDF | Tilgang avhenger av tillatelser og filbegrensninger. | Noen filer kan ikke behandles før de låses opp av en autorisert bruker. | Bruk bare dokumenter du har lovlig tilgang til, og behandle deretter den tillatte filen. |
| Tabelltung PDF | Tekstuttrekkingen leser celler, etiketter og verdier der det er mulig. | Komplekse tabeller kan miste forholdet mellom rader og kolonner. | Trekk ut tekst, gjennomgå tallene og still målrettede spørsmål med kildekontekst. |
Hvorfor uttrukket tekst alene vanligvis ikke er nok
Mange PDF-verktøy stopper i det øyeblikket de produserer tekst. Det er nyttig hvis det eneste målet ditt er å kopiere et sitat eller indeksere en fil. Det er mindre nyttig når PDF-en består av tjue sider med forskning, en omfattende markedsrapport, et policydokument, en kontrakt eller en opplæringshåndbok. Du må fortsatt lese den uttrukne teksten, avgjøre hva som er viktig, finne påstandene det er verdt å sitere og gjøre dokumentet om til noe teamet ditt kan bruke.
For kunnskapsarbeidere er det dypere problemet ikke tilgang til ord. Det er signalet. Hvilke seksjoner er viktige? Hva er risikoene? Hvilke spørsmål bør vi ta med inn i møtet? Hvilke påstander må verifiseres? Hva har endret seg siden forrige versjon? Hvilke tiltak bør noen iverksette etter å ha lest dette?
HiNoter er nyttig her fordi den behandler PDF-tekst som kildemateriale for strukturert kunnskap. PDF-en kan bli til et sammendrag for ledelsen, en forskningsbrief, et sett med notater til møteforberedelser, et emnekart eller et søkbart spørsmål-og-svar-område. Hvis du allerede bruker HiNoter som en arbeidsflyt for AI-møtenotater, blir PDF-behandling en del av den samme kunnskapssløyfen i stedet for en separat dokumentoppgave.
PDF til tekst kontra PDF-sammendrag kontra PDF-chat
Disse resultatene løser ulike oppgaver. En rå transkripsjon av PDF-en er ikke det samme som et sammendrag, og et sammendrag er ikke det samme som et kildeforankret chatsvar. Team får bedre resultater når de velger resultatet som samsvarer med beslutningen de må ta.
| Resultat | Hva det gir deg | Beste bruksområde |
|---|---|---|
| Uthentet tekst | De lesbare ordene fra PDF-en, med opprydding der det er mulig. | Kopiere sitater, søke i dokumentet, arkivere tekst eller klargjøre en kildefil. |
| PDF-sammendrag | En kortere forklaring av hovedideene, funnene, risikoene eller anbefalingene. | Forstå en rapport raskt før et møte, en time eller en gjennomgang. |
| Viktige punkter | Punktvise hovedpoenger organisert etter emne, seksjon eller relevans for beslutninger. | Briefe en leder, forberede en teamoppdatering eller lage studienotater. |
| Notater til møteforberedelse | Spørsmål, agendapunkter, risikoer og beslutninger foreslått ut fra PDF-innholdet. | Gjøre en kunderapport, kontrakt eller forskningsartikkel om til en fokusert diskusjon. |
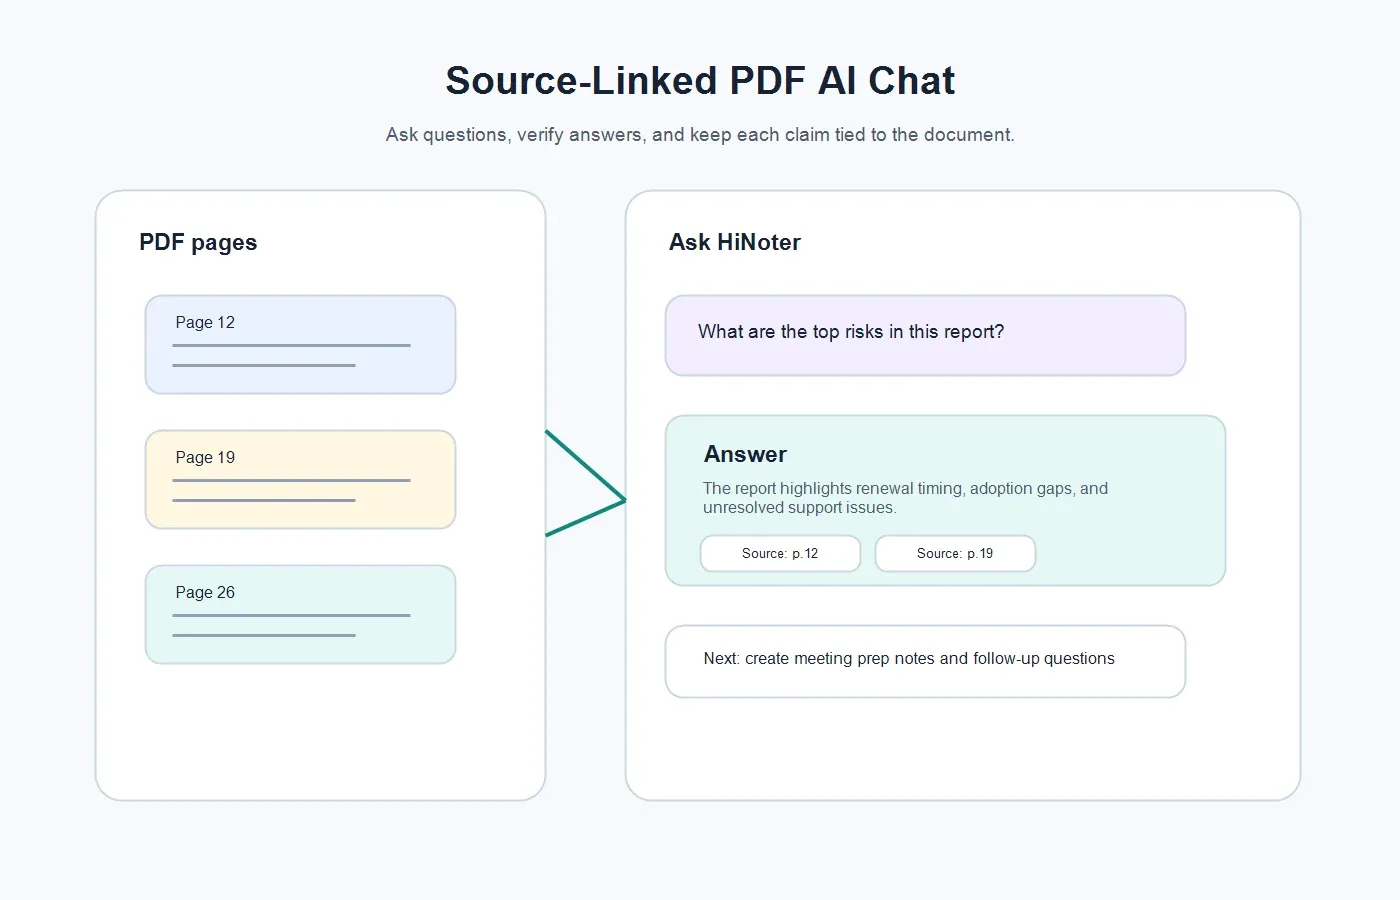
| AI-chat med kildehenvisninger | Svar basert på PDF-en, med henvisninger tilbake til kildeinnholdet. | Stille presise spørsmål uten å lese gjennom hele dokumentet på nytt. |
Hvis kilden er et innspilt webinar eller en opplæringsøkt i stedet for en PDF, kan HiNoter også støtte arbeidsflyter for video og lyd. For relaterte innholdstyper, se video til tekst og lyd til tekst. Det viktige er konsistens: Ett teamarbeidsområde kan håndtere møter, dokumenter, videoer og taleinnhold i stedet for å spre kunnskapen på separate verktøy.
Slik gjør HiNoter PDF-er om til teamkunnskap
HiNoter fungerer best når PDF-en er en del av en reell arbeidsflyt. En statisk fil blir nyttig når den hjelper noen med å forberede, beslutte, forklare eller følge opp noe. Her er den praktiske fremgangsmåten.
1. Last opp en PDF du har tillatelse til å behandle
Start med en PDF du eier, har opprettet, har mottatt i forbindelse med arbeid, eller på annen måte har tillatelse til å bruke. Dette er viktig for kontrakter, kursmateriell, betalte rapporter, kundedokumenter og opphavsrettsbeskyttet forskning. Et verktøy bør hjelpe deg med å forstå dokumenter du har lovlig tilgang til; det bør ikke brukes til å omgå tilgangsbegrensninger eller gjenbruke innhold uten tillatelse.
2. Hent ut tekst eller kjør OCR
HiNoter identifiserer det lesbare innholdet og klargjør det for gjennomgang. Hvis PDF-en har et tekstlag, kan uthentingen skje direkte. Hvis den er skannet, hjelper OCR med å hente ut synlig tekst. For kritiske dokumenter bør du kontrollere navn, datoer, tall, klausuler, sitater og alle deler der formatering kan påvirke tolkningen.
3. Generer et sammendrag av en seksjon
Et godt PDF-sammendrag bør ikke redusere dokumentet til generelle påstander. Det bør bevare kildens struktur: problem, dokumentasjon, anbefaling, risiko, begrensning og neste steg. For en rapport kan det bety å oppsummere den overordnede innledningen, funnene, metoden og anbefalingene separat. For en kontrakt kan det bety å skille mellom forpliktelser, frister, fornyelsesvilkår og åpne spørsmål.
4. Lag viktige punkter og møteforberedelser
Når innholdet er hentet ut, kan HiNoter gjøre det om til praktiske notater. Et produktteam kan be om kundenes viktigste utfordringer. Et salgsteam kan be om kjøpssignaler eller innvendinger. En student kan be om tese, dokumentasjon og definisjoner. En leder kan be om beslutningene som trengs i neste møte. Det er her PDF-en går fra lesestoff til brukbar teamkontekst.
5. Still spørsmål med kildehenvisninger
AI-chat med kildehenvisninger er forskjellen mellom et selvsikkert svar og et pålitelig svar. I stedet for å få et løst AI-svar kan brukeren stille et spørsmål og spore svaret tilbake til PDF-innholdet. Dette er spesielt viktig for forskning, etterlevelse, tekniske håndbøker, kundeforpliktelser og lederrapporter.
Eksempel: Gjøre en PDF-kunderapport om til møteforberedelser
Se for deg at en kundeansvarlig mottar en PDF med en kvartalsvis forretningsgjennomgang før en fornyelsessamtale. Dokumentet inneholder diagrammer over produktbruk, supporthistorikk, åpne risikoer, budsjettmerknader, kommentarer fra interessenter og mål for neste kvartal. Det er nyttig å hente ut teksten, men det forteller ikke den kundeansvarlige hvordan møtet skal gjennomføres.
Med HiNoter kan den samme PDF-en bli til en kortfattet forberedelsesbrief. Den kundeansvarlige kan spørre: Hva er de største fornyelsesrisikoene? Hvilke produktforespørsler går igjen? Hvilke forpliktelser påtok kunden seg? Hvilke spørsmål bør vi stille i samtalen? Hva bør sendes til kundeteamet før møtet?
De ferdige notatene kan inneholde et sammendrag på ett avsnitt, tre risikoer, fem spørsmål til kunden, en tidslinje over forpliktelser og en kort overlevering til det interne teamet. Etter møtet kan HiNoter knytte den direkte diskusjonen til PDF-konteksten, slik at rapporten ikke blir liggende i en mappe mens de faktiske beslutningene flyttes til private notater eller chat-tråder.
Eksempel: Oppsummere en forskningsartikkel uten å miste kilden
Studenter, analytikere og forskere trenger ofte mer enn et sammendrag på ett avsnitt. De trenger å vite forskningsspørsmålet, metoden, utvalget, hovedfunnet, begrensningene og påstandene som er verdt å sitere. En rå PDF-til-tekst-konverterer kan hente ut ordene, men den avgjør ikke automatisk hvilke deler som er viktige for en litteraturgjennomgang, briefing eller presentasjon.
En mer nyttig arbeidsflyt er å hente ut teksten, oppsummere hver hovedseksjon, liste de viktigste begrepene, identifisere den sterkeste dokumentasjonen og stille oppfølgingsspørsmål med henvisninger. For eksempel: Hva er artikkelens hovedpåstand? Hvilken dokumentasjon støtter den? Hvilke antakelser bør utfordres? Hvilket avsnitt definerer hovedbegrepet? Hvilken seksjon forklarer begrensningene?
Fordi HiNoter støtter svar med kildehenvisninger, kan brukeren holde sammendraget knyttet til det opprinnelige innholdet. Det gjør resultatet enklere å kontrollere og enklere å gjenbruke i klassenotater, forskningsnotater eller teamdokumenter.
Vanlige problemer ved uthenting fra PDF og hvordan de håndteres
PDF-er er laget for å bevare visuell layout, ikke alltid for å gjøre tekstopphenting enkelt. Når resultatene ser rotete ut, skyldes problemet ofte kildeformatet, ikke bare konverteren. Her er problemene det er verdt å kontrollere før du stoler på resultatet.
| Problem | Dette kan du se | Slik forbedrer du resultatet |
|---|---|---|
| Lav skannekvalitet | Manglende ord, feil tegn eller brutte linjer. | Bruk en tydeligere skanning, forbedre kontrasten og kontroller viktige begreper manuelt. |
| Oppsett med flere kolonner | Tekst fra én kolonne kan blandes med tekst fra en annen. | Oppsummer etter seksjon og kontroller leserekkefølgen før deling. |
| Komplekse tabeller | Rader og kolonner kan miste sammenhengene mellom seg. | Kontroller tall og etiketter, og still deretter spesifikke spørsmål om tabellen. |
| Sidehoder og sideføtter | Gjentatt sidetekst kan gjøre uthentingen rotete. | Fjern gjentatt innhold før du lager de endelige notatene. |
| Beskyttet fil | Konverteren får kanskje ikke tilgang til innholdet. | Bruk bare en autorisert versjon av dokumentet og respekter filbegrensningene. |
Kvalitetssjekkliste før du deler PDF-notater
AI kan gjøre prosessen raskere, men dokumentnotater bør fortsatt gjennomgås. Før du deler et PDF-sammendrag med et team, bør du kontrollere punktene som kan endre betydningen av dokumentet.
- Bekreft dokumentets tittel, dato, forfatter, versjon og kilde.
- Kontroller navn, produktbegreper, akronymer, tall, frister og sitater.
- Kontroller om PDF-en er skannet, tekstbasert, full av tabeller eller full av bilder.
- Spør om sammendraget bevarer dokumentets struktur og begrensninger.
- Kontroller viktige påstander mot kildehenvisningene før du bruker dem i beslutninger.
- Skill fakta fra tolkninger, anbefalinger og åpne spørsmål.
- Eksporter de endelige notatene til arbeidsområdet der teamet allerede jobber.
For mange team er det siste steget der dokumentarbeidet bryter sammen. Noen leser PDF-en, lager et privat sammendrag og sender en melding som aldri blir varig teamkunnskap. HiNoter kan bidra til å lukke dette gapet ved å eksportere strukturerte notater til teamsystemer som Notion og Google Docs, slik at resultatet kan ligge der folk planlegger, skriver og følger opp.
Hva kan du bruke en PDF-til-tekst-konverterer til?
En PDF-til-tekst-konverterer er nyttig når innholdet er verdifullt, men sitter fast i et statisk format. De beste bruksområdene handler ikke bare om konvertering; de handler om å redusere tiden fra du mottar et dokument til du bruker informasjonen på en god måte.
Rapporter og ledelsesbriefinger
Ledelsesrapporter inneholder ofte mer informasjon enn travle lesere rekker å ta inn før et møte. Ved å trekke ut teksten kan du lage et kortfattet sammendrag, identifisere anbefalte beslutninger og forberede spørsmål til diskusjonen. HiNoter kan gjøre en lang PDF om til en kort briefing som fremhever problemet, dokumentasjonen, anbefalingen, risikoen og neste steg.
Kontrakter og retningslinjedokumenter
Kontrakter og PDF-er med retningslinjer krever nøye gjennomlesing. AI bør ikke erstatte juridisk gjennomgang, men kan bidra til å organisere første gjennomgang: forpliktelser, fornyelsesdatoer, unntak, åpne spørsmål og vilkår som krever menneskelig oppmerksomhet. Svar med kildehenvisninger er spesielt nyttige her fordi leseren kan kontrollere hvert viktig punkt mot originalteksten.
Forskningsartikler og klassenotater
Akademiske PDF-er er med vilje innholdsrike. Studenter og forskere kan bruke tekstuttrekking og AI-sammendrag til å identifisere definisjoner, metoder, påstander, dokumentasjon og begrensninger. I stedet for å kopiere avsnitt til en separat notatapp kan brukeren gjøre artikkelen om til strukturerte studienotater og stille oppfølgingsspørsmål.
Manualer og supportkunnskap
Supportteam arbeider ofte med manualer, produktveiledninger, installasjonsinstruksjoner og PDF-er for feilsøking. En søkbar PDF-chattearbeidsflyt kan hjelpe medarbeidere med å finne riktig svar raskere, særlig når kildereferanser viser hvor instruksjonen kom fra. Det endelige resultatet kan gjenbrukes i intern dokumentasjon eller utkast til kundesvar.
Møteforberedelser og oppfølging
Noen PDF-er er ikke det endelige leveranseproduktet; de er bakgrunn for et møte. En kunderapport, leverandørforslag, styrepakke, produktspesifikasjon eller prosjektgjennomgang kan gjøres om til forberedelsesnotater før samtalen. Etter møtet kan HiNoter koble PDF-bakgrunnen med selve diskusjonen, sammendraget, beslutningene og oppfølgingspunktene.
Retningslinjer for personvern og tillatelser
Før du laster opp en PDF til en konverterer eller et AI-verktøy, må du bekrefte at du har tillatelse til å behandle den. Dette er spesielt viktig for konfidensielle kontrakter, personalopplysninger, helsedokumenter, økonomiske rapporter, kundedata, betalt forskning, kursmateriell og opphavsrettsbeskyttet innhold. Bruk arbeidsflyter som er godkjent av virksomheten for sensitive dokumenter, og fjern informasjon som ikke trenger å behandles.
En praktisk personvernvane er å klassifisere filen før opplasting. Spør om den er offentlig, intern, konfidensiell, regulert eller levert av en kunde. Bestem deretter hvem som skal ha tilgang til den uttrukne teksten, sammendraget, chatsvarene og eksportene. Verktøyet bør redusere rutinearbeidet uten å opprette en ny ukontrollert kopi av sensitiv informasjon.
For team bør tillatelser være like gjennomtenkte som selve notatene. Et PDF-sammendrag som brukes til møteforberedelser, kan høre hjemme i et delt prosjektområde. En kontraktanalyse bør kanskje bare være tilgjengelig for juridisk avdeling og kundeansvarlige. Et forskningssammendrag kan være egnet for et bredere team. Den riktige arbeidsflyten avhenger av innholdet, ikke bare av hvor praktisk konverteren er.
Når en PDF-konverterer bør bli til en AI-basert kunnskapsarbeidsflyt
Bruk en enkel konverterer når du bare trenger å kopiere tekst. Bruk en AI-basert kunnskapsarbeidsflyt når dokumentet skal påvirke en beslutning, et møte, et prosjekt, en undervisningssituasjon, et kundeforhold eller en intern prosess. I det øyeblikket noen spør «hva betyr dette?» eller «hva bør vi gjøre videre?», er rå tekstuttrekking ikke nok.
HiNoter er utviklet for den andre kategorien. Den kan ta innholdet i dokumentet, oppsummere det, identifisere nøkkelpunkter, lage møtenotater og støtte kildehenvist AI Chat. Det samme arbeidsområdet kan også håndtere møteopptak, videoer, lyd og notater, slik at PDF-en blir en del av en større kunnskapsbase i stedet for en engangskonvertering.
Hvis du trenger mer enn tekst, gjør HiNoter PDF-innhold om til uttrukket tekst med sammendrag, nøkkelpunkter, møtenotater, eksporter og søkbar Q&A. Last opp en tillatt PDF, gjennomgå det uttrukne innholdet, og bruk resultatet til å forberede, beslutte, undervise, informere eller følge opp med mindre manuelt arbeid.
Vanlige spørsmål om arbeidsflyter for konvertering fra PDF til tekst
Hva er den beste måten å konvertere en PDF til tekst på?
Den beste metoden avhenger av PDF-typen. Hvis PDF-en har tekst som kan merkes, er direkte uttrekking vanligvis raskest. Hvis den er skannet eller bildebasert, bør du bruke OCR. For forretnings- eller forskningsarbeid bør du bruke en arbeidsflyt som også oppsummerer deler og holder kildereferanser tilgjengelige for gjennomgang.
Kan en PDF-til-tekst-konverterer lese skannede dokumenter?
Ja, hvis den inkluderer OCR. OCR kan lese tekst fra skannede sider og bilder, men kvaliteten avhenger av skannens tydelighet, hvor lesbar skriften er, sidens vinkel, kontrasten og om filen inneholder håndskrift, stempler eller komplekse oppsett.
Hva er forskjellen mellom PDF-uttrekking og PDF-oppsummering?
PDF-uttrekking henter ord ut av filen. PDF-oppsummering forklarer hovedpunktene i kortere form. Uttrekking hjelper deg med å få tilgang til teksten; oppsummering hjelper deg med å forstå innholdet raskere.
Hva er kildebasert PDF-chat?
Kildebasert PDF-chat lar deg stille spørsmål om en PDF og få svar som er knyttet tilbake til kildeinnholdet. Dette er nyttig når du må bekrefte hvor et svar kommer fra, i stedet for å stole på et generisk AI-svar.
Kan HiNoter oppsummere PDF-filer?
HiNoter kan bidra til å gjøre PDF-innhold om til strukturerte sammendrag, nøkkelpunkter, notater og kildehenviste AI Chat-svar. Det er spesielt nyttig når PDF-er skal bli til møteforberedelser, forskningsnotater, intern dokumentasjon eller teamkunnskap.
Bør jeg gjennomgå AI-genererte PDF-sammendrag?
Ja. Gå gjennom kritiske detaljer som tall, datoer, navn, juridiske vilkår, sitater, forpliktelser og anbefalinger. AI-sammendrag er nyttige for å spare tid, men viktige beslutninger bør fortsatt være knyttet til kildedokumentet.