فایلهای PDF همهجا حضور دارند. کسبوکارها از آنها برای ایجاد قراردادها و گزارشها استفاده میکنند، دانشجویان برای ثبت یادداشتهای درسی به آنها متکی هستند و پژوهشگران اغلب مقالات علمی را در قالب PDF به اشتراک میگذارند. اگرچه PDFها برای حفظ قالببندی عالی هستند، ویرایش، جستوجو، تحلیل یا استفادهٔ مجدد از آنها میتواند بسیار دشوار باشد.
به همین دلیل، بسیاری از کاربران نیاز دارند PDFها را به متن تبدیل کنند.
با استخراج متن از PDFها، میتوانید محتوا را ویرایش کنید، اسناد را با هوش مصنوعی خلاصه کنید، اطلاعات را کارآمدتر جستوجو کنید و فایلهای ایستا را به دانش قابل استفاده تبدیل کنید. چه با PDFهای دیجیتال کار کنید و چه با اسناد اسکنشده، ابزارهای مدرن کل این فرایند را سادهتر از همیشه کردهاند.
در این راهنما، با فرایند تبدیل PDF به متن، زمان نیاز به OCR، بهترین ابزارها و نحوهٔ تغییر پردازش اسناد توسط هوش مصنوعی آشنا خواهید شد.
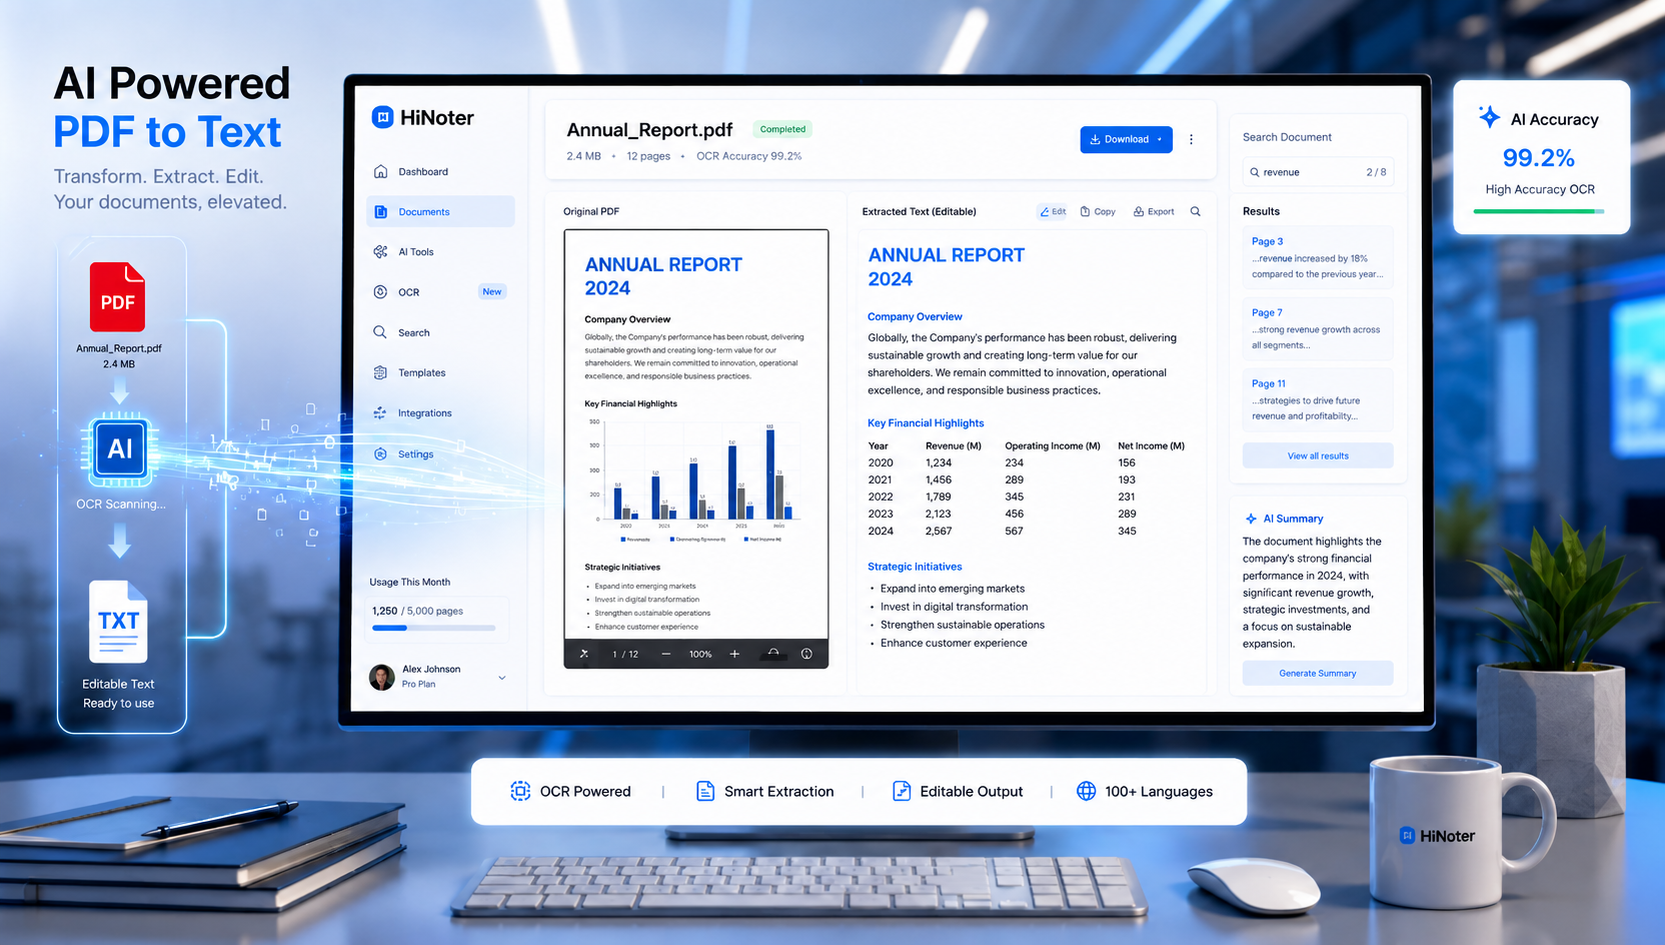
چرا مردم به مبدلهای PDF به متن نیاز دارند؟
PDF برای حفظ قالببندی اسناد در دستگاهها و سیستمعاملهای مختلف طراحی شده است. بااینحال، همین سازگاری میتواند استفادهٔ مجدد از محتوا را دشوار کند.
وقتی یک PDF را به متن تبدیل میکنید، چندین مزیت را به دست خواهید آورد:
مزایای اصلی
| مزیت | اهمیت آن |
|---|---|
| ویرایش آسانتر | تغییر محتوا بدون ایجاد دوبارهٔ اسناد |
| جستوجوی سریعتر | یافتن فوری اطلاعات |
| تحلیل با هوش مصنوعی | تولید خلاصهها و بینشها |
| استفادهٔ مجدد از محتوا | تبدیل گزارشها به مقاله یا یادداشت |
| دسترسپذیری بهتر | بهبود سازگاری با ابزارهای کمکی |
| استخراج داده | وارد کردن اطلاعات به سیستمهای دیگر |
برای دانشجویان، متخصصان و پژوهشگران، تبدیل PDFها به متن قابل ویرایش میتواند ساعتها کار دستی را کاهش دهد.
آشنایی با انواع مختلف PDF
پیش از انتخاب روش تبدیل، مهم است دو دستهٔ اصلی فایلهای PDF را بشناسید.
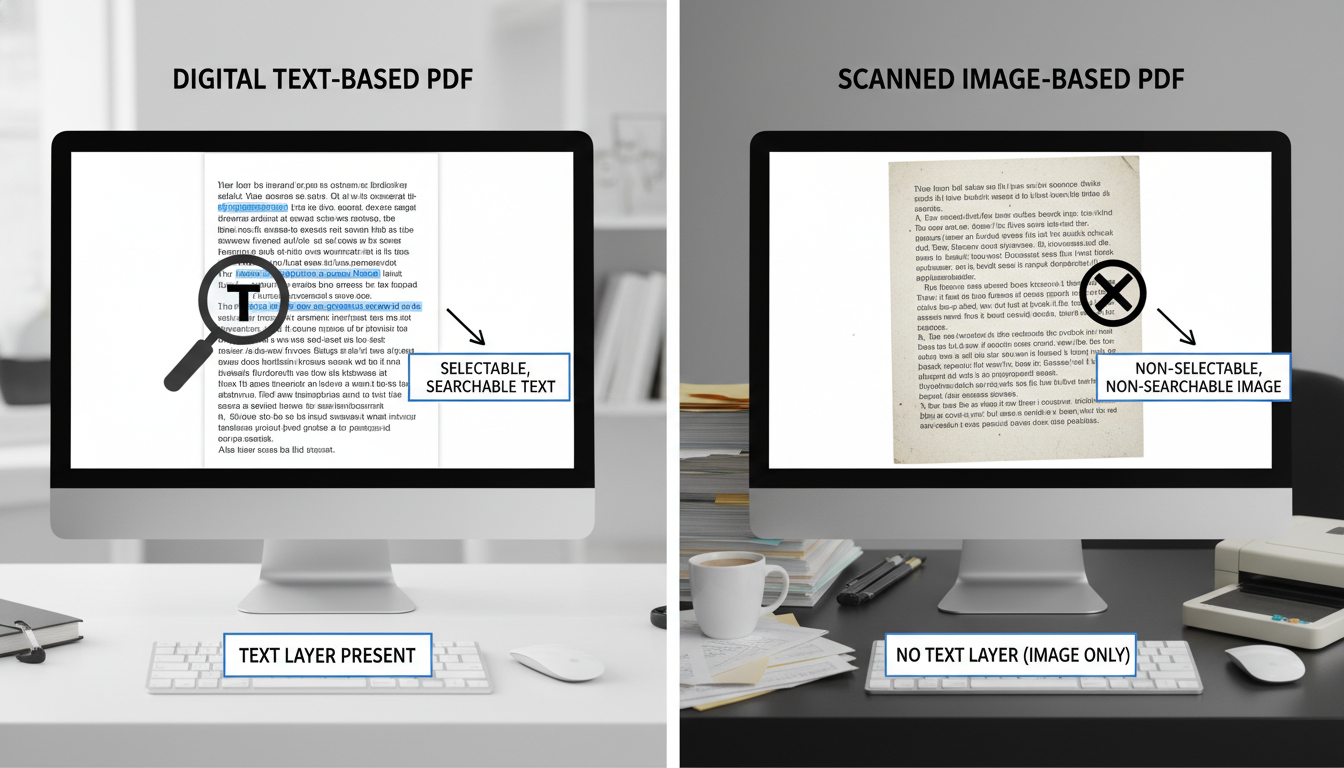
PDFهای مبتنی بر متن
این فایلها از قبل حاوی متنی هستند که ماشین میتواند آن را بخواند.
نمونهها شامل موارد زیر هستند:
- اسناد Word صادرشده بهصورت PDF
- گزارشهای دیجیتال
- کتابهای الکترونیکی
- راهنماهای آنلاین
- ارائههای کسبوکار
استخراج متن از این فایلها معمولاً سریع و بسیار دقیق است.
PDFهای اسکنشده
PDFهای اسکنشده اساساً فایلهای تصویری هستند که درون یک محفظهٔ PDF ذخیره شدهاند.
نمونهها شامل موارد زیر هستند:
- قراردادهای اسکنشده
- کتابهای چاپی
- بایگانیهای تاریخی
- اسناد دستنویس
- فرمهای کاغذی
ازآنجاکه متن واقعی در فایل جاسازی نشده است، نرمافزار باید ابتدا نویسهها را از تصویر تشخیص دهد و سپس آنها را استخراج کند.
این فرایند به فناوری OCR متکی است.
OCR در هوش مصنوعی چیست؟
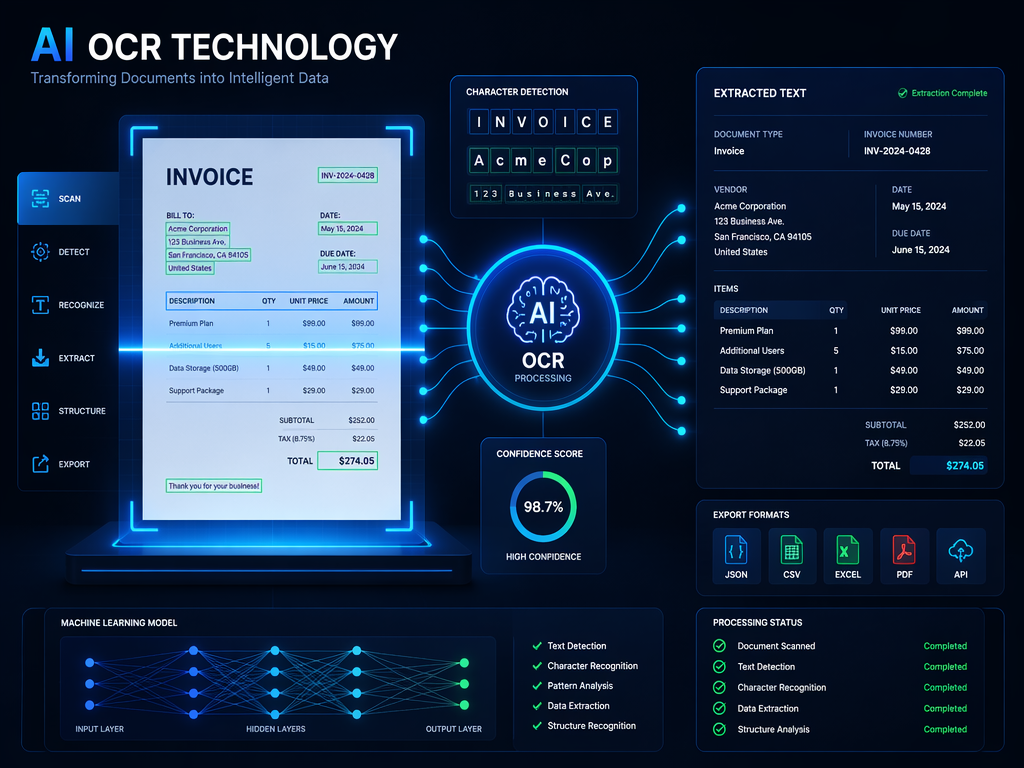
OCR مخفف تشخیص نوری نویسه است.
فناوری OCR حروف، اعداد و نمادهای موجود در تصاویر را شناسایی و آنها را به متن قابل ویرایش تبدیل میکند.
OCR سنتی دهههاست وجود دارد، اما سیستمهای OCR مدرن مبتنی بر هوش مصنوعی بسیار پیشرفتهتر هستند.
OCR هوش مصنوعی میتواند:
- چندین زبان را تشخیص دهد
- ساختار سند را شناسایی کند
- جدولها را استخراج کند
- عنوانها را شناسایی کند
- محتوای دستنویس را پردازش کند
- اشتباهات شناسایی را بهصورت خودکار اصلاح کند
مدلهای هوش مصنوعی بهجای تشخیص صرفِ نویسهها، زمینهٔ اسناد را درک میکنند.
به همین دلیل، بسیاری از کاربران اکنون راهکارهایی را ترجیح میدهند که از گردشکارهای تبدیل PDF به متن با هوش مصنوعی پشتیبانی میکنند، نه اینکه فقط به نرمافزارهای OCR سنتی متکی باشند.
OCR سنتی در برابر OCR هوش مصنوعی
| ویژگی | OCR سنتی | OCR هوش مصنوعی |
|---|---|---|
| تشخیص نویسه | خوب | عالی |
| پشتیبانی از دستخط | محدود | پیشرفته |
| حفظ چیدمان | پایه | قوی |
| استخراج جدول | ضعیف | دقیق |
| اصلاح خطا | دستی | با کمک هوش مصنوعی |
| پشتیبانی از چند زبان | متوسط | عالی |
چگونه PDF اسکنشده را با OCR به متن تبدیل کنیم
اسناد اسکنشده پیش از استخراج متن به OCR نیاز دارند.
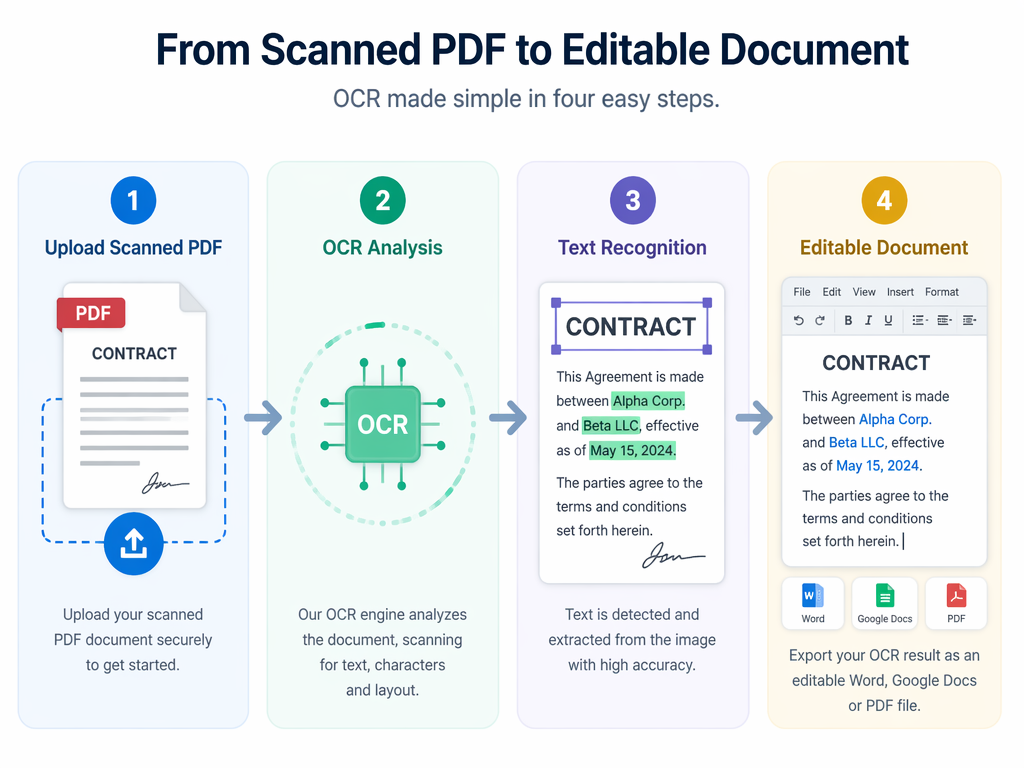
مراحل زیر را دنبال کنید:
مرحلهٔ ۱: بارگذاری PDF
ابزاری مجهز به OCR مانند موارد زیر انتخاب کنید:
- Adobe Acrobat
- OCR گوگل درایو
- Microsoft OneDrive
- HiNoter
- ABBYY FineReader
مرحلهٔ ۲: اجرای پردازش OCR
نرمافزار هر صفحه را اسکن و عناصر متنی را شناسایی میکند.
موتورهای OCR معمولاً:
- نویسهها را تشخیص میدهند
- جملهها را بازسازی میکنند
- قالببندی را حفظ میکنند
- ساختار سند را شناسایی میکنند
مرحلهٔ ۳: بررسی نتایج
موارد زیر را بررسی کنید:
- نامها
- تاریخها
- اعداد
- جدولها
- قالببندی ویژه
حتی سیستمهای پیشرفتهٔ OCR نیز گاهی ممکن است اشتباه کنند.
مرحلهٔ ۴: خروجی گرفتن از متن
قالبهای رایج خروجی شامل موارد زیر هستند:
- TXT
- DOCX
- Markdown
- HTML
در این مرحله، گردشکار تبدیل فایل pdf به متن شما کامل شده است.
چگونه یک PDF را بهصورت رایگان به متن تبدیل کنم؟
بسیاری از کاربران فقط به تبدیلهای گاهبهگاه نیاز دارند و ترجیح میدهند برای نرمافزار تخصصی هزینه نکنند.
خوشبختانه، چندین راهکار رایگان وجود دارد.
روشهای رایگان محبوب
| ابزار | نسخهٔ رایگان | پشتیبانی از OCR |
|---|---|---|
| Google Docs | بله | پایه |
| Adobe Online Tools | محدود | بله |
| Microsoft OneDrive | بله | پایه |
| Tesseract OCR | بله | پیشرفته |
| HiNoter | فریمیوم | OCR هوش مصنوعی |
بسیاری از کاربران کار خود را با ابزار تبدیل آنلاین pdf به متن آغاز میکنند، زیرا نیازی به نصب ندارد و مستقیماً در مرورگر کار میکند.
مزایای راهکارهای رایگان
- بدون نیاز به نصب نرمافزار
- راهاندازی سریع
- قابل دسترسی از هر دستگاه
- مناسب برای کارهای ساده
محدودیتها
- محدودیت اندازهٔ فایل
- دقت کمتر OCR
- محدودیتهای خروجی
- ویژگیهای هوش مصنوعی کمتر
برای گردشکارهای مربوط به اسناد بزرگ، ابزارهای اختصاصی مبتنی بر هوش مصنوعی اغلب نتایج بسیار بهتری ارائه میدهند.
چگونه یک PDF را به متن تبدیل کنم؟
این فرایند به این بستگی دارد که PDF شما مبتنی بر متن باشد یا اسکنشده.
روش ۱: کپی کردن متن موجود
برای PDFهای مبتنی بر متن:
- فایل را باز کنید
- محتوا را انتخاب کنید
- متن را کپی کنید
- آن را در یک ویرایشگر سند جایگذاری کنید
روش ۲: تبدیل با OCR
برای اسناد اسکنشده:
- PDF را بارگذاری کنید
- OCR را فعال کنید
- متن را استخراج کنید
- نتایج را بررسی کنید
- خروجی بگیرید
روش ۳: تبدیل مبتنی بر هوش مصنوعی
ابزارهای مدرن هوش مصنوعی میتوانند:
- متن را استخراج کنند
- بخشها را سازماندهی کنند
- خلاصه ایجاد کنند
- بینشهای کلیدی را شناسایی کنند
- یادداشتهای قابل جستوجو ایجاد کنند
این رویکرد در میان متخصصانی که حجم زیادی از اسناد را مدیریت میکنند، روزبهروز محبوبتر میشود.
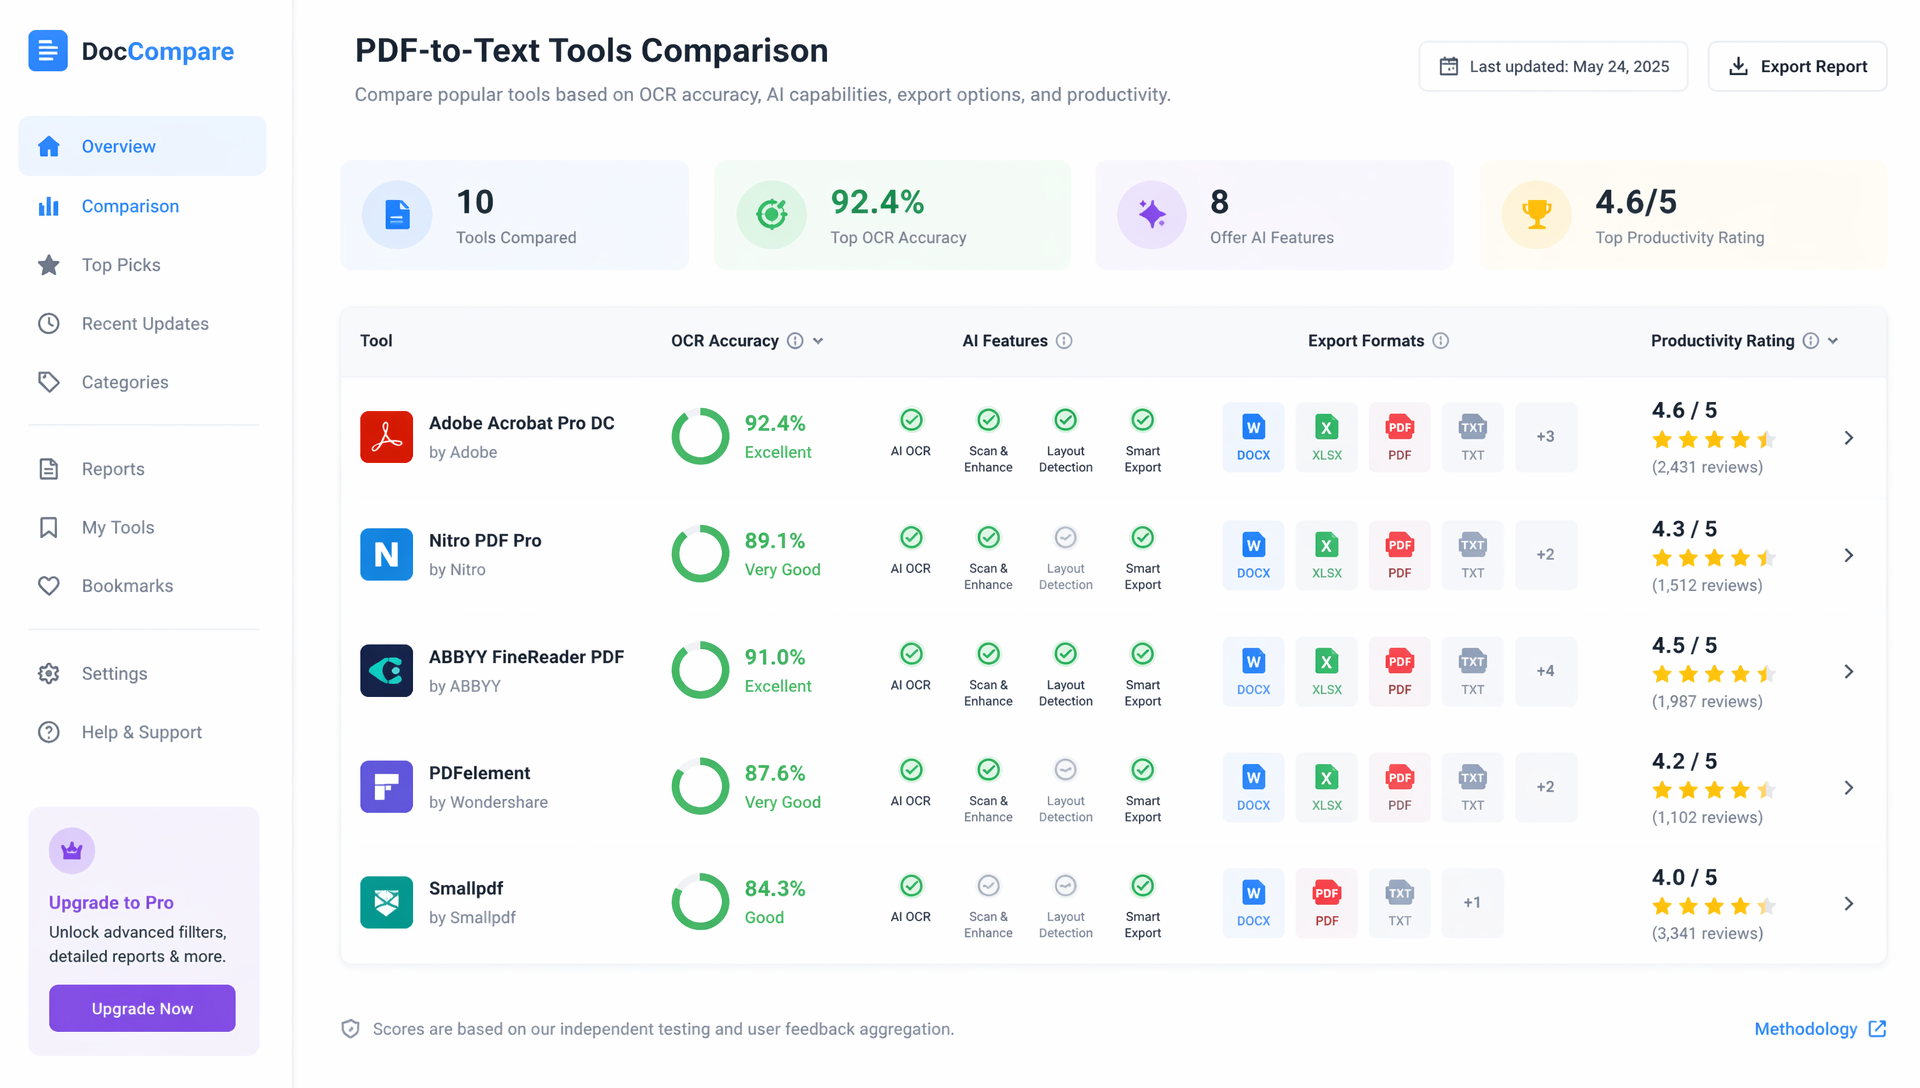
بهترین ابزارهای تبدیل PDF به متن
بازار طیف گستردهای از راهکارهای تبدیل PDF را ارائه میدهد.
جدول مقایسه
| ابزار | کیفیت OCR | قابلیتهای هوش مصنوعی | طرح رایگان | مناسب برای |
|---|---|---|---|---|
| HiNoter | عالی | عالی | بله | بهرهوری مبتنی بر هوش مصنوعی |
| Adobe Acrobat | عالی | خوب | محدود | اسناد حرفهای |
| Google Docs | پایه | خیر | بله | کاربران عادی |
| ABBYY FineReader | عالی | متوسط | خیر | OCR سازمانی |
| Microsoft OneDrive | پایه | خیر | بله | اکوسیستم مایکروسافت |
به چه مواردی توجه کنیم
هنگام انتخاب یک مبدل، موارد زیر را در نظر بگیرید:
- دقت OCR
- زبانهای پشتیبانیشده
- گزینههای خروجی
- قابلیتهای هوش مصنوعی
- حفاظت از حریم خصوصی
- سرعت پردازش
هر کاربری به OCR در سطح سازمانی نیاز ندارد، اما هنگام کار با قراردادها، مقالات پژوهشی یا اسناد تجاری، دقت اهمیت فزایندهای پیدا میکند.
هوش مصنوعی چگونه پردازش اسناد را متحول میکند
مبدلهای سنتی بر استخراج تمرکز دارند.
پلتفرمهای مدرن هوش مصنوعی بر درک تمرکز دارند.
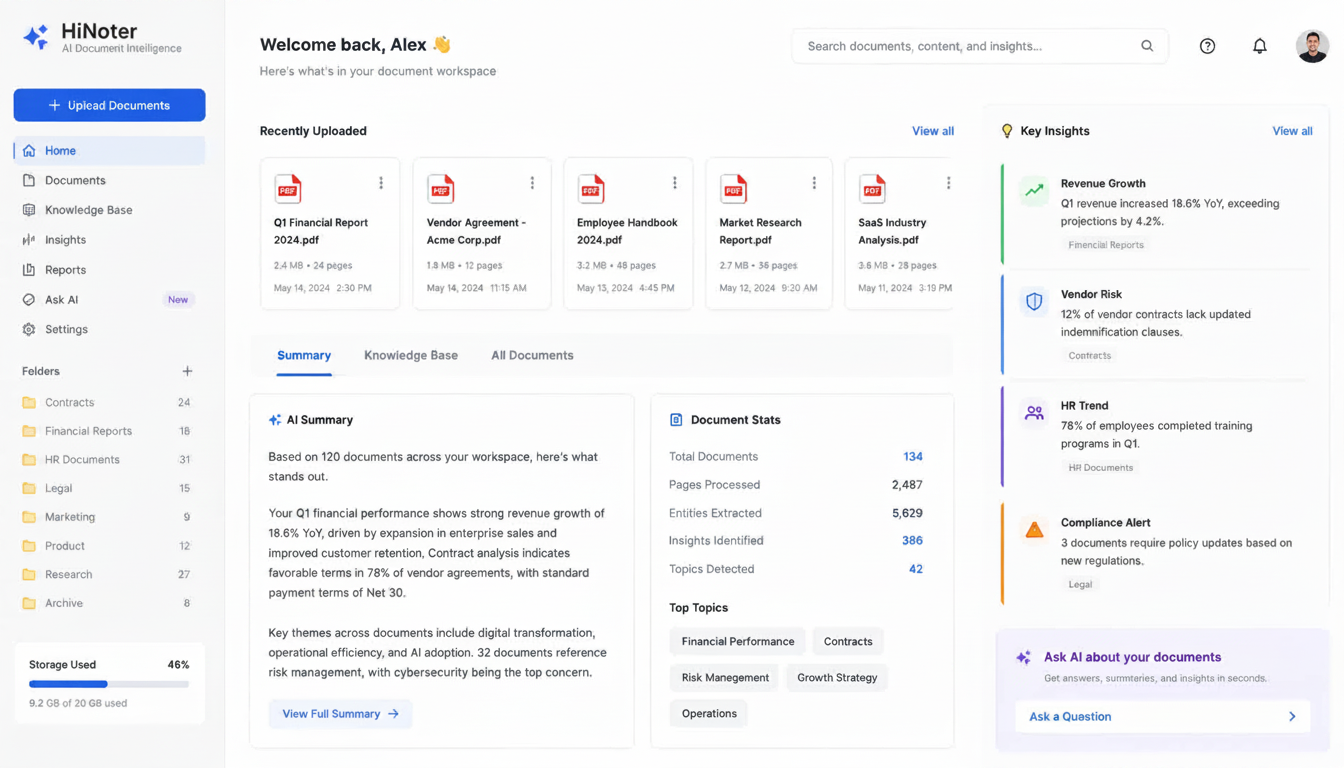
سیستمهای هوش مصنوعی بهجای اینکه صرفاً به کاربران در تبدیل PDF به متن کمک کنند، میتوانند محتوای سند را تحلیل کرده و بینشهای عملی ارائه دهند.
قابلیتهای هوش مصنوعی فراتر از OCR
- خلاصهسازی
- استخراج نکات کلیدی
- پاسخگویی به پرسشها
- جستوجوی معنایی
- تولید یادداشت
- سازماندهی دانش
این تحول نحوه پردازش اطلاعات توسط کسبوکارها را تغییر داده است.
نمونه گردش کار هوش مصنوعی
| مرحله | عملکرد هوش مصنوعی |
|---|---|
| بارگذاری PDF | تحلیل ساختار سند |
| OCR | استخراج متن |
| درک | شناسایی موضوعات و بخشها |
| خلاصهسازی | ایجاد مرورهای اجمالی مختصر |
| جستوجو | فعالسازی بازیابی فوری |
به همین دلیل علاقه به راهکارهای هوش مصنوعی تبدیل PDF به متن در بخشهای آموزش، پژوهش و کسبوکار همچنان در حال افزایش است.
چالشهای رایج تبدیل PDF
حتی بهترین ابزارها نیز با چالشهایی مواجه میشوند.
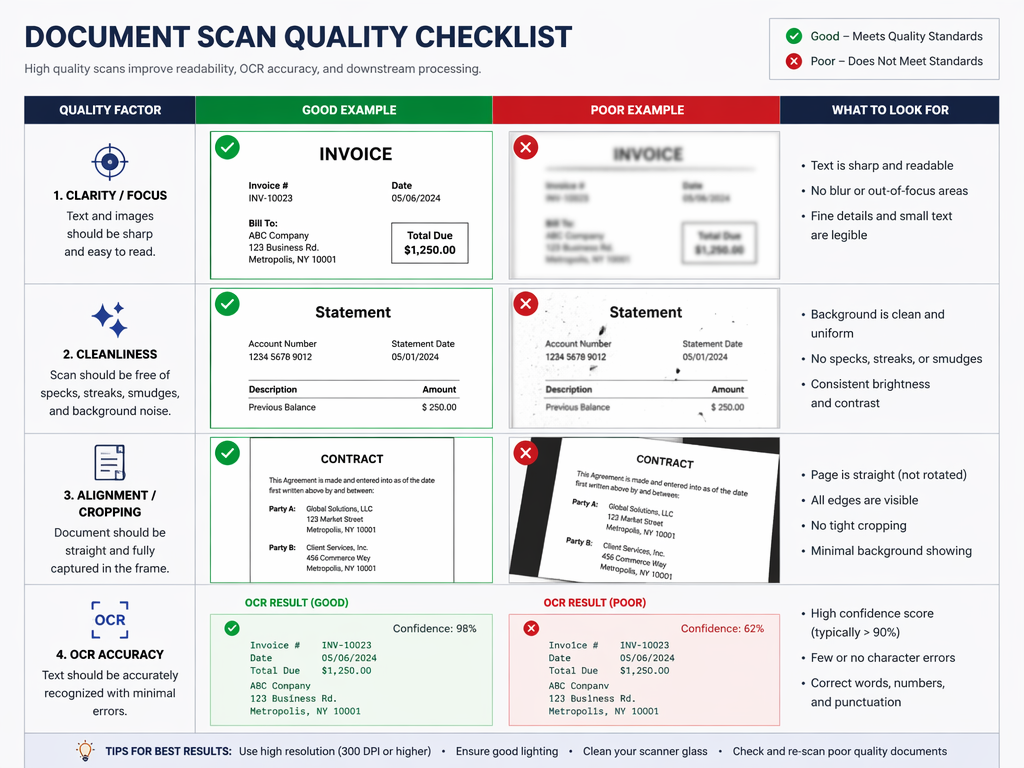
کیفیت پایین اسکن
اسکنهای با وضوح پایین، دقت OCR را کاهش میدهند.
چیدمانهای پیچیده
اسنادی که شامل موارد زیر هستند:
- جدولها
- چیدمانهای چندستونه
- نمودارها
- رسانههای ترکیبی
ممکن است پردازش دشوارتری داشته باشند.
محتوای دستنویس
تشخیص دستخط همچنان در حال پیشرفت است، اما هنوز از متن تایپشده دشوارتر است.
چندین زبان
برخی موتورهای OCR در پردازش اسناد چندزبانه با مشکل مواجه میشوند.
انتخاب یک پلتفرم OCR باکیفیت، نتایج را بهطور چشمگیری بهبود میدهد.
آیا میتوان متن را دوباره به PDF تبدیل کرد؟
جالب است که بسیاری از کاربرانی که اطلاعات را استخراج میکنند، بعداً نیاز دارند اسناد PDF را دوباره ایجاد کنند.
اینجاست که ابزارهای تبدیل آنلاین و رایگان متن به PDF مفید واقع میشوند.
بیشتر ویرایشگرهای اسناد به کاربران اجازه میدهند:
- اسناد متنی ایجاد یا ویرایش کنند
- محتوا را قالببندی کنند
- مستقیماً بهصورت PDF خروجی بگیرند
گزینههای محبوب عبارتاند از:
- Google Docs
- Microsoft Word
- Canva
- Adobe Acrobat
- تولیدکنندههای آنلاین PDF
این امر جابهجایی میان قالبهای متن قابل ویرایش و PDF را، بسته به نیازهای گردش کار شما، آسان میکند.
بهترین روشها برای دستیابی به نتایج دقیق
برای بهبود کیفیت تبدیل PDF:
پیش از بارگذاری
- از اسکنهای با وضوح بالا استفاده کنید
- مطمئن شوید صفحات بهدرستی تراز شدهاند
- از سایه یا تابش خیرهکننده جلوگیری کنید
- در نور مناسب اسکن کنید
پس از استخراج
- نامها و تاریخها را بررسی کنید
- مقادیر عددی را کنترل کنید
- جدولها را با دقت بررسی کنید
- با فایلهای اصلی مقایسه کنید
مراحل کوچک راستیآزمایی میتوانند دقت را بهطور چشمگیری بهبود دهند.
سؤالات متداول
چگونه میتوانم یک PDF را بهصورت رایگان به متن تبدیل کنم؟
میتوانید از Google Docs، OCR مایکروسافت واندرایو، ابزارهای آنلاین Adobe یا پلتفرمهای فریمیوم هوش مصنوعی استفاده کنید. این گزینهها به کاربران اجازه میدهند بدون خرید نرمافزار، متن را استخراج کنند.
OCR در هوش مصنوعی چیست؟
OCR (تشخیص نوری نویسهها) فناوریای است که متن موجود در تصاویر را به محتوای قابل ویرایش تبدیل میکند. OCR مبتنی بر هوش مصنوعی با درک ساختار و زمینه سند، دقت را بهبود میدهد.
چگونه PDF اسکنشده را با OCR به متن تبدیل کنیم
فایل اسکنشده را در یک ابزار مجهز به OCR بارگذاری کنید، سند را پردازش کنید، محتوای استخراجشده را بررسی کنید و متن را در قالب دلخواه خود خروجی بگیرید.
بهترین مبدل PDF به متن کدام است؟
بهترین راهکار به نیازهای شما بستگی دارد. برای کارهای پایه، ابزارهای رایگان OCR ممکن است کافی باشند. برای درک پیشرفته اسناد، پلتفرمهای مبتنی بر هوش مصنوعی مانند HiNoter ، OCR، خلاصهها و مدیریت دانش قابل جستوجو را در یک گردش کار ارائه میدهند.
چگونه یک PDF را به متن تبدیل کنم؟
برای PDFهای مبتنی بر متن، کافی است محتوا را مستقیماً کپی کنید. برای PDFهای اسکنشده، از نرمافزار OCR یا ابزارهای پردازش اسناد مبتنی بر هوش مصنوعی برای استخراج متن قابل ویرایش استفاده کنید.
سخن پایانی
PDFها همچنان یکی از مهمترین قالبهای اسناد در گردش کارهای مدرن هستند، اما اطلاعات ارزشمند اغلب درون فایلهای ایستا گرفتار میشوند.
توانایی تبدیل PDF به متن ویرایش، تحلیل، جستوجو و سازماندهی اسناد را آسانتر میکند. چه در حال پردازش قراردادها، مقالات دانشگاهی، گزارشهای تجاری یا آرشیوهای اسکنشده باشید، انتخاب روش تبدیل مناسب میتواند زمان و تلاش قابلتوجهی ذخیره کند.
با ادامه پیشرفت هوش مصنوعی در OCR و درک اسناد، آینده پردازش PDF از استخراج ساده فراتر رفته و به سوی مدیریت هوشمند دانش در حال حرکت است. ابزارهای مدرن اکنون میتوانند PDFها را به اطلاعات قابل جستوجو و قابل استفاده تبدیل کنند—و به کاربران کمک کنند سریعتر کار کنند و از هر سند ارزش بیشتری به دست آورند.