A PDF-fájlok mindenütt jelen vannak. A vállalkozások szerződések és jelentések létrehozására használják őket, a diákok az előadási jegyzetek rögzítésére támaszkodnak rájuk, a kutatók pedig gyakran PDF-formátumban osztják meg tudományos dolgozataikat. Bár a PDF-ek kiválóan alkalmasak a formázás megőrzésére, szerkesztésük, keresés bennük, elemzésük vagy újrafelhasználásuk meglehetősen nehéz lehet.
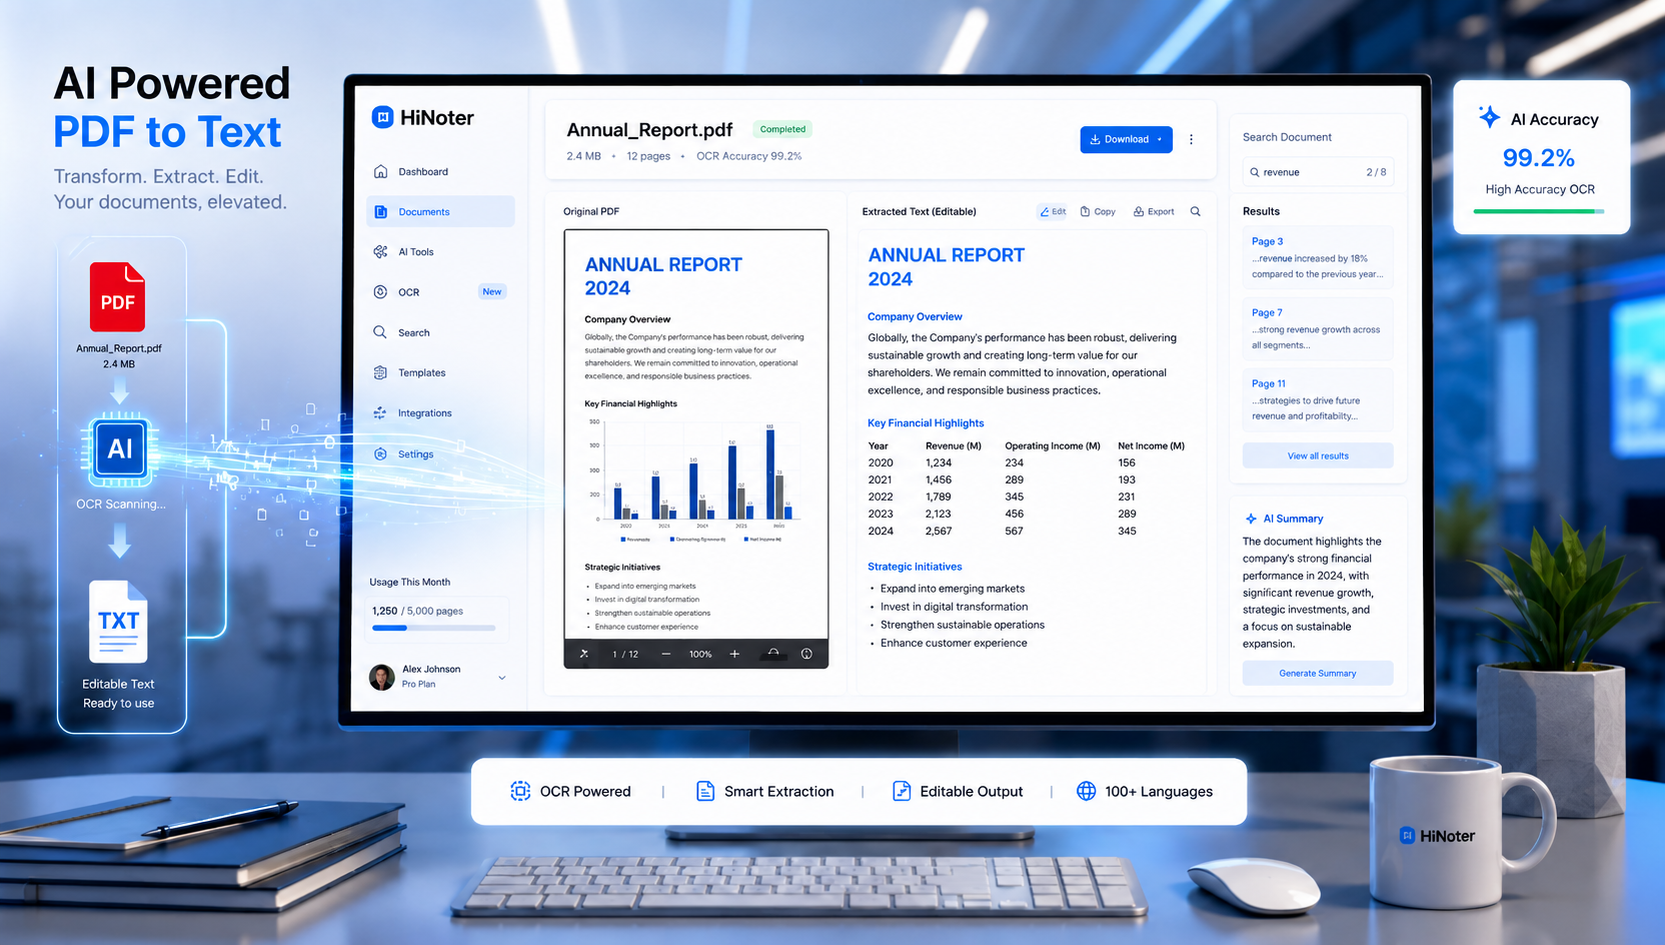
Ezért van szükségük sok felhasználónak a PDF-ek szöveggé alakítására.
A PDF-ekből történő szövegkinyeréssel szerkesztheti a tartalmat, mesterséges intelligenciával összefoglalhatja a dokumentumokat, hatékonyabban kereshet információkat, és a statikus fájlokat hasznosítható tudássá alakíthatja. Akár digitális PDF-ekkel, akár szkennelt dokumentumokkal dolgozik, a modern eszközök minden eddiginél egyszerűbbé teszik az egész folyamatot.
Ebben az útmutatóban megismerheti a PDF-szövegkonvertálás folyamatát, azt, mikor van szükség OCR-re, a legjobb eszközöket, valamint azt, hogyan változtatja meg a mesterséges intelligencia a dokumentumfeldolgozást.
Miért van szükség PDF-szövegkonvertálókra?
A PDF-et úgy tervezték, hogy a dokumentum formázását különböző eszközökön és operációs rendszereken is megőrizze. Ez az egységesség azonban megnehezítheti a tartalom újrafelhasználását.
Amikor egy PDF-et szöveggé alakít, számos előnyhöz jut:
Fő előnyök
| Előny | Miért fontos? |
|---|---|
| Egyszerűbb szerkesztés | A tartalom módosítása a dokumentumok újbóli létrehozása nélkül |
| Gyorsabb keresés | Az információk azonnali megtalálása |
| MI-alapú elemzés | Összefoglalók és betekintések készítése |
| A tartalom újrafelhasználása | Jelentések cikkekké vagy jegyzetekké alakítása |
| Jobb hozzáférhetőség | A segítőeszközökkel való kompatibilitás javítása |
| Adatkinyerés | Információk importálása más rendszerekbe |
Diákok, szakemberek és kutatók számára a PDF-ek szerkeszthető szöveggé alakítása órákig tartó kézi munkát takaríthat meg.
A PDF-ek különböző típusainak megértése
A konvertálási módszer kiválasztása előtt fontos megérteni a PDF-fájlok két fő kategóriáját.
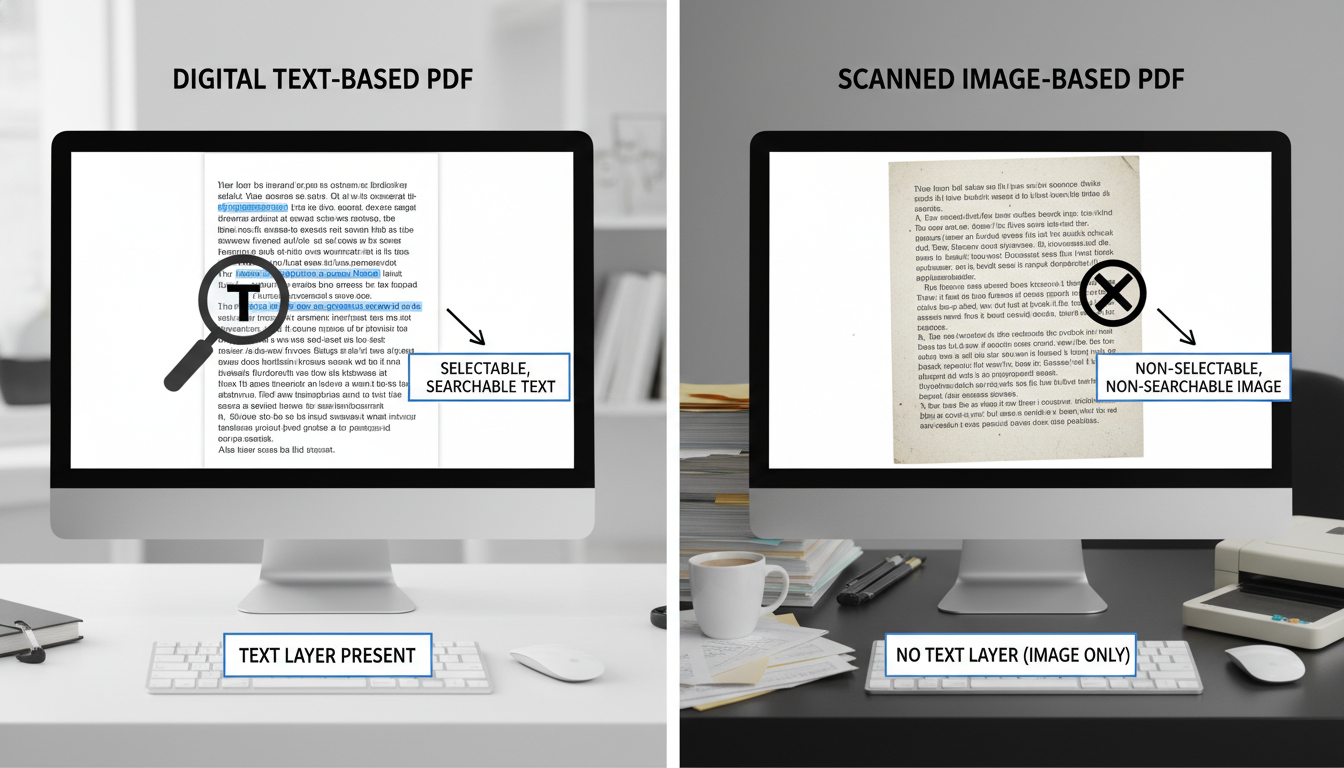
Szövegalapú PDF-ek
Ezek a fájlok már géppel olvasható szöveget tartalmaznak.
Példák:
- PDF-ként exportált Word-dokumentumok
- Digitális jelentések
- E-könyvek
- Online kézikönyvek
- Üzleti prezentációk
A szöveg kinyerése ezekből a fájlokból általában gyors és rendkívül pontos.
Szkennelt PDF-ek
A szkennelt PDF-ek lényegében egy PDF-tárolóban tárolt képfájlok.
Példák:
- Szkennelt szerződések
- Nyomtatott könyvek
- Történelmi archívumok
- Kézzel írt dokumentumok
- Űrlapok
Mivel a fájl nem tartalmaz ténylegesen beágyazott szöveget, a szoftvernek először fel kell ismernie a képen található karaktereket, mielőtt kinyerhetné őket.
Ez a folyamat OCR-technológiára támaszkodik.
Mi az OCR a mesterséges intelligenciában?
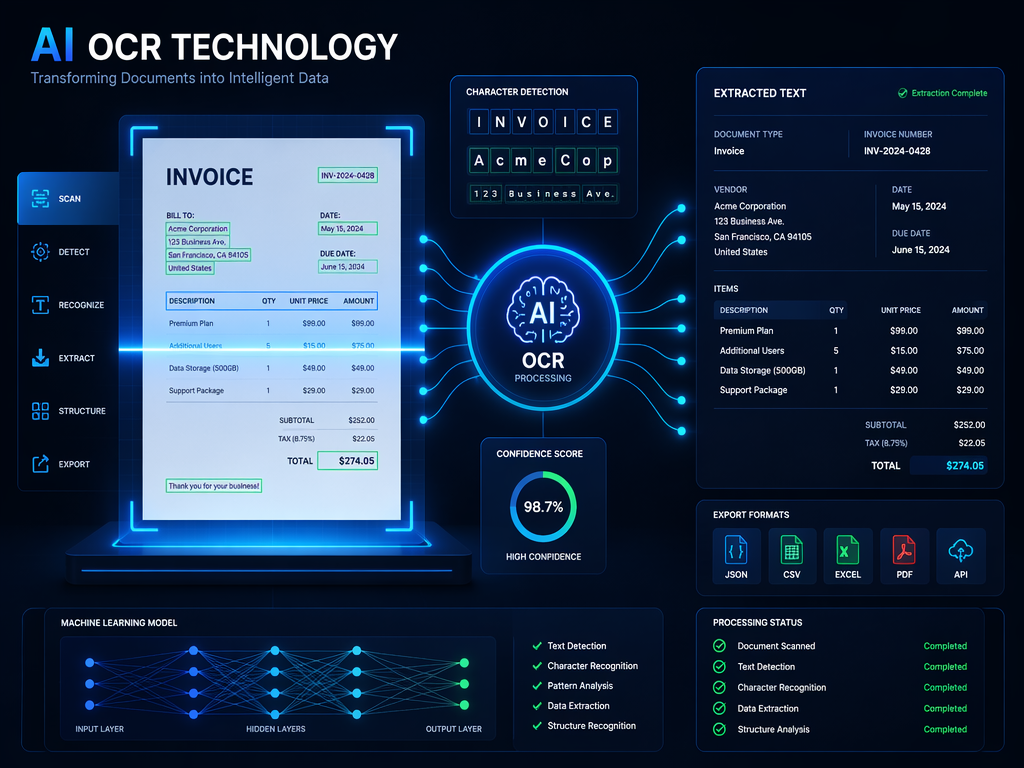
Az OCR az optikai karakterfelismerés rövidítése.
Az OCR-technológia azonosítja a képeken található betűket, számokat és szimbólumokat, majd szerkeszthető szöveggé alakítja őket.
A hagyományos OCR évtizedek óta létezik, de a modern, mesterséges intelligenciával működő OCR-rendszerek jelentősen fejlettebbek.
Az MI-alapú OCR képes:
- Több nyelv felismerésére
- A dokumentum szerkezetének felismerésére
- Táblázatok kinyerésére
- Címsorok azonosítására
- Kézzel írt tartalmak feldolgozására
- A felismerési hibák automatikus javítására
Az MI-modellek a karakterek egyszerű felismerése helyett megértik a dokumentumok kontextusát.
Ezért részesítik előnyben sokan az olyan megoldásokat, amelyek támogatják a PDF szöveggé alakítását MI-vel, ahelyett hogy hagyományos OCR-szoftverre támaszkodnának.
Hagyományos OCR és MI-alapú OCR
| Funkció | Hagyományos OCR | MI-alapú OCR |
|---|---|---|
| Karakterfelismerés | Jó | Kiváló |
| Kézírás támogatása | Korlátozott | Fejlett |
| Elrendezés megőrzése | Alapszintű | Erős |
| Táblázatok kinyerése | Gyenge | Pontos |
| Hibajavítás | Kézi | MI által támogatott |
| Többnyelvű támogatás | Közepes | Kiváló |
Hogyan alakítható át egy szkennelt PDF szöveggé OCR segítségével?
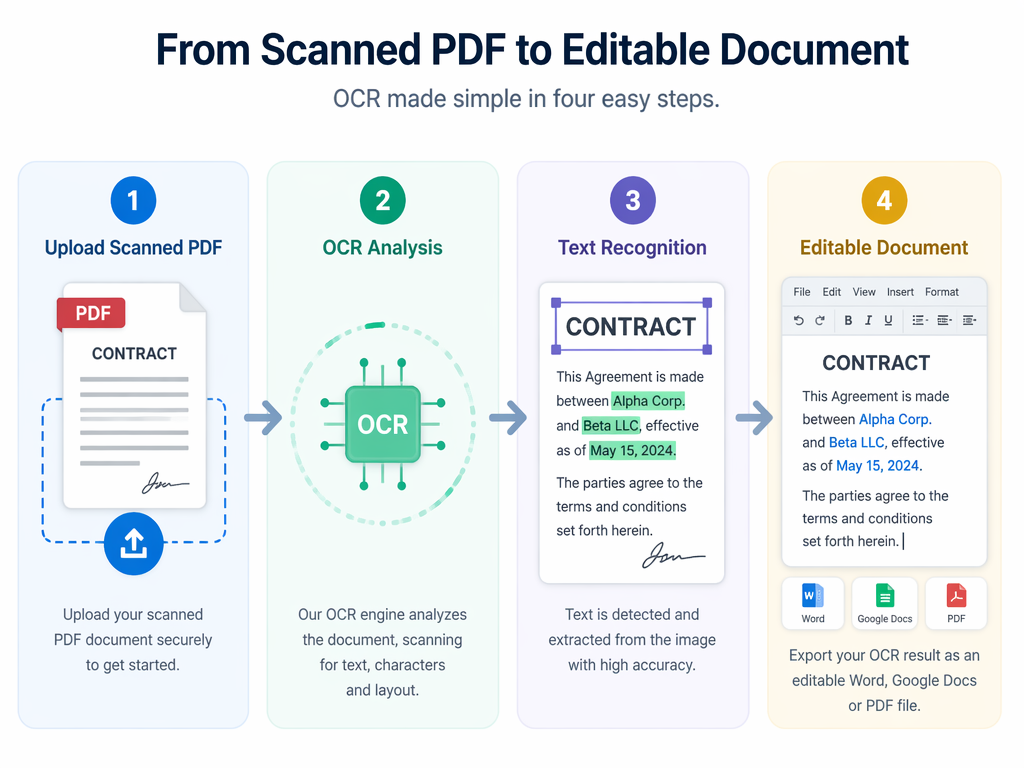
A szkennelt dokumentumok esetében a szöveg kinyerése előtt OCR-re van szükség.
Kövesse az alábbi lépéseket:
1. lépés: Töltse fel a PDF-et
Válasszon OCR-képes eszközt, például:
- Adobe Acrobat
- Google Drive OCR
- Microsoft OneDrive
- HiNoter
- ABBYY FineReader
2. lépés: Futtassa az OCR-feldolgozást
A szoftver minden oldalt átvizsgál, és azonosítja a szöveges elemeket.
Az OCR-motorok általában:
- Felismerik a karaktereket
- Újraalkotják a mondatokat
- Megőrzik a formázást
- Azonosítják a dokumentum szerkezetét
3. lépés: Ellenőrizze az eredményeket
Ellenőrizze:
- Neveket
- Dátumokat
- Számokat
- Táblázatokat
- Speciális formázást
Még a fejlett OCR-rendszerek is hibázhatnak időnként.
4. lépés: Exportálja a szöveget
A gyakori exportformátumok közé tartoznak:
- TXT
- DOCX
- Markdown
- HTML
Ezzel a PDF-fájl szöveggé alakítására szolgáló munkafolyamat befejeződött.
Hogyan alakíthatok át ingyen egy PDF-et szöveggé?
Sok felhasználónak csak alkalmanként van szüksége konvertálásra, és inkább nem fizetne speciális szoftverért.
Szerencsére több ingyenes megoldás is létezik.
Népszerű ingyenes módszerek
| Eszköz | Ingyenes verzió | OCR-támogatás |
|---|---|---|
| Google Dokumentumok | Igen | Alapszintű |
| Adobe online eszközök | Korlátozott | Igen |
| Microsoft OneDrive | Igen | Alapszintű |
| Tesseract OCR | Igen | Fejlett |
| HiNoter | Freemium | MI-alapú OCR |
Sok felhasználó egy online PDF-szövegkonvertáló eszközzel kezdi, mivel ehhez nincs szükség telepítésre, és közvetlenül a böngészőben működik.
Az ingyenes megoldások előnyei
- Nincs szükség szoftvertelepítésre
- Gyors beállítás
- Bármilyen eszközről elérhető
- Egyszerű feladatokra alkalmas
Korlátok
- Fájlméret-korlátozások
- Alacsonyabb OCR-pontosság
- Exportálási korlátozások
- Kevesebb MI-funkció
Nagy dokumentum-munkafolyamatok esetén a dedikált, mesterséges intelligenciával működő eszközök gyakran jelentősen jobb eredményeket biztosítanak.
Hogyan alakíthatok át egy PDF-et szöveggé?
A folyamat attól függ, hogy a PDF szövegalapú vagy szkennelt.
1. módszer: Meglévő szöveg másolása
Szövegalapú PDF-ek esetén:
- Nyissa meg a fájlt
- Jelölje ki a tartalmat
- Másolja ki a szöveget
- Illessze be egy dokumentumszerkesztőbe
2. módszer: OCR-konverzió
Szkennelt dokumentumok esetén:
- Töltse fel a PDF-et
- Engedélyezze az OCR-t
- Nyerje ki a szöveget
- Ellenőrizze az eredményeket
- Exportálja
3. módszer: Mesterséges intelligencián alapuló konverzió
A modern mesterségesintelligencia-eszközök képesek:
- Szöveget kinyerni
- Szakaszokat rendszerezni
- Összefoglalókat készíteni
- Azonosítani a legfontosabb felismeréseket
- Kereshető jegyzeteket létrehozni
Ez a megközelítés egyre népszerűbb a nagy mennyiségű dokumentumot kezelő szakemberek körében.
A legjobb PDF-szövegkonvertáló eszközök
A piac a PDF-konvertálási megoldások széles választékát kínálja.
Összehasonlító táblázat
| Eszköz | OCR-minőség | Mesterségesintelligencia-funkciók | Ingyenes csomag | Leginkább erre alkalmas |
|---|---|---|---|---|
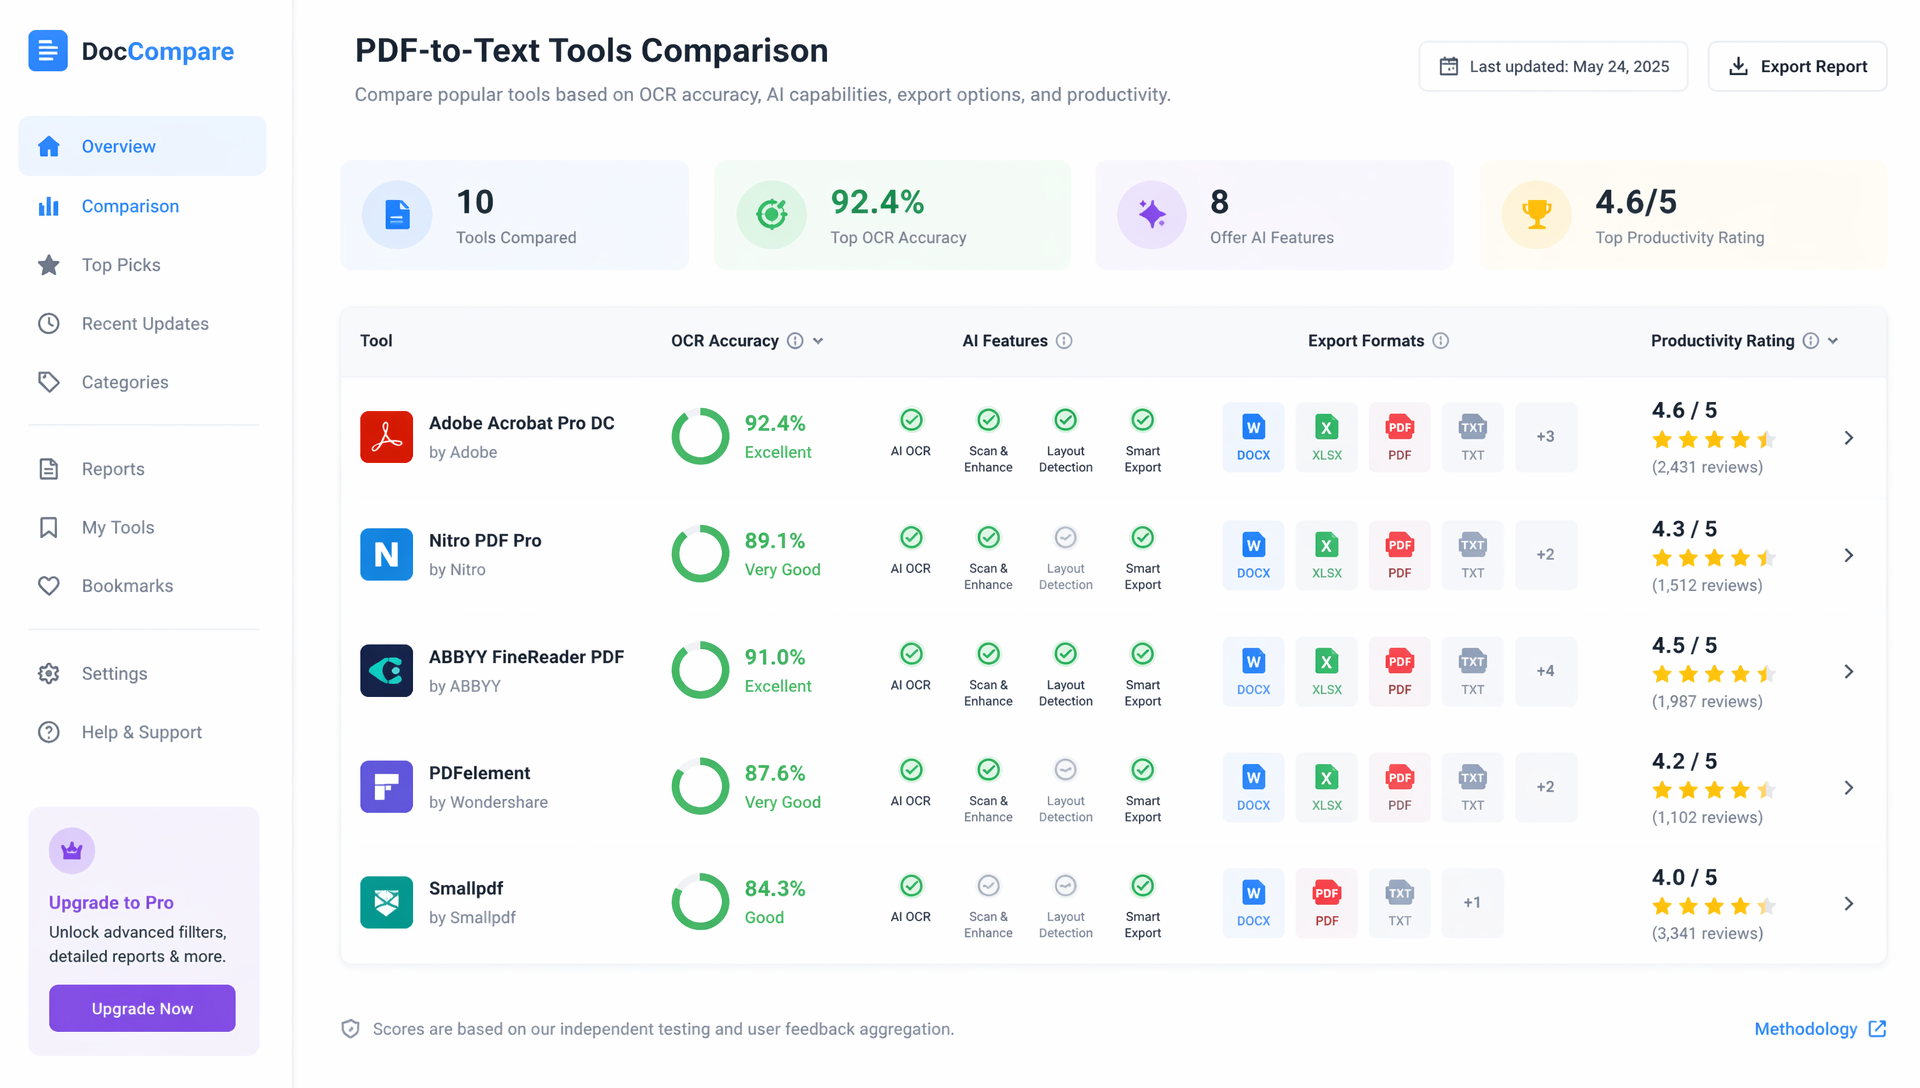
| HiNoter | Kiváló | Kiváló | Igen | Mesterséges intelligencián alapuló produktivitás |
| Adobe Acrobat | Kiváló | Jó | Korlátozott | Professzionális dokumentumok |
| Google Docs | Alapszintű | Nem | Igen | Alkalmi felhasználók |
| ABBYY FineReader | Kiváló | Közepes | Nem | Vállalati OCR |
| Microsoft OneDrive | Alapszintű | Nem | Igen | Microsoft-ökoszisztéma |
Mire érdemes figyelni?
Konvertáló választásakor vegye figyelembe:
- OCR-pontosság
- Támogatott nyelvek
- Exportálási lehetőségek
- Mesterségesintelligencia-képességek
- Adatvédelmi intézkedések
- Feldolgozási sebesség
Nem minden felhasználónak van szüksége vállalati szintű OCR-re, de a pontosság egyre fontosabbá válik szerződések, kutatási tanulmányok vagy üzleti dokumentumok kezelésekor.
Hogyan alakítja át a mesterséges intelligencia a dokumentumfeldolgozást?
A hagyományos konvertálók a kinyerésre összpontosítanak.
A modern mesterségesintelligencia-platformok a megértésre összpontosítanak.
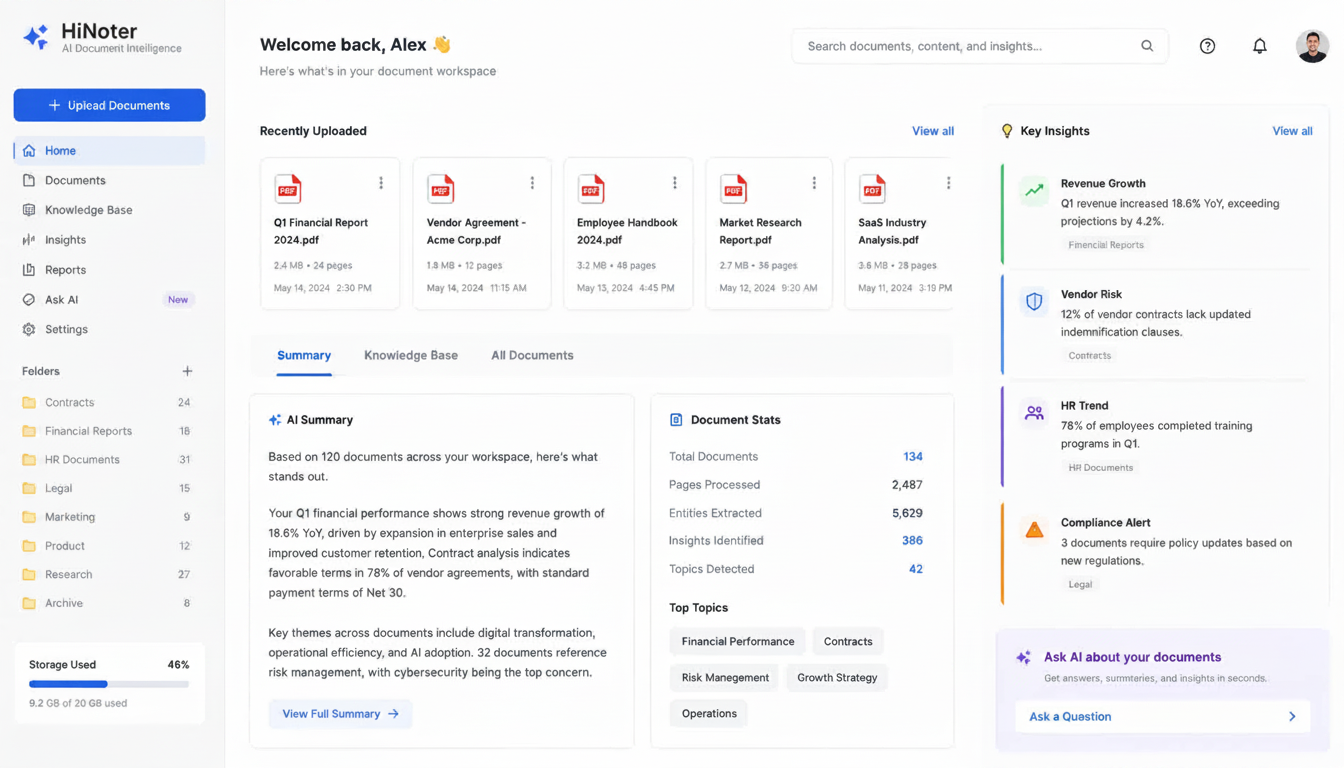
Ahelyett, hogy csupán segítenének a PDF szöveggé alakításában, a mesterségesintelligencia-rendszerek elemezhetik a dokumentumok tartalmát, és hasznosítható felismeréseket nyújthatnak.
Az OCR-en túlmutató mesterségesintelligencia-képességek
- Összefoglalás
- Főbb pontok kinyerése
- Kérdések megválaszolása
- Szemantikus keresés
- Jegyzetek létrehozása
- Tudás rendszerezése
Ez a fejlődés megváltoztatta azt, ahogyan a vállalkozások feldolgozzák az információkat.
Példa egy mesterségesintelligencia-munkafolyamatra
| Lépés | Mesterségesintelligencia-művelet |
|---|---|
| PDF feltöltése | A dokumentum struktúrájának elemzése |
| OCR | Szöveg kinyerése |
| Megértés | Témák és szakaszok azonosítása |
| Összefoglalás | Tömör áttekintések készítése |
| Keresés | Azonnali visszakeresés engedélyezése |
Ezért folyamatosan nő az érdeklődés a PDF szöveggé alakítására szolgáló mesterségesintelligencia-megoldások iránt az oktatás, a kutatás és az üzleti szektor területén.
Gyakori kihívások a PDF-konvertálás során
Még a legjobb eszközök is találkoznak kihívásokkal.
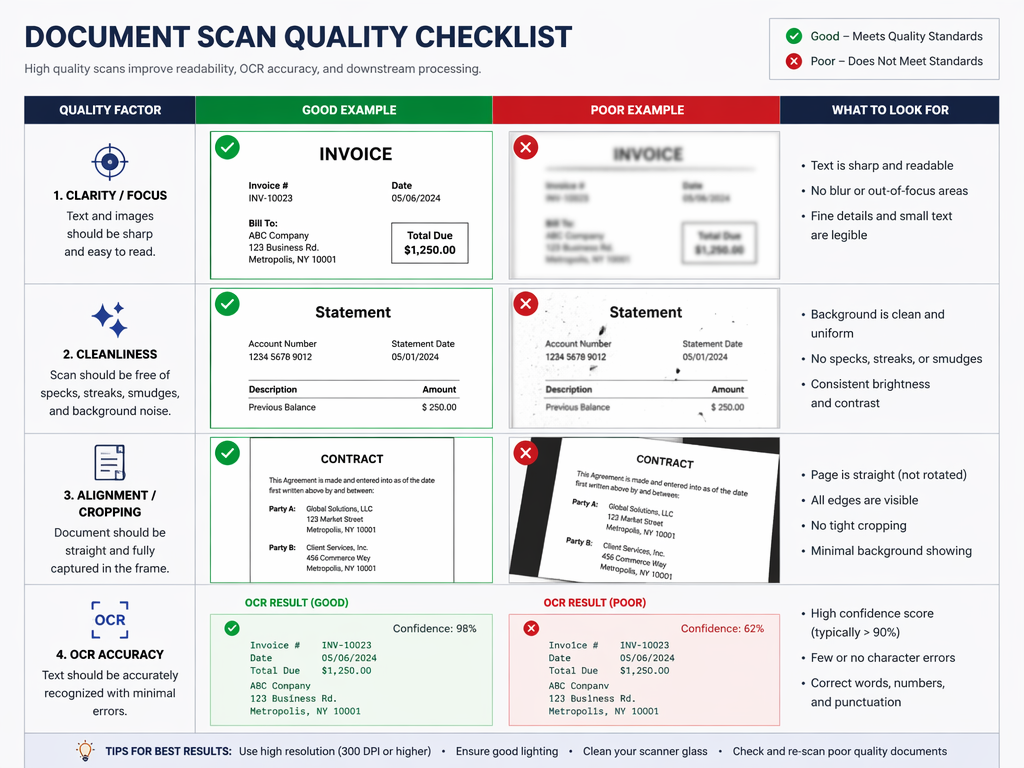
Gyenge szkennelési minőség
Az alacsony felbontású szkennelések csökkentik az OCR pontosságát.
Összetett elrendezések
Az alábbiakat tartalmazó dokumentumok:
- Táblázatok
- Többhasábos elrendezések
- Diagramok
- Vegyes média
nehezebben dolgozhatók fel.
Kézzel írt tartalom
A kézírás-felismerés folyamatosan fejlődik, de továbbra is nagyobb kihívást jelent, mint a gépelt szöveg felismerése.
Több nyelv
Egyes OCR-motorok nehezen kezelik a többnyelvű dokumentumokat.
Egy kiváló minőségű OCR-platform választása jelentősen javítja az eredményeket.
Vissza lehet alakítani a szöveget PDF-fé?
Érdekes módon sok felhasználónak, aki információt nyer ki, később újra PDF-dokumentumokat kell létrehoznia.
Ilyenkor válnak hasznossá az ingyenes online szöveg-PDF konvertáló eszközök.
A legtöbb dokumentumszerkesztő lehetővé teszi a felhasználók számára, hogy:
- Szöveges dokumentumokat hozzanak létre vagy szerkesszenek
- Formázzák a tartalmat
- Közvetlenül PDF-ként exportálják
A népszerű lehetőségek közé tartoznak:
- Google Docs
- Microsoft Word
- Canva
- Adobe Acrobat
- Online PDF-generátorok
Ez megkönnyíti a szerkeszthető szöveg és a PDF-formátum közötti váltást, a munkafolyamat igényeitől függően.
Bevált módszerek a pontos eredményekért
A PDF-konvertálás minőségének javítása érdekében:
Feltöltés előtt
- Használjon nagy felbontású szkenneléseket
- Győződjön meg róla, hogy az oldalak megfelelően vannak igazítva
- Kerülje az árnyékokat és a tükröződést
- Jó megvilágítás mellett szkenneljen
A kinyerés után
- Ellenőrizze a neveket és a dátumokat
- Ellenőrizze a numerikus értékeket
- Gondosan tekintse át a táblázatokat
- Hasonlítsa össze az eredeti fájlokkal
Az apró ellenőrzési lépések jelentősen javíthatják a pontosságot.
Gyakran ismételt kérdések
Hogyan alakíthatok át ingyen egy PDF-et szöveggé?
Használhatja a Google Docsot, a Microsoft OneDrive OCR-funkcióját, az Adobe online eszközeit vagy freemium mesterségesintelligencia-platformokat. Ezek a lehetőségek lehetővé teszik a felhasználók számára, hogy szoftvervásárlás nélkül nyerjenek ki szöveget.
Mi az OCR a mesterséges intelligenciában?
Az OCR (optikai karakterfelismerés) olyan technológia, amely a képekben található szöveget szerkeszthető tartalommá alakítja. A mesterséges intelligencián alapuló OCR a dokumentum struktúrájának és kontextusának megértésével javítja a pontosságot.
Hogyan alakítható át egy szkennelt PDF szöveggé OCR segítségével?
Töltse fel a szkennelt fájlt egy OCR-kompatibilis eszközbe, dolgozza fel a dokumentumot, ellenőrizze a kinyert tartalmat, majd exportálja a szöveget a kívánt formátumban.
Melyik a legjobb PDF-szövegkonvertáló?
A legjobb megoldás az igényektől függ. Alapfeladatokhoz elegendőek lehetnek az ingyenes OCR-eszközök. A fejlett dokumentumértelmezéshez az olyan mesterségesintelligencia-platformok, mint a HiNoter , egyetlen munkafolyamatban biztosítanak OCR-t, összefoglalókat és kereshető tudáskezelést.
Hogyan alakíthatok át egy PDF-et szöveggé?
Szövegalapú PDF-ek esetén egyszerűen másolja ki közvetlenül a tartalmat. Szkennelt PDF-ek esetén használjon OCR-szoftvert vagy mesterséges intelligencián alapuló dokumentumfeldolgozó eszközöket szerkeszthető szöveg kinyeréséhez.
Záró gondolatok
A PDF-ek továbbra is a modern munkafolyamatok egyik legfontosabb dokumentumformátumát jelentik, de az értékes információ gyakran statikus fájlokba zárva marad.
A PDF szöveggé alakításának lehetősége megkönnyíti a dokumentumok szerkesztését, elemzését, keresését és rendszerezését. Legyen szó szerződések, tudományos dolgozatok, üzleti jelentések vagy szkennelt archívumok feldolgozásáról, a megfelelő konvertálási módszer kiválasztása jelentős időt és energiát takaríthat meg.
Ahogy a mesterséges intelligencia folyamatosan fejleszti az OCR-t és a dokumentumok értelmezését, a PDF-feldolgozás jövője az egyszerű kinyerésen túl az intelligens tudáskezelés felé mozdul el. A modern eszközök ma már képesek a PDF-eket kereshető, hasznosítható információvá alakítani — így a felhasználók gyorsabban dolgozhatnak, és minden dokumentumból nagyobb értéket nyerhetnek.